关注并标星 3分钟秒懂大数据
每天1次,打卡阅读
更快更全面获取大数据技术博客

1、Spark 简介


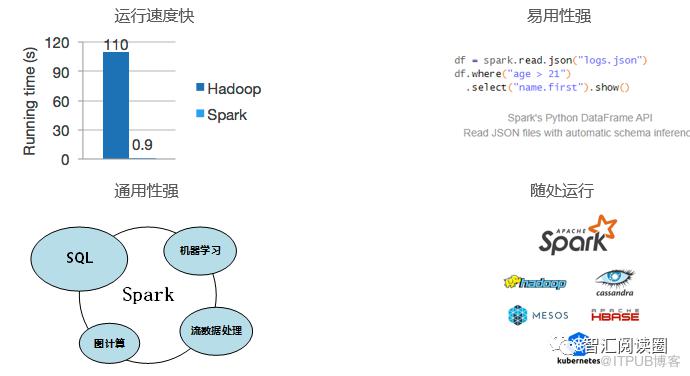
4.随处运行:Spark具有很强的适应性,能够读取HDFS、Cassandra、HBase、S3和Techyon为持久层读写原生数据,能够以Mesos、YARN和自身携带的Standalone作为资源管理器调度job,来完成Spark应用程序的计算。

Spark 模块划分:
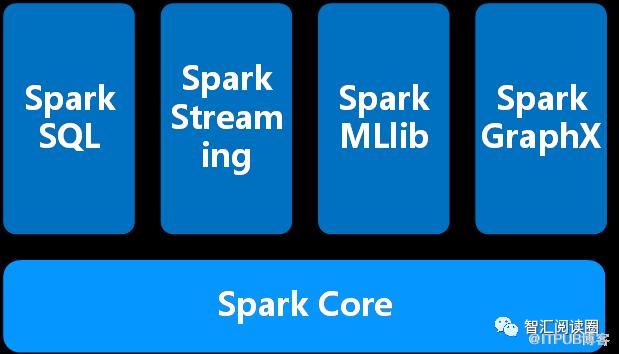

Spark基础模块:Spark-Core;


2、Spark 架构


Spark 架构主要由以下几部分组成:
服务架构集群和资源管理 Master / Yarn Application Master
工作节点 Work / Node Manager
任务调度器 Driver
任务执行器 Executor

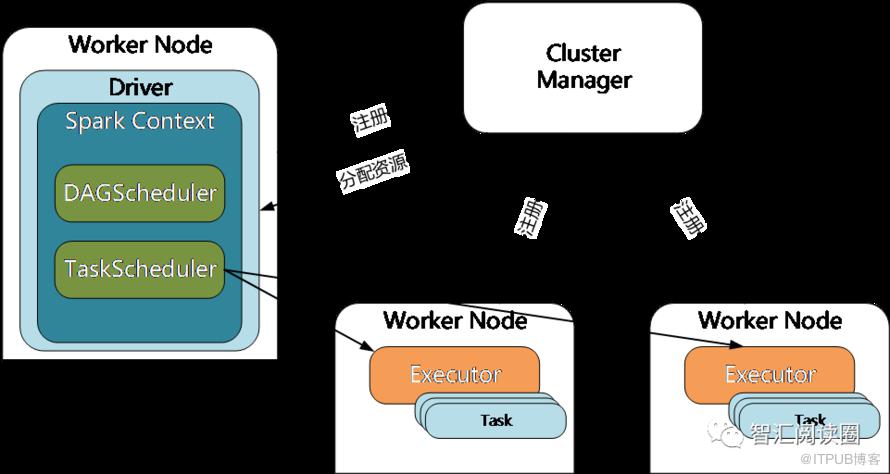
架构图

运行原理如下:
1、Spark 集群启动后,Work向Master注册信息;
2、Spark-submit命令提交程序后,Driver和Application也会向Master注册信息;
3、创建SparkContext对象,主要是包含DAGScheduler和TaskScheduler;
4、Driver把Application信息注册给 Maste后,Master会根据App信息去Work 节点启动Executor
5、Executor内部会创建运行task的线程池,然后把启动的Executor反向注册给Dirver;
6、DAGScheduler:负责把Spark作业转换成 DAG(有向无环图),根据宽窄依赖切分Stage,然后把 TaskSet的形式发送个给TaskScheduler, DAGScheduler还会处理由于Shuffle数据丢失导致的失败;
7、TaskScheduler:维护所有 Task,分发Task给各个节点的Executor(根据数据本地化策略分发)监控task的运行状态,负责重试失败的task;
8、所有task运行完成后,SparkContext 向Master注销,释放资源。


End

找各类大数据技术文章,就来
<3分钟秒懂大数据>
随时更新互联网大数据组件内容
专为学习者提供技术博文
快和身边的小伙伴一起关注我们吧!
原文作者:3分钟秒懂大数据;如有侵权,请联系管理员删除。

最新文章
- 大数据面试,被问到频率最高的三道考题,值得一看~
- 工作中常用的50+ Linux 命令,建议收藏~
- 字节面试sql题:有一张工资表,字段分别是:员工工号、部门、工资。要求各部门除去最高工资和最低工资后的平均工资
- 一篇忍不住看很多遍的数据建模理论与实践(7000字+25张图)
- 网易云音乐P0级事故!官方回应:未删库,未跑路!
- 我发现很多计算机专业的学生都长期处于迷茫中...
- 离职流程都走完了,领导又分了一个新任务让我要么工作日加班,要么周末加班,两周搞完...
- HR最认可的5个离职原因:1、个人发展空间受限;2、公司组织结构变化;3、工作内容与职业发展不匹配...
- 月薪4.5w,离职后每月只补偿2590元,违约就要赔100万!
- 这是雷军的简历,落魄时卡里只有冰冷的40亿...
