关注并标星 3分钟秒懂大数据
每天1次,打卡阅读
更快更全面获取大数据技术博客
Ray Streaming 源码分析
在源码分析环节,将从一个具体示例入手,来探索RayStreaming 的内核实现,主要涉及的知识点如下:
•Ray Streaming 源码编译
•生成 JobGraph
•优化 JobGraph
•Master Actor 的启动流程
•Worker Actor 的启动流程
为了更方便的调试RayStreaming 源码,需要对Ray 和 Ray Streaming 的源码进行编译:
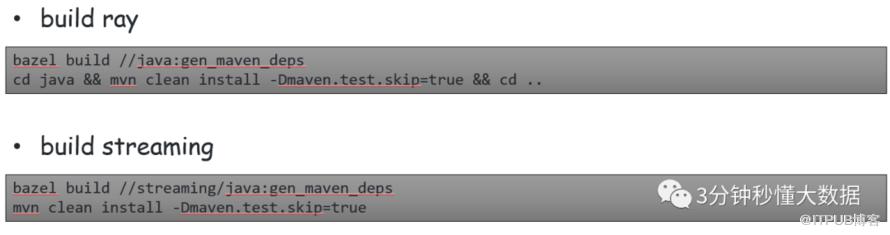
注:编译源码前,需要先安装好 bazel、maven。bazel是 Google 的自动化构建工具,支持多种语言混编的项目,对 C++ 支持较为完善
使用RayStreaming 实现一个workcount,代码编写如下:

各算子之间的关系如下:
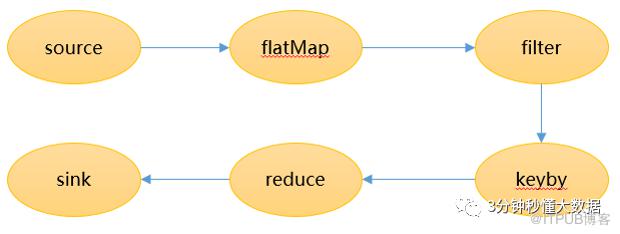
当执行streamingContext.execute() 时,上述算子会转换成JobGraph。

生成JobGraph
RayStreaming 会从 Sink 开始反向遍历算子链来生成JobGraph,跟踪代码,可发现核心实现位于 JobGraphBuilder中,代码调用栈如下:
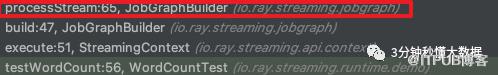
processStream方法负责生成JobGraph的点和边,会针对算子类型做不同的处理,下面代码是处理StreamSink的逻辑:

会先将sinkoperator包装成 JobVertex,然后获取上游输入算子,并创建连接二者的 JobEdge,创建 JobEdge时会指定二者之间的分区策略。
接下来递归调用processStream来处理上游算子,对于普通的算子,会转换为TRANSFORMATION类型的点,对于Source会转换为 SOURCE 类型的点,最终 JobGraph可表示如下:

优化JobGraph
上一篇文章介绍过 RayStreaming也是支持 Operator Chain的,生成 JobGraph的过程并没有体现这一点,跟踪代码,可发现该逻辑位于JobGraphOptimizer 中,代码调用栈如下:

•上游 JobVertex的输出边,下游 JobVertex的输入边为 1;
•上下游 JobVertex的并行度相同;
•上游 JobVertex的连接策略不为 NEVER,下游 JobVertex的连接策略为 Always;
•上下游 JobVertex的编程语言相同;
•上下游 JobVertex之间的分区策略为 ForwardPartition;
优化后的JobGraph可表示如下:

启动 Master Actor
得到优化后的JobGraph之后,接下来就是创建MasterActor 来提交 JobGraph了,启动Master的代码位于JobClientImpl#submit方法中:
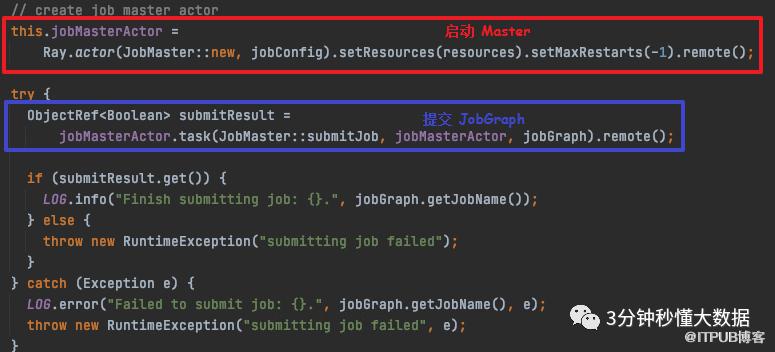
从上述代码可以看出,submit 方法直接调用了 Ray 的API 启动了 Master Actor,并且 Master Actor 的核心类是 JobMaster。之后,通过 Ray Actor 的方法调用,让 Master Actor 去提交 JobGraph。
启动 Worker Actor
接下来看JobMaster#submit方法,和 Flink 一样,会先将 JobGraph转换为ExecutionGraph,然后创建作业调度器去调度 ExecutionGraph,如下图。
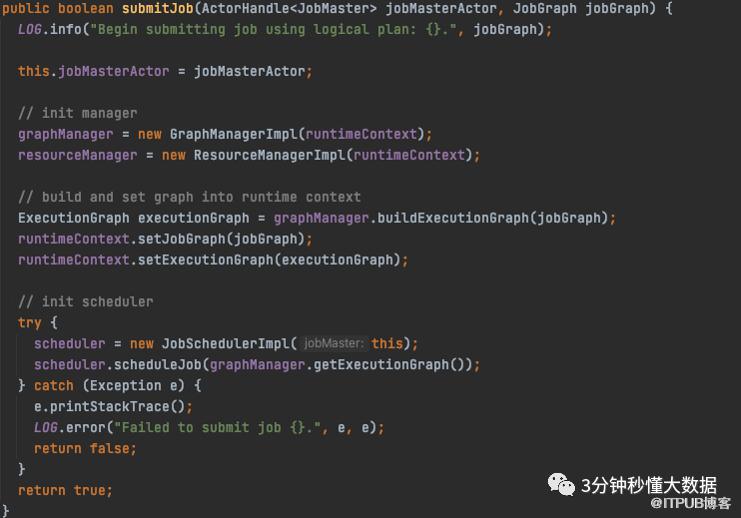
关于ExecutionGraph的生成,此处不做介绍(位于GraphManagerImpl#buildExecutionGraph中),下面来分析下JobMaster是如何调度作业的,如下图:
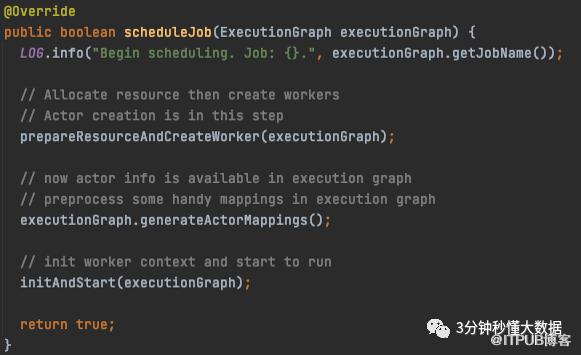
在JobSchedulerImpl#submit方法中,第一步就会根据物理执行计划中的点来创建WorkerActor,跟进 prepareResourceAndCreateWorker方法,可确定最终启动Worker的代码位于WorkerLifecycleController#createWorker方法中,如下图:
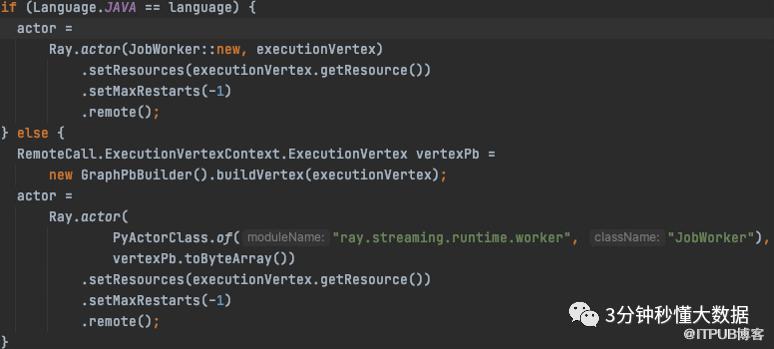
可以看到,根据编程语言的不同,Worker Actor 使用了不同的核心类,对 Java 来说,核心类是JobWorker。
到现在已经完成了WorkerActor 的启动,实际其内部的作业并未运行,最终启动Worker内作业的代码位于WorkerLifecycleController#startWorkers中,代码如下:
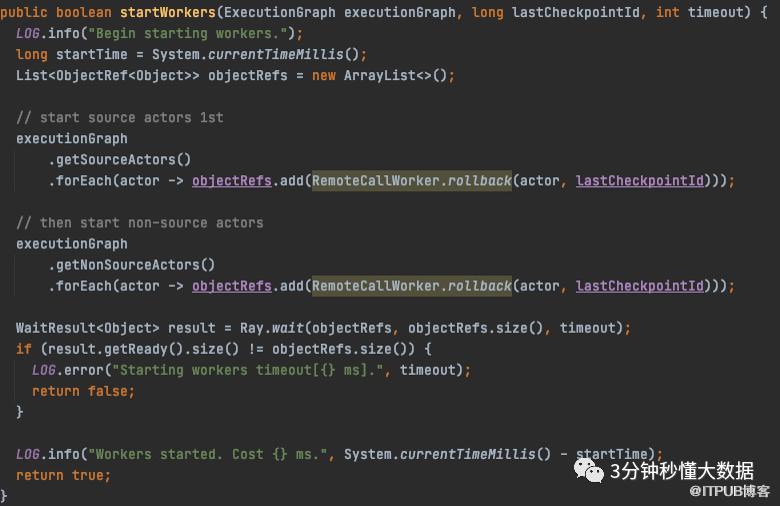
因为之前已经完成了ExecutionVertex与Actor的关联,所以可以直接通过ExecutionGraph获取到相应的WorkerActor,并通过 Actor 的方法调用来启动作业。此处会先去启动 source 作业,然后再启动其他作业,在执行 RemoteCallWorker#rollback方法时,最终调用的是JobWorker#rollback:
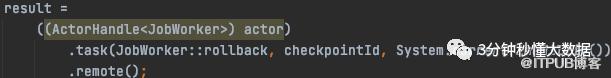
而在JobWorker#rollback内部,则会将 ExecutionVertex封装为StreamTask并运行起来。
至此,Ray Streaming 运行wordcount的全部源码分析就到此结束!
Ray Streaming VS Flink
RayStreaming 相对于 Flink 的优势是什么?
•依托于 Ray Core,注定比 Flink 更适合于 AI 组件相结合
•在 Flink 的基础之上设计开发,可规避 Flink 中的一些问题,如支持单点重启的故障恢复机制
•对 python 语言有更好的支持
RayStreaming 相对于 Flink 的劣势是什么?
•处于发展初期,社区关注度不高•在数据处理领域的生态不够完善,缺少一些易用的API,如 Table API & SQL
•功能没有经过大量的生产环境验证

End
找各类大数据技术文章,就来
<3分钟秒懂大数据>
随时更新互联网大数据组件内容
专为学习者提供技术博文
快和身边的小伙伴一起关注我们吧!
作者简介:逆流而上Mr李,秋招7offer,CSDN博客:https://blog.csdn.net/weixin_38201936
原文作者:3分钟秒懂大数据;如有侵权,请联系管理员删除。

最新文章
- 大数据面试,被问到频率最高的三道考题,值得一看~
- 工作中常用的50+ Linux 命令,建议收藏~
- 字节面试sql题:有一张工资表,字段分别是:员工工号、部门、工资。要求各部门除去最高工资和最低工资后的平均工资
- 一篇忍不住看很多遍的数据建模理论与实践(7000字+25张图)
- 网易云音乐P0级事故!官方回应:未删库,未跑路!
- 我发现很多计算机专业的学生都长期处于迷茫中...
- 离职流程都走完了,领导又分了一个新任务让我要么工作日加班,要么周末加班,两周搞完...
- HR最认可的5个离职原因:1、个人发展空间受限;2、公司组织结构变化;3、工作内容与职业发展不匹配...
- 月薪4.5w,离职后每月只补偿2590元,违约就要赔100万!
- 这是雷军的简历,落魄时卡里只有冰冷的40亿...
