关注并标星 3分钟秒懂大数据
每天1次,打卡阅读
更快更全面获取大数据技术博客

Spark-Core 基本原理
1、RDD介绍
Spark的核心是建立在统一的弹性分布式数据集(Resilient Distributed Datasets,RDD)之上的,这使得Spark的各个组件可以无缝的进行集成,能够在同一个应用程序中完成大数据处理。
RDD实际上是对一个分布式数据集的抽象,从物理存储上看,一个数据集可能被分为多个分区,各个分区都有可能存放在不同的存储/计算节点上,而RDD则是在该数据集上的一个抽象,代表了整个数据集,但这个RDD并不会从物理上将数据放在一起。
有了RDD这个抽象,用户可以从一个入口方便的操作一个分布式的数据集。
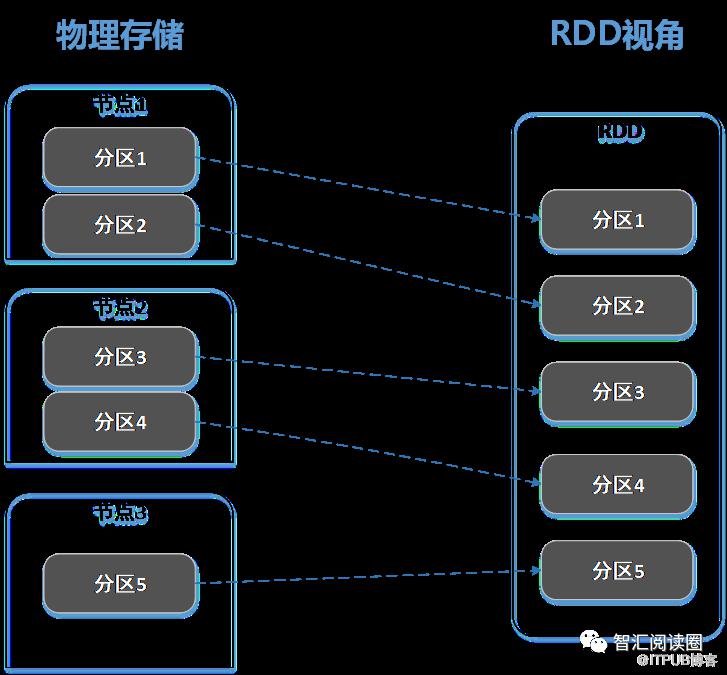
RDD 具有容错机制,并且只读不能修改,可以执行确定的转换操作创建新的 RDD。
2、RDD基本操作
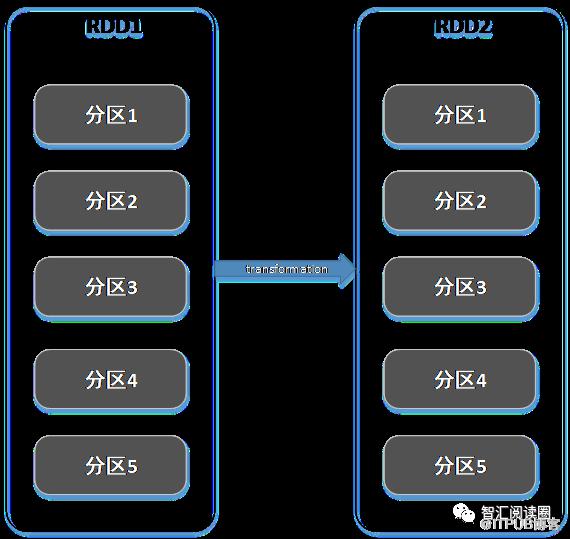
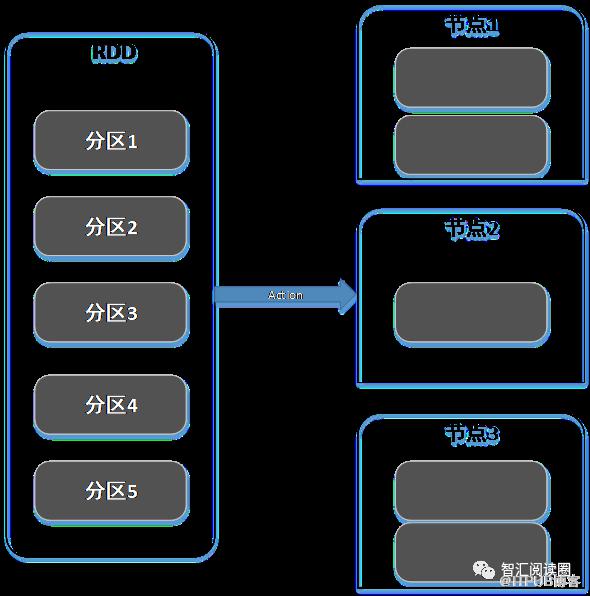
RDD提供了大量的API给用户使用,主要分为两大类:transformation和action。
(1) Transformation用于RDD的变形(RDD具有不可变性),每次transformation都将产
生新的RDD;
(2)Action通常用于结果的汇总或输出;
3、dependency 介绍
在DAG图中,RDD与RDD之间的连线称为依赖关系(dependency)
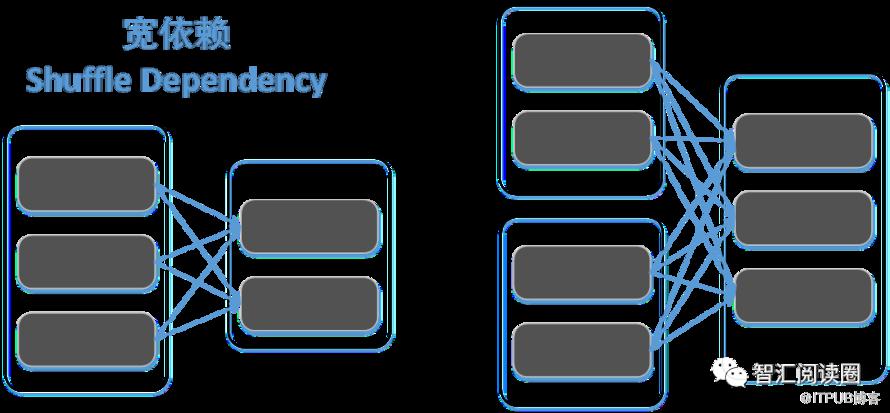
而依赖关系又分为窄依赖(Narrow Dependency)和宽依赖(Shuffle Dependency)
(1)在窄依赖中,父RDD的每一个partition,只会被子RDD的一个partition依赖
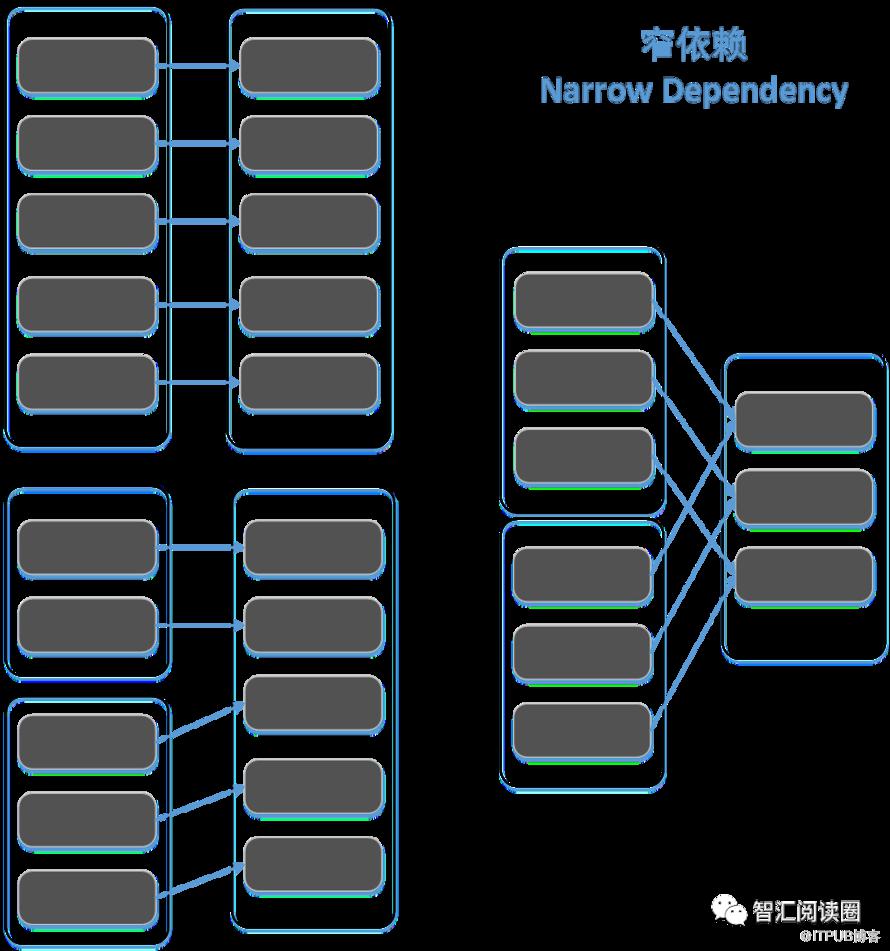
(2)在宽依赖中,父RDD的一个partition,会被子RDD的多个partition依赖
在Spark中每次action才会触发真正的计算,而transformation仅仅记录计算步骤,并不实际计算。将每次action触发的计算称为:Job
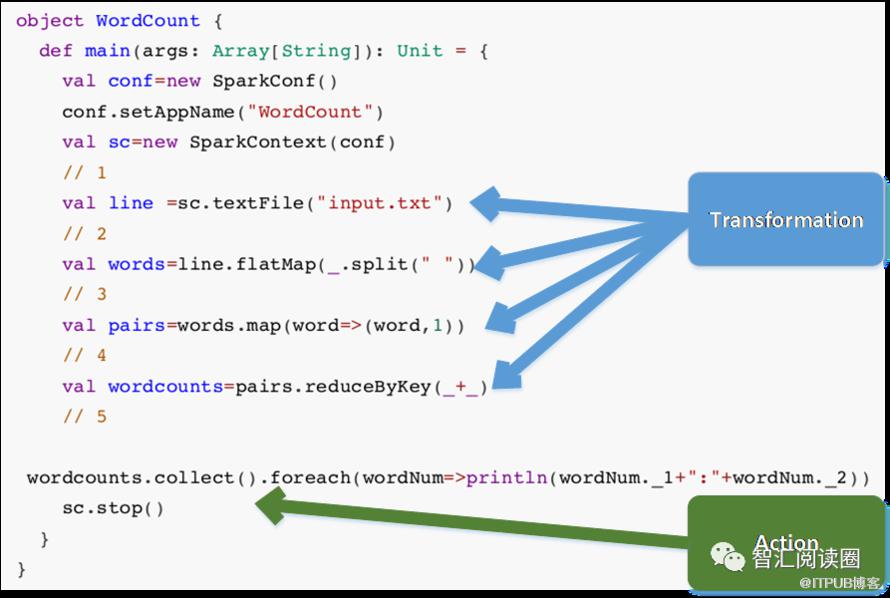
每次transformation都将生成一个新的RDD,而action可以看做是Job的输出
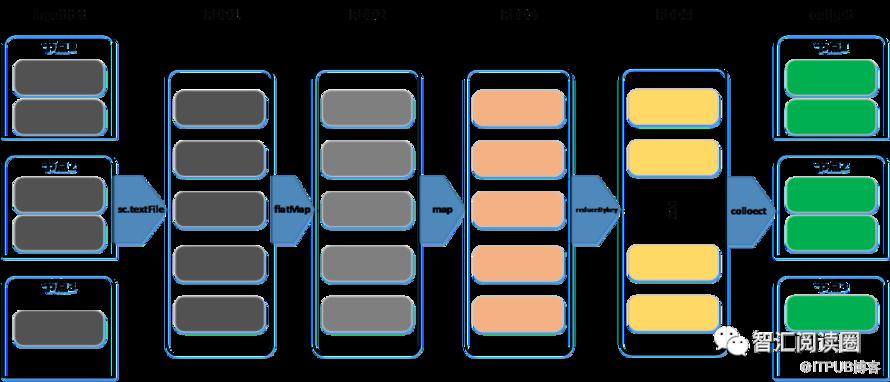
Spark中的每一个Job,都可以看做是RDD经过多次变形然后输出的过程
RDD变形的过程中将会生成多个新的RDD,形成一个由RDD构成的执行流程图(DAG)
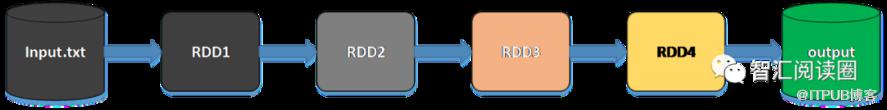
5、Stage介绍
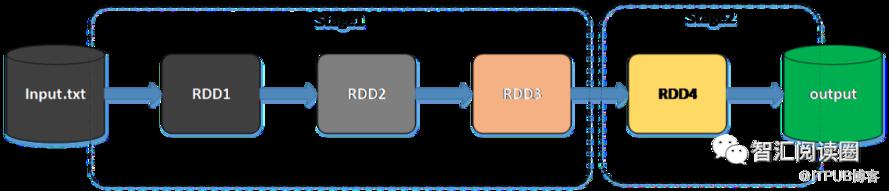
Spark在调度DAG时,并不是直接依次执行每一个节点的操作,而是将整个DAG划分为不同的Stage

调度时,将从最后一个Stage开始提交,如果该Stage的父Stage没有完成,则再递归提交其父Stage,直到没有父Stage或所有父Stage已完成
6、Shuffle介绍
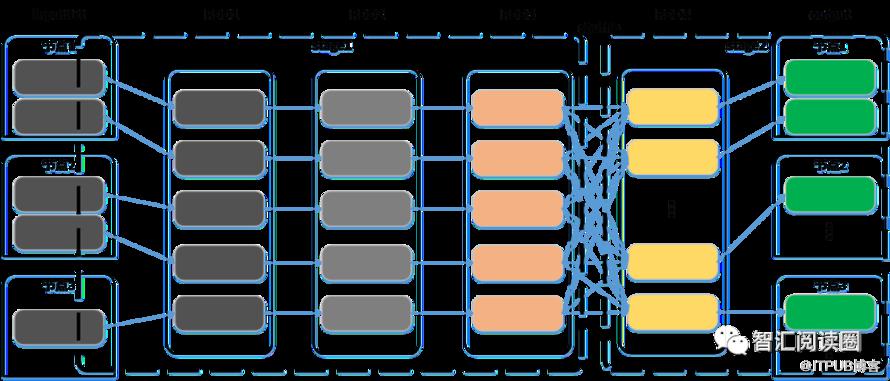
Spark在划分stage时,每遇到一个宽依赖,便划出一个新的stage,因为每当遇到宽依赖,必须进行一次“数据洗牌”操作(shuffle)

Shuffle发生时(宽依赖)
-从RDD视角看,是父分区不同key的数据分发到了子分区去,父分区有不同的key所以有不同的子分区依赖它
- 从物理视角看,不同的分区分布在不同的节点上,这种情况下需要将数据从一个节点移动到另一个节点上,发生了数据移动;
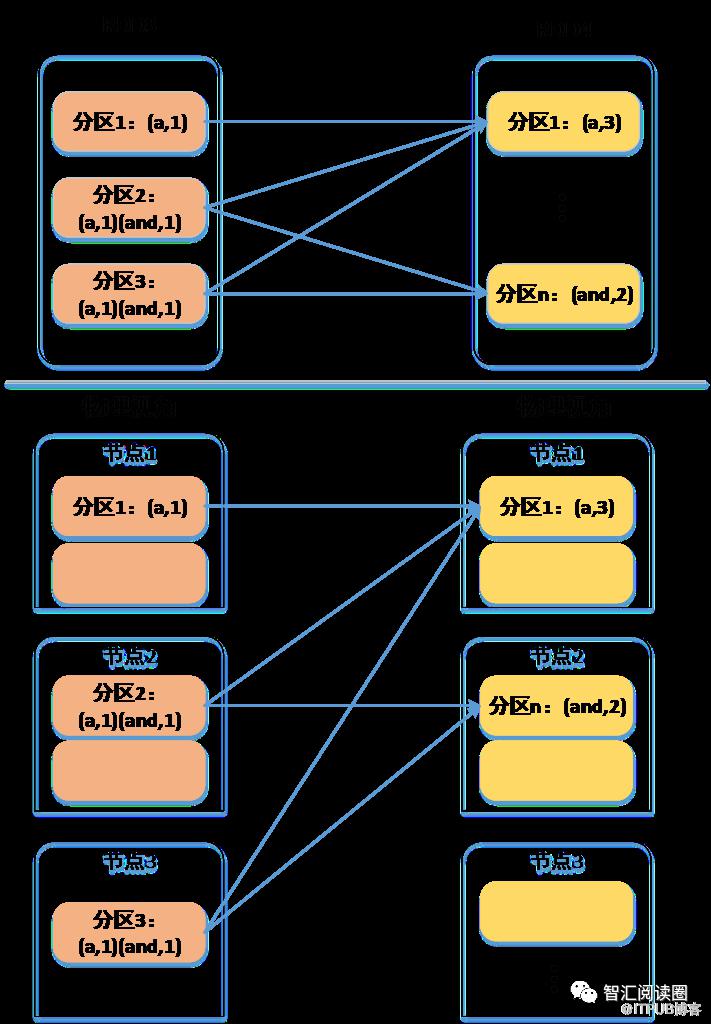
Shuffle过程将DAG划分为若干Stage,使得Spark在调度时,可以以Stage的粒度进行调度
这样的调度模式, 可以让同一个Stage在同一个计算节点上连续进行,Stage内部能够在内存中交换数据进行高效的计算,而Stage之间则通过Shuffle交换数据。
另一方面,Spark通过将计算抽象为task,以统一的api,实现了对RDD数据的不同操作以及shuffle过程。
7、Task介绍
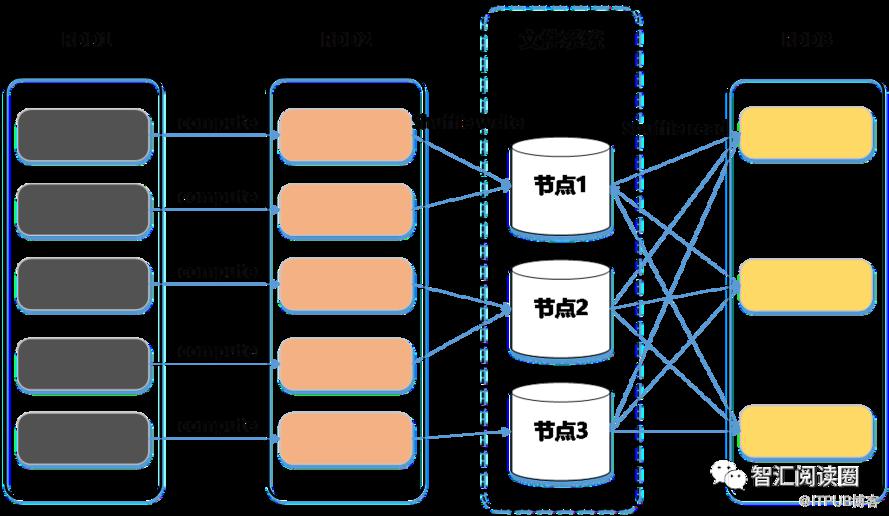
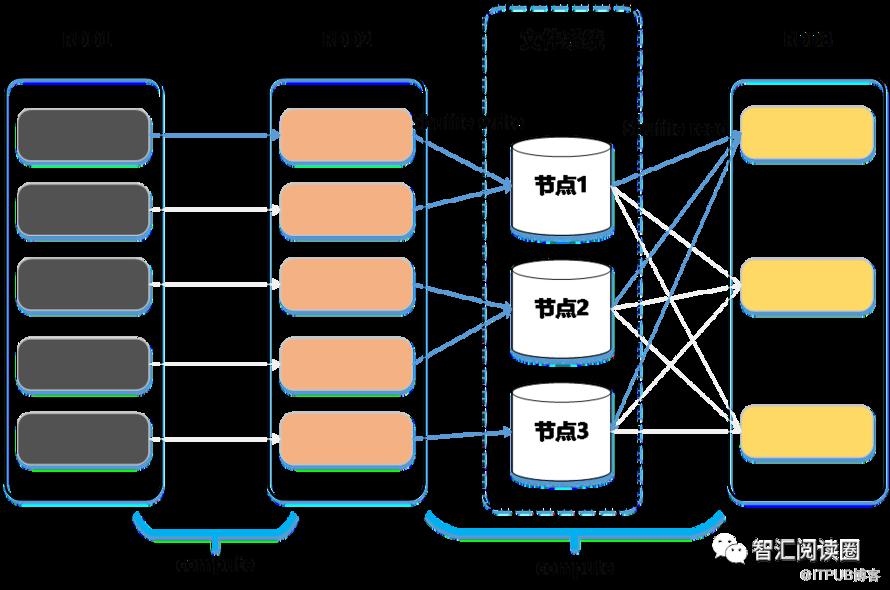
真正的计算发生在Executor中执行的Task, 每个Task只负责一个partition的计算,每个RDD都必须实现compute方法,该方法定义了如何计算得到单个partition。
图一
图二
(1)Task的执行
由多个RDD的compute方法组成了整个计算链条,在shuffle时,父RDD的compute方法将完成shuffle write操作,子RDD的compute方法将完成shuffle read操作,二者合作完成了shuffle操作
这样Spark就通过RDD上统一的compute方法,完成了整个计算链条。

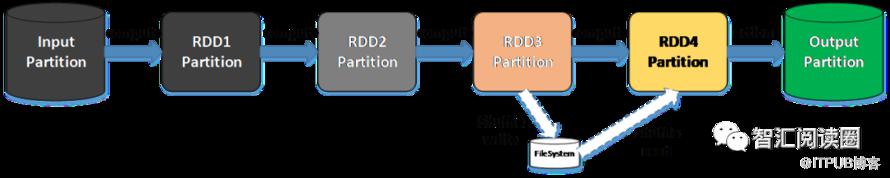
横向视角-partition的计算

图一
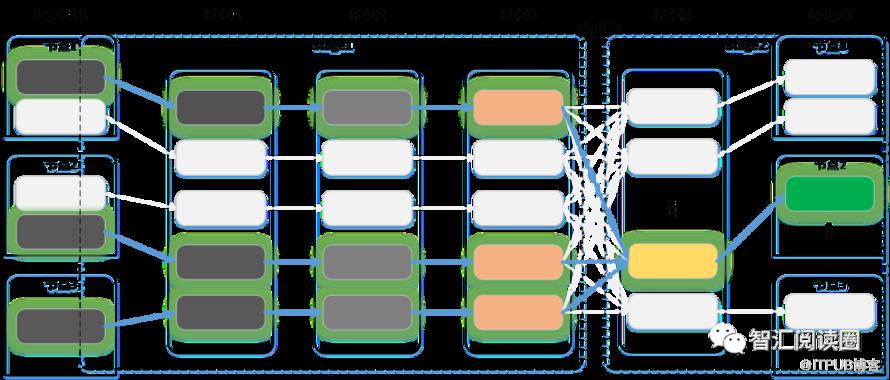
图二
原理总结:
纵向看,每一个计算过程,都将形成一个RDD,所有RDD以及依赖关系组成了DAG,Shuffle过程将DAG划分为一个一个的Stage
横向的看,每一个partition数据的计算,是由其依赖上一个RDD(或文件)的对应partition作为输入数据进行计算的,整个数据计算过程,每个partition与其依赖构成了整个计算链条
- 横向视角提供了RDD统一的高级抽象特性,用户可以不用关心是否有shuffle这类操作,仅需要关心RDD的数据变换,大大简化了编程模型
- 纵向视角提供了stage级别的调度,使得统一stage内的所有计算都不需要落盘,大大提升了计算速度

End
找各类大数据技术文章,就来
<3分钟秒懂大数据>
随时更新互联网大数据组件内容
专为学习者提供技术博文
快和身边的小伙伴一起关注我们吧!
原文作者:3分钟秒懂大数据;如有侵权,请联系管理员删除。

最新文章
- 大数据面试,被问到频率最高的三道考题,值得一看~
- 工作中常用的50+ Linux 命令,建议收藏~
- 字节面试sql题:有一张工资表,字段分别是:员工工号、部门、工资。要求各部门除去最高工资和最低工资后的平均工资
- 一篇忍不住看很多遍的数据建模理论与实践(7000字+25张图)
- 网易云音乐P0级事故!官方回应:未删库,未跑路!
- 我发现很多计算机专业的学生都长期处于迷茫中...
- 离职流程都走完了,领导又分了一个新任务让我要么工作日加班,要么周末加班,两周搞完...
- HR最认可的5个离职原因:1、个人发展空间受限;2、公司组织结构变化;3、工作内容与职业发展不匹配...
- 月薪4.5w,离职后每月只补偿2590元,违约就要赔100万!
- 这是雷军的简历,落魄时卡里只有冰冷的40亿...
