关注并标星 3分钟秒懂大数据
每天1次,打卡阅读
更快更全面获取大数据技术博客
1、引入xgboost_ray的原因
XGBoost是陈天奇等人开发的一个开源机器学习项目,高效地实现了GBDT算法并进行了算法和工程上的许多改进,被广泛应用在Kaggle竞赛及其他许多机器学习竞赛中并取得了不错的成绩。
说到XGBoost,不得不提GBDT(Gradient Boosting Decision Tree)。因为XGBoost本质上还是一个GBDT,但是力争把速度和效率发挥到极致,所以叫X (Extreme) GBoosted,两者都是boosting方法。
1.2、为什么使用分布式的xgboost?
•单机进行xgboost训练和预测无法满足大数据量的需求
•单机不支持多GPU加速训练
1.3、当前分布式xgboost有哪些?
•基于spark、Dask、kubernetes
1.4、当前分布式xgboost的不足?
•动态计算图
•容错处理
•多GPU支持
•与超参数集成
1.5、xgboost_ray能做什么?
•每个Ray actors是有状态训练的workers
•容错机制好
•多GPU支持
•支持分布式数据加载
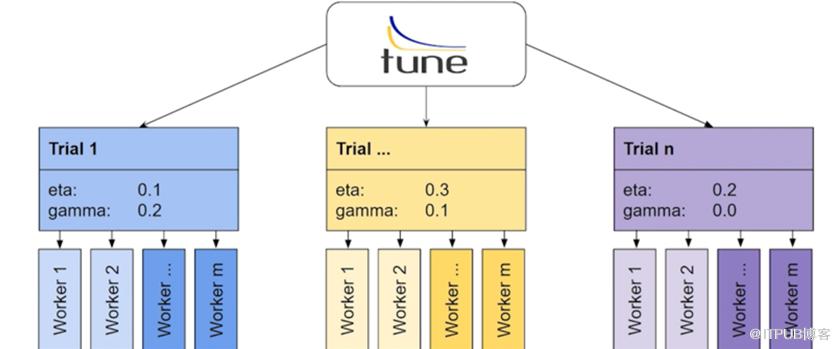
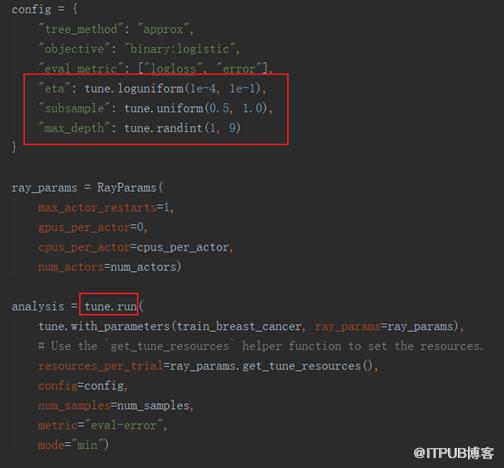
•与分布式超参数优化ray tune的集成
2、xgboost_ray的架构
2.1、分布式Xgbosot_Ray架构图如下:

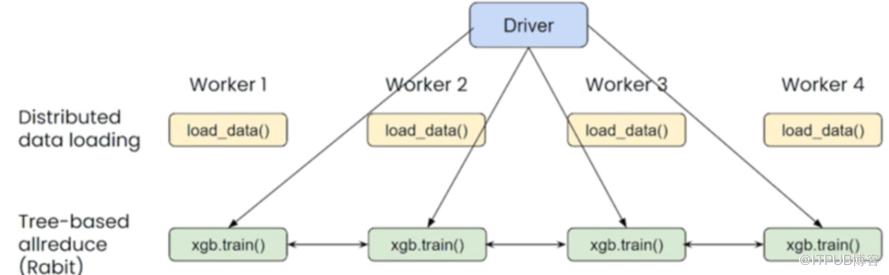
Rabit是一个实现Allreduce(规约)和broadcast的容错接口的轻量级库,底层是用socket进行通信的
(1)先在driver端启动一个RabitTracker,RabitTracker提供N个endpoint给worker连接。
(2)每一个xgboost训练节点通过rabit框架和rabitTracker通信完成注册,rabitTracker将这些rabit编号并形成环形网络结构。
(3)当所有的worker结点都建立起完备的网络拓扑关系以后,就可以启动计算任务监控整个执行过程。
2.3、RabitTracker具体执行任务:
RabitTracker是由工程下的tracker.py来创建。具体做的事如下:
(1)启动daemon线程,提供worker结点注册联接所需的end point,所有的worker结点都可以通过与Tracker程序通信来完成自身状态信息的注册。
(2)co-ordinate worker结点的执行:为worker结点分配Rank编号。基于收到的worker注册信息完成环形网络结构的构建,并广播给worker结点,以确保worker结点之间建立起合规的网络拓扑。
(3)当所有的worker结点都建立起完备的网络拓扑关系以后,就可以启动计算任务监控整个执行过程。
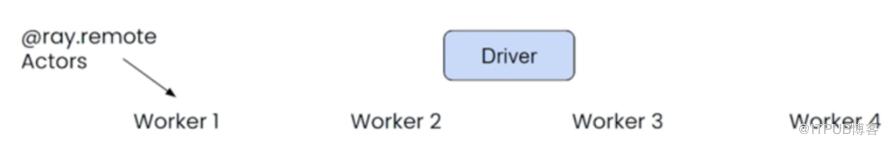
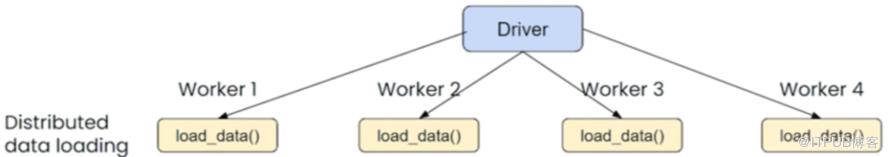
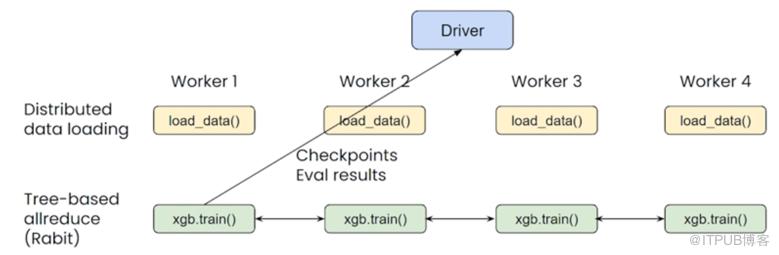
(1)在Ray的每个worker节点中使用ray.remote远程调用进行分布式数据集加载;
3、xgboost_ray功能点介绍
3.1、分布式数据集加载:
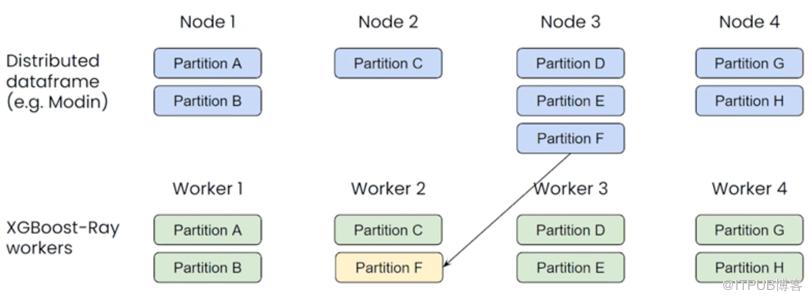
原因:pandas是单核运行的,当大数据量加载入缓存时,会将庞大的dataframe同时拷贝入缓存中,引入modin(ray),充分利用多核cpu
•如何进行分区数据传输
查看分区dataframe数据当前位于哪些节点上,并将分区分配给当前workers结点以最小化跨节点数据传输,且每个分区大小是统一的。
3.2、分布式数据集加载—api使用
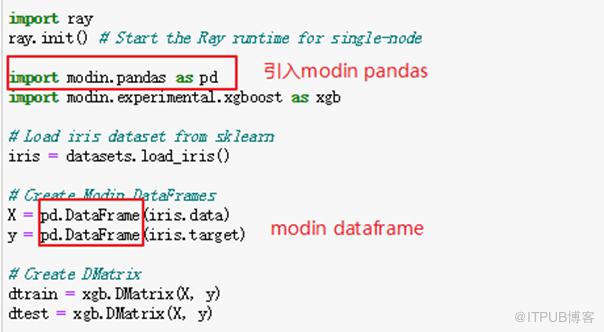
3.3、xgboost_ray容错机制
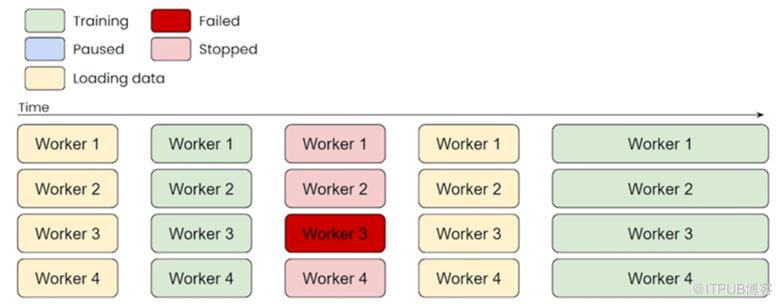
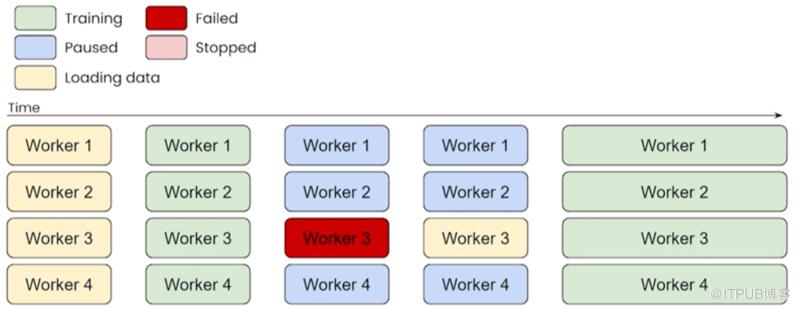
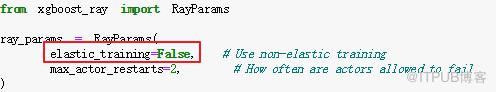
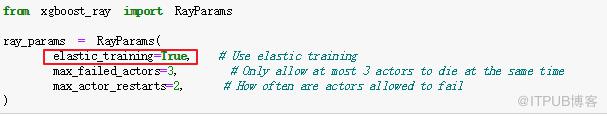
在分布式训练中,部分节点一定会出现失败情况,xgboost_ray的容错机制中提供三种恢复方式:

3.5、容错机制--benchmark

4、xgboost_ray代码走读

下图为训练的具体执行源码,若想看完整流程,可自行在源码中查看
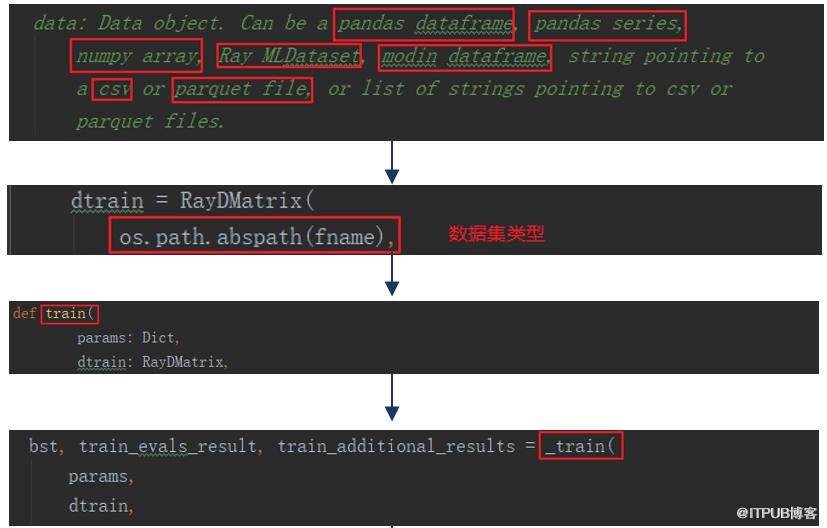
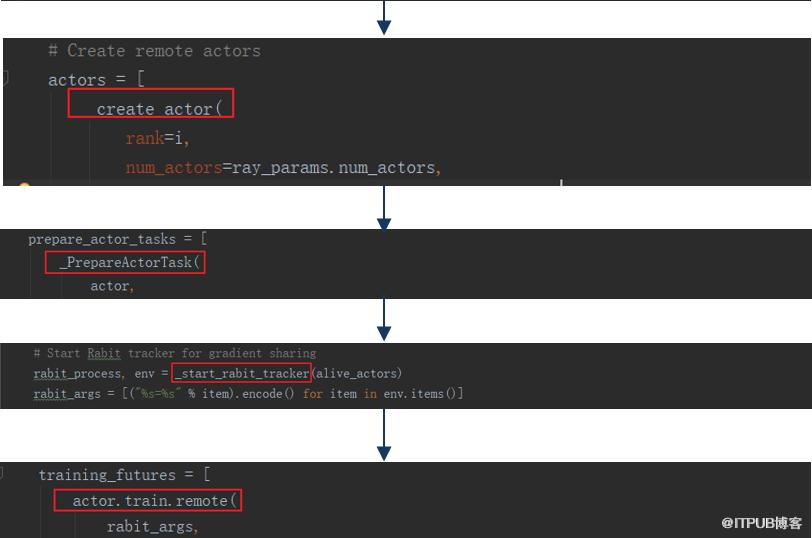
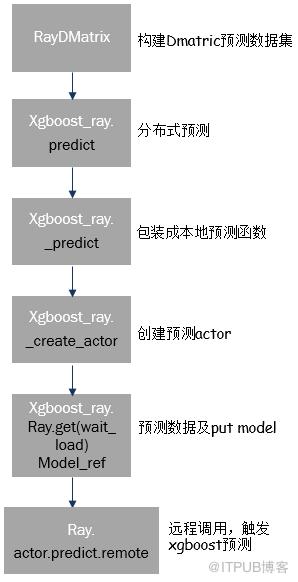
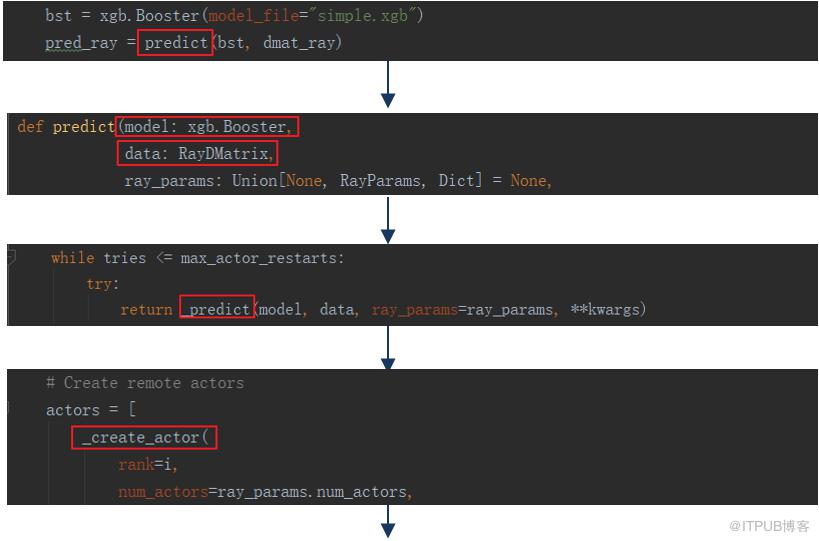
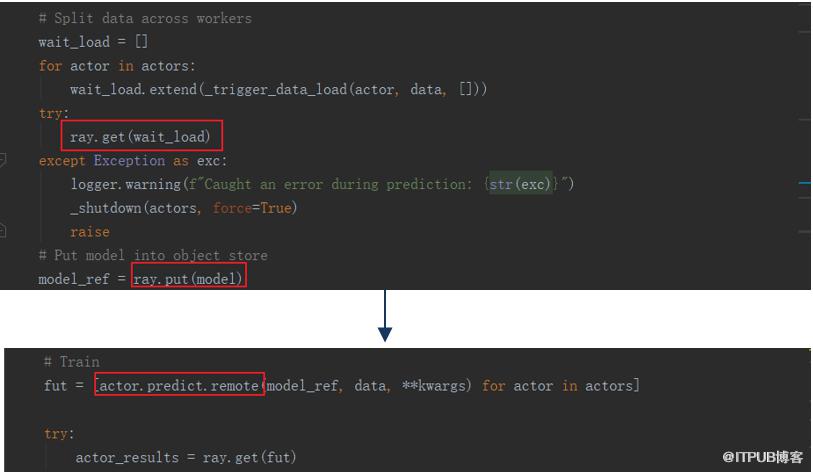
5、xgboost_ray的具体应用
下图为xgboost_ray在Uber中使用的流程图:

通过使用Spark + xgboost_ray技术进行实现:
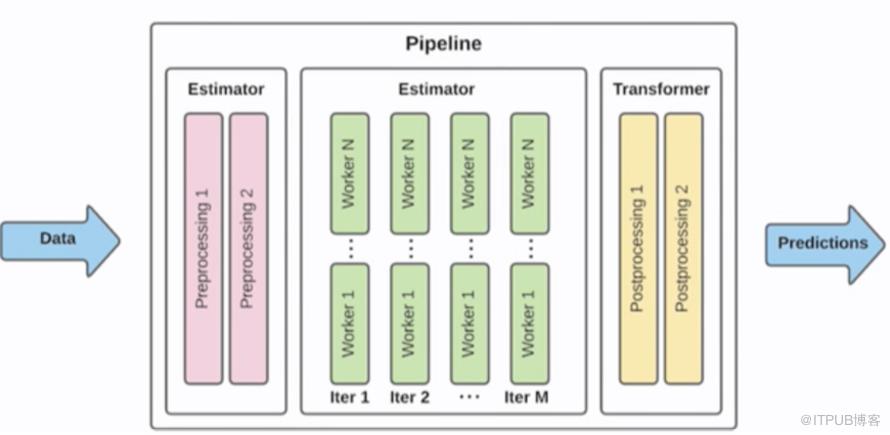
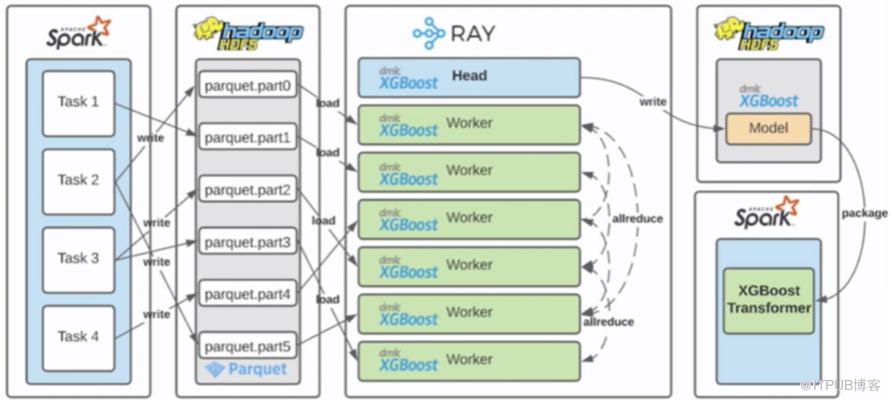
spark+ xgboost_ray 代码使用如下:

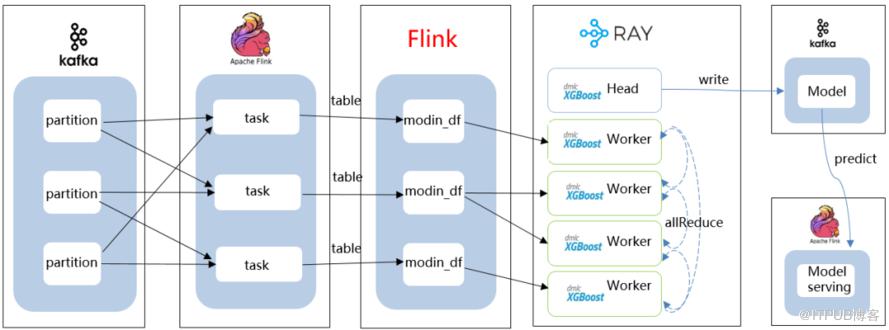
以上就是 Xgboost_Ray在Uber大规模生成落地中的优化与实践的讲解内容!觉得好的,点赞,在看,分享三连击,谢谢!!!

End
找各类大数据技术文章和面经,就来
<3分钟秒懂大数据>
随时更新互联网大数据组件内容
专为学习者提供技术博文
快和身边的小伙伴一起关注我们吧!
作者简介:逆流而上Mr李,秋招7offer,CSDN博客:https://blog.csdn.net/weixin_38201936
原文作者:3分钟秒懂大数据;如有侵权,请联系管理员删除。

最新文章
- 大数据面试,被问到频率最高的三道考题,值得一看~
- 工作中常用的50+ Linux 命令,建议收藏~
- 字节面试sql题:有一张工资表,字段分别是:员工工号、部门、工资。要求各部门除去最高工资和最低工资后的平均工资
- 一篇忍不住看很多遍的数据建模理论与实践(7000字+25张图)
- 网易云音乐P0级事故!官方回应:未删库,未跑路!
- 我发现很多计算机专业的学生都长期处于迷茫中...
- 离职流程都走完了,领导又分了一个新任务让我要么工作日加班,要么周末加班,两周搞完...
- HR最认可的5个离职原因:1、个人发展空间受限;2、公司组织结构变化;3、工作内容与职业发展不匹配...
- 月薪4.5w,离职后每月只补偿2590元,违约就要赔100万!
- 这是雷军的简历,落魄时卡里只有冰冷的40亿...
