关注并标星 3分钟秒懂大数据
每天1次,打卡阅读
获取大数据技术、面经、内推信息
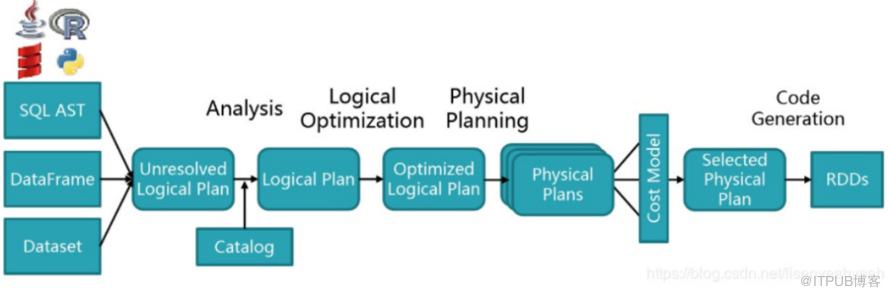
解析(Parser)
绑定(Analysis)
优化(Optimization)
执行(Physical)
生成RDD(RDDs)
Antlr4
1、简介

最新的Spark-Sql解析模块为spark-catalyst_2.11,通过Antlr4(Another Tool for Language Recognition)框架来实现。ANTLR 是用JAVA写的语言识别工具,它用来声明语言的语法。它的语法识别分为两个阶段:
根据词法,构建出一棵分析树(parse tree)或叫语法树(syntax tree)

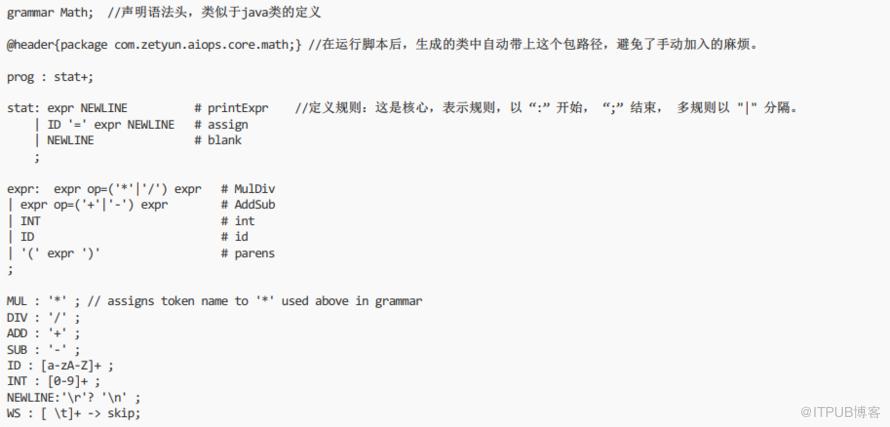
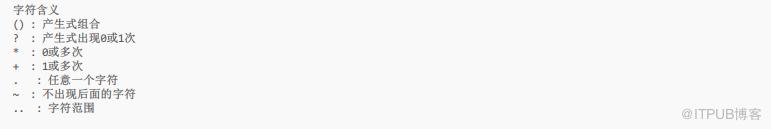
2、语法

3、编译


可通过IDEA的maven插件编译,之后可在根目录\target\generated-sources\antlr4\com\hikvs\bigdata\catalyst\parser下产生以下JAVA文件:

4、遍历模式

public class MathVisitorTest extends MathBaseVisitor<Integer> {Map<String, Integer> memory = new HashMap<String, Integer>();@Overridepublic Integer visitPrintExpr(MathParser.PrintExprContext ctx) {Integer value = visit(ctx.expr());return value;}@Overridepublic Integer visitAssign(MathParser.AssignContext ctx) {String id = ctx.ID().getText();int value = visit(ctx.expr());memory.put(id, value);return value;}@Overridepublic Integer visitBlank(MathParser.BlankContext ctx) {return super.visitBlank(ctx);}@Overridepublic Integer visitParens(MathParser.ParensContext ctx) {return visit(ctx.expr());}@Overridepublic Integer visitMulDiv(MathParser.MulDivContext ctx) {int left = visit(ctx.expr(0));int right = visit(ctx.expr(1));if ( ctx.op.getType() == MathParser.MUL ) return left * right;return left / right;}@Overridepublic Integer visitAddSub(MathParser.AddSubContext ctx) {// TODO Auto-generatedmethod stubint left = visit(ctx.expr(0));int right = visit(ctx.expr(1));if ( ctx.op.getType() == MathParser.ADD ) return left + right;return left - right;}@Overridepublic Integer visitId(MathParser.IdContext ctx) {String id = ctx.ID().getText();if ( memory.containsKey(id) ) return memory.get(id);return 0;}@Overridepublic Integer visitInt(MathParser.IntContext ctx) {return Integer.valueOf(ctx.INT().getText());}}public class Math {public static void main(String[] args) {CharStream input = CharStreams.fromString("1*(6-3)/2");MathLexer lexer = new MathLexer(input);CommonTokenStream tokens = new CommonTokenStream(lexer);MathParser parser = new MathParser(tokens);ParseTree tree = parser.prog(); // parseMathVisitorTest vt = new MathVisitorTest();Integer r = vt.visit(tree);System.out.println(r.toString());}}
5、Spark-sql之Antlr4

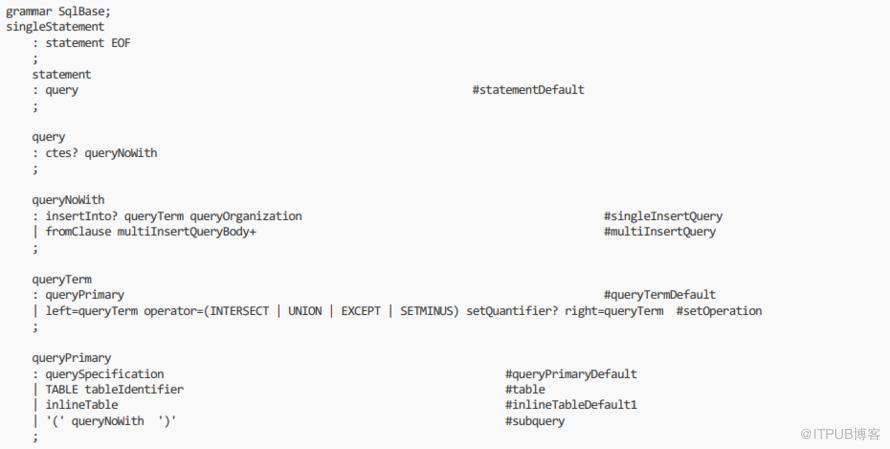

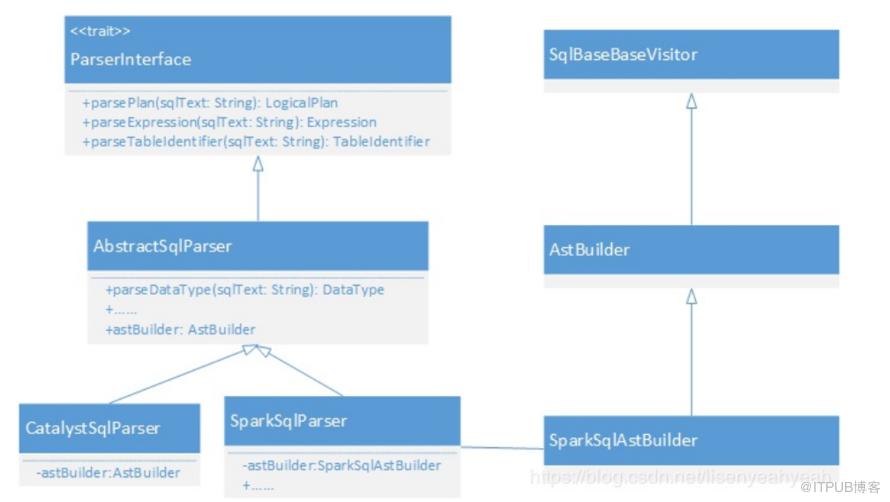
class AstBuilder(conf: SQLConf) extends SqlBaseBaseVisitor[AnyRef]{override def visitQuerySpecification(ctx: QuerySpecificationContext): LogicalPlan = withOrigin(ctx) {.......}override def visitSingleStatement(ctx: SingleStatementContext): LogicalPlan = withOrigin(ctx) {.......}override def visitSingleExpression(ctx: SingleExpressionContext): Expression = withOrigin(ctx) {.......}}
class SparkSession private(){def sql(sqlText: String): DataFrame = {Dataset.ofRows(self, sessionState.sqlParser.parsePlan(sqlText))}}
override def parsePlan(sqlText: String): LogicalPlan = parse(sqlText) { parser =>astBuilder.visitSingleStatement(parser.singleStatement()) match {case plan: LogicalPlan => plancase _ =>val position = Origin(None, None)throw new ParseException(Option(sqlText), "Unsupported SQL statement", position, position)}}protected def parse[T](command: String)(toResult: SqlBaseParser => T): T = {logDebug(s"Parsing command: $command")val lexer = new SqlBaseLexer(new UpperCaseCharStream(CharStreams.fromString(command)))lexer.removeErrorListeners()lexer.addErrorListener(ParseErrorListener)val tokenStream = new CommonTokenStream(lexer)val parser = new SqlBaseParser(tokenStream)parser.addParseListener(PostProcessor)parser.removeErrorListeners()parser.addErrorListener(ParseErrorListener)try {try {// first, try parsing with potentially faster SLL modeparser.getInterpreter.setPredictionMode(PredictionMode.SLL)toResult(parser)}catch {......}}catch {......}}

1、TreeNode
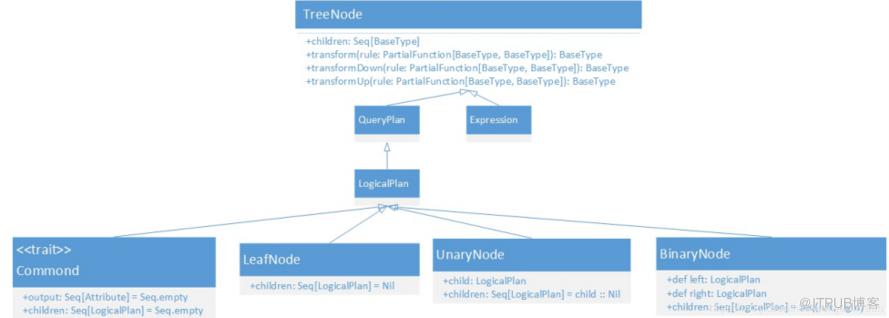

LogicalPlan是TreeNode 的子类,作为数据结构记录了对应逻辑算子树节点的基本信息和基本操作,包括输入输出和各种处理逻辑等。

2、QueryPlan
QueryPlan是LogicalPlan的直接父类,继承自TreeNode,其核心属性和方法可以分为6个部分:
1.输入输出
输入或输出属性,比如Project的output方法就返回所有查询的字段信息。
override def output: Seq[Attribute] = projectList.map(_.toAttribute)2.基本属性
表示QueryPlan节点的一些基本信息,比如其中schema对应output输出属性的schema信息。
lazy val schema: StructType = StructType.fromAttributes(output)3.字符串
打印QueryPlan树形结构信息。
4.规范化
QueryPlan的canonicalized直接赋值为当前的QueryPlan类,sameResult方法会利用canonicalized来判断两个QueryPlan的输出结果是否相同。
5.表达式操作
比如expressions会返回改节点所有表达式的列表,另外还有遍历表达式的方法transformExpressions等。
6.约束
可以推导的一种过滤条件,比如“a>1”,可以推出a不能为null。

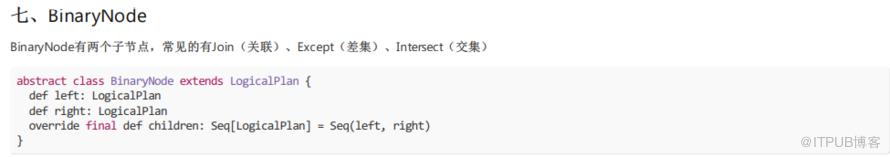
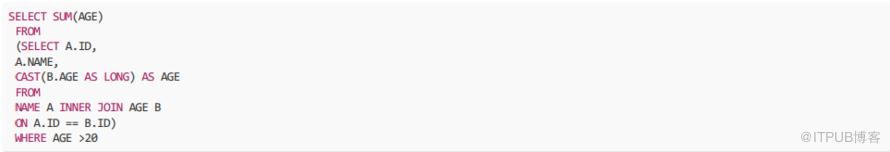
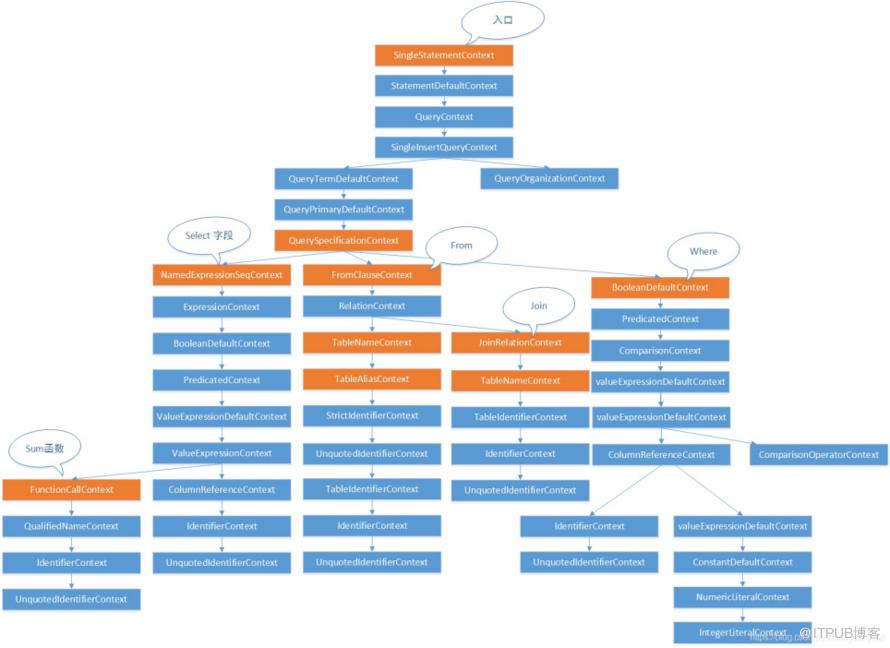
override def visitQuerySpecification(ctx: QuerySpecificationContext): LogicalPlan = withOrigin(ctx) {val from = OneRowRelation().optional(ctx.fromClause) {visitFromClause(ctx.fromClause)}withQuerySpecification(ctx, from)}
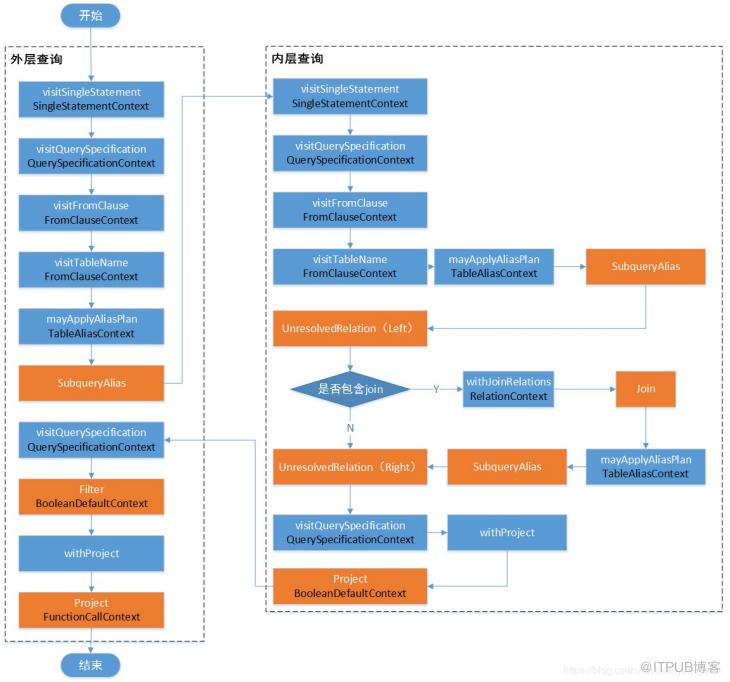
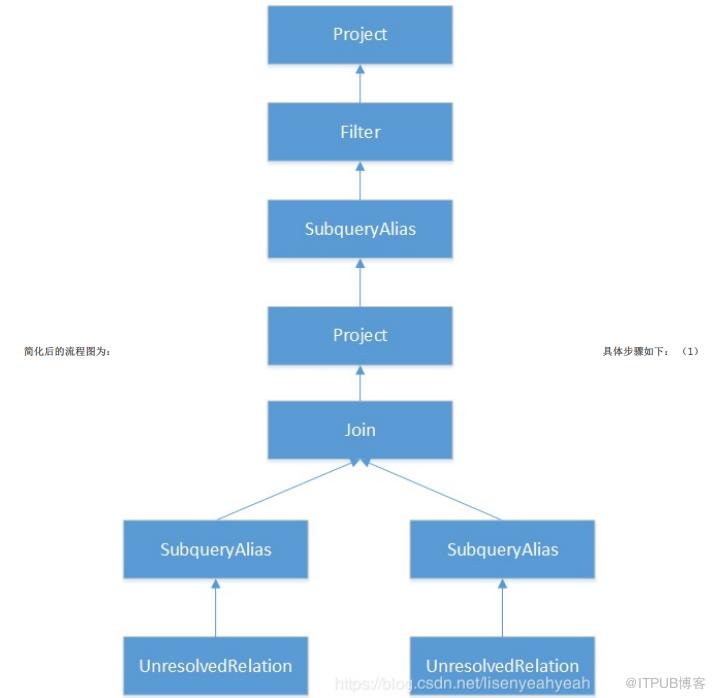
(4)Project:对应SQL语句中select对列值的选择操作,Asbuilder在访问中会获取 NamedExpressionSeqContext,并对其所有子节点对应的表达式进行转换,生成Expression列表expressions,基于expressions构造Project(namedExpressions, withFilter)返回。
其中各节点中的Expression情况如下:下表列出了构造Filter逻辑算子树节点中的condition表达式。根据ColumnReferenceContext节点信息生成 UnresolvedAttribute表达式。
| 访问操作 | Expression |
| visitColumnReference | UnresolvedAttribute(Seq(“age”)) |
| visitIntegerLiteral | Literal(20, IntegerType) |
| visitComparison | GreaterThan(left, right) |
| 访问操作 | Expression |
| visitColumnReference | UnresolvedAttribute(Seq(“a.id”,“a.name”,“cast(b.age as bigint)”)) |


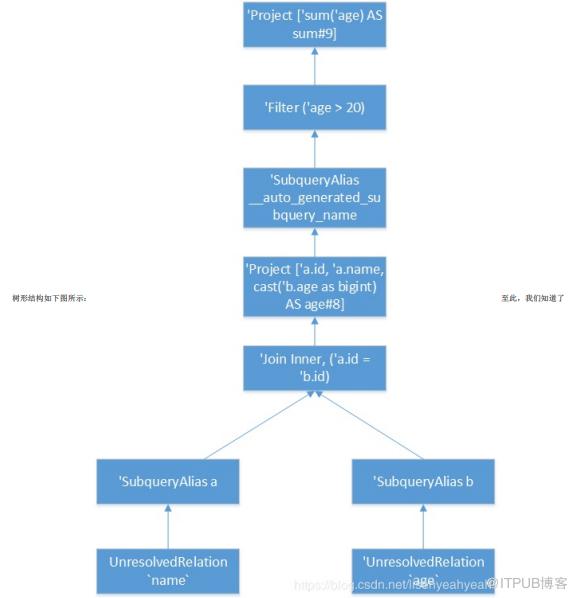
以上就是Spark - SQL 解析第一阶段的所有内容!觉得好的,点赞,在看,分享三连击,谢谢!!!

End
找各类大数据技术文章和面经,就来
<3分钟秒懂大数据>
随时更新互联网大数据组件内容
专为学习者提供技术博文
快和身边的小伙伴一起关注我们吧!
作者简介:逆流而上Mr李,秋招7offer,CSDN博客:https://blog.csdn.net/weixin_38201936
原文作者:3分钟秒懂大数据;如有侵权,请联系管理员删除。

最新文章
- 大数据面试,被问到频率最高的三道考题,值得一看~
- 工作中常用的50+ Linux 命令,建议收藏~
- 字节面试sql题:有一张工资表,字段分别是:员工工号、部门、工资。要求各部门除去最高工资和最低工资后的平均工资
- 一篇忍不住看很多遍的数据建模理论与实践(7000字+25张图)
- 网易云音乐P0级事故!官方回应:未删库,未跑路!
- 我发现很多计算机专业的学生都长期处于迷茫中...
- 离职流程都走完了,领导又分了一个新任务让我要么工作日加班,要么周末加班,两周搞完...
- HR最认可的5个离职原因:1、个人发展空间受限;2、公司组织结构变化;3、工作内容与职业发展不匹配...
- 月薪4.5w,离职后每月只补偿2590元,违约就要赔100万!
- 这是雷军的简历,落魄时卡里只有冰冷的40亿...
