LeCun说,chatgpt与其说是算法理论重大突破,不如说是一个成功的工程案例。我这几天仔细盘了一下。他说的是对的。但无法否认chatgpt的巨大价值。
整个chatgpt的技术底盘脉络如下:
1 . RLHF 。Reinforcement Learning from Human Feedback,2017年,deepmind教openai的人玩强化学习,然后openai的人真的学会了。Deepmind在他们论文的博客[5]上清晰的写到:deepmind是有大格局的人,希望用AI推动人类社会的进步,从气候变化到医疗保健,我们从人类历史的角度出发,勇挑重担,构建合作伙伴研发团队以造福人类,这就是为什么我们还与 OpenAI 合作进行人工智能安全技术研究。因此,今天,我们有了这次跟openai合作构建RLHF研究实践。
2.gpt-2 BaseRLHF[3] .后来,deepmind去干alphazero、alphafold去了。OpenAI里面更多NLP背景的人,他们把强化学习拿来干NLP了。这就是美团王慧文经常强调的目前行业最需要的M型人才,需要广阔的背景和跨算法种类跨专业背景团队的原因。2019年,openAI 的人拿着RLHF这个利器玩了一把GPT-2,发现效果还不错,一直就念念不忘了。我们知道,gpt-2是自监督学习算法,他通过读入一篇文章的前面部分,来预测下一句话会是啥,从而可以自动学习海量样本,类似于人类读万卷书一样。而RLHF就是一个强化学习器,让他这个模式没那么死板,因为只会预测下一句话这个模型不够好玩,而聊天机器人是希望你能像人类正常沟通。因而RLHF的作用就是让GPT-2变灵泛。
3、2022年,InstructGPT,就是gpt-3 baseRLHF [4].从此以后,一旦NLP层面有了新的突破,openai的团队成员就用 RLHF玩一把 gpt。就这么回事。NLP 上的进展也非常关键,GPT-3构建了一个上下文推理的GPT,从而具备了连续对话的能力。
4、chatgpt。这次是量变引起质变了。你可以理解为在Instruct GPT 的基础上又玩了一些trick,同时灌入了题海战术,突然就考上了北大。就这么回事。他们在[6]里清晰写到:
“我们使用与 InstructGPT 相同的方法,使用人类反馈强化学习 (RLHF) 训练该模型,但数据收集设置略有不同。我们使用监督微调训练了一个初始模型:人类 AI 训练员提供对话,他们在对话中扮演双方——用户和 AI 助手。我们让培训师可以访问模型编写的建议,以帮助他们撰写回复。我们将这个新的对话数据集与 InstructGPT 数据集混合,我们将其转换为对话格式。
为了创建强化学习的奖励模型,我们需要收集比较数据,其中包含两个或多个按质量排序的模型响应。为了收集这些数据,我们收集了 AI 培训师与聊天机器人的对话。我们随机选择了一条模型编写的消息,抽取了几个备选的完成方式,并让 AI 培训师对它们进行排名。使用这些奖励模型,我们可以使用近端策略优化来微调模型。我们对这个过程进行了几次迭代。”
第一回合,我们先从这个RLHF基石出发,剥开chatgpt的内核情景。
一、RLHF:让AI真正有了人类的感觉
ACM界楼天城曾经有句名言:这个题我不会做,到AC还是没问题的。拿来套在RLHF上理解这个算法的精髓就再合适不过了。如果细究就是,我觉得这个人人品不行,说话做事都不靠谱,但如何定义他是什么类型的人又没有比较好的形容词。从强化学习的角度出发,我们知道,强化学习中的rewards是指挥棒,相当于监督信号,rewards函数的定义是非常关键和重要的,定义不清晰就会让模型学不会。但当事情非常复杂是,我们不能用数学符号和严格的数学语言来定义rewards,这个情景放在语言学领域就更加适合了。我们知道很多语法是不合逻辑的,死记硬背语法结构往往让人对一些句子理不清楚具体含义,如果连语法结构都不能完整定义清楚,要定义NLP领域的rewards就更难了。怎么办呢?找黄牛了干活就够了。RLHF整个算法就是增加了一个中间人黄牛,让你省心了不少。
核心算法就一张图:
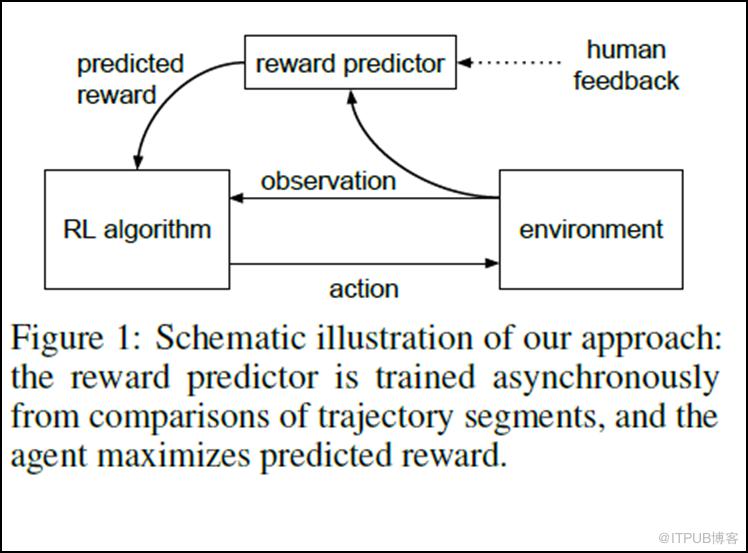
如果reward是数学语言定义好的rewards,那么整个算法就是一个传统的deepRL 算法pipeline,增加的这个reward predictor就是上文讲的rewards黄牛。
reward predictor的原理:RL算法输出一些结果,然后从中挑出两个(或多个)给人类标记员,人类标记员如果觉得这个错误非常简单可以用数学公式表示就直接给出一个定量的排序分;如果结果说不上来哪不对,只是觉得有的表述更好,就给一个简单的定性的排序结果。然后这些反馈信号,系统收集到后,用来学习一个rewards网络。这个网络就是rewards的表示,你可以认为他就是一个函数F(input_byRLoutput)=人类的打分。这个网络学会了以后,就可以拿这个打分函数来预测一个rewards值了,这个rewards值就拿去训练RL模型。怎么训练就跟常规的RL训练方式一样即可。
这就是整个论文算法的精髓。一句话总结就是:我们通过人类对RL的输出结果,做定量或定性的排序信号,拿来训练了一个rewards函数,用来解决rewards函数不能严格数学定义的问题,从而提升deepRL能够触达到的边界。从而从围棋这种严格逻辑问题跨越到了自然语言处理领域。
二、关于社区版chatgpt
一年内会有社区版的chatgpt出来,目前我拟定的技术路线就是:先把RLHF代码吃透,然后把 gpt-2 on RLHF 玩明白。基本算法框架就有了。接下来要自己实现一个instructgpt。如果实现了instructgpt,基本的脚手架就搭建完成了。后面就是玩训练trick喂题海战术了。这个就是商业化的事情了。
目前还有至少半年的窗口期,如果真做出来了业界肯定会有大佬来收编这个团队的。我本来想投奔我很尊重的颜老师搞的,但风险太大。公众号的博主们是否有兴趣带我玩呢?我先建了个git了。把资料和代码都先往上放了[1]。如何构建一个GPT-3的代码和数据集也非常关键,这块我懂的不多。
参考文献:
[1] https://github.com/scalaboy/chatgpt
[2] Deep Reinforcement Learning from Human Preferences [Christiano et al., 2017]
[3] Ziegler, D. M., Stiennon, N., Wu, J., Brown, T. B., Radford, A., Amodei, D., ... & Irving, G. (2019). Fine-tuning language models from human preferences. arXiv preprint arXiv:1909.08593.
[4] Ouyang, L., Wu, J., Jiang, X., Almeida, D., Wainwright, C. L., Mishkin, P., ... & Lowe, R. (2022). Training language models to follow instructions with human feedback. arXiv preprint arXiv:2203.02155.
[5]https://www.deepmind.com/blog/learning-through-human-feedback
[6] https://openai.com/blog/chatgpt/
原文作者:Agent的潜意识;如有侵权,请联系管理员删除。

