放弃造车的APPLE,当时宣布入局生成式AI。苹果是手机厂商,那么最大的刚需就是让LLM上手机端。苹果手机的人脸识别解锁也是最早量产的。看样子苹果是在往这块发力了。昨天4月24日苹果发布了自己的大语言模型open ELM。4个尺寸 270M 450M 1.1B和3B参数量。·论文地址:https://arxiv.org/pdf/2404.14619.pdf·项目地址:https://github.com/apple/corenet·论文标题:OpenELM: An Efficient Language Model Family with Open-source Training and Inference Framework作者列表:Sachin Mehta, Mohammad Hossein Sekhavat, Qingqing Cao, Maxwell Horton, Yanzi Jin, Chenfan Sun, Iman Mirzadeh, Mahyar Najibi, Dmitry Belenko, Peter Zatloukal, Mohammad Rastegari里面不少华人。git地址是corenet。另一个openelm的git是以前其他公司搞的。1、目前他做对比实验主要是去年底全栈开源的OLMo模型。https://github.com/allenai/OLMo在参数量和训练集都小于OLMo的前提下,效果有所提升。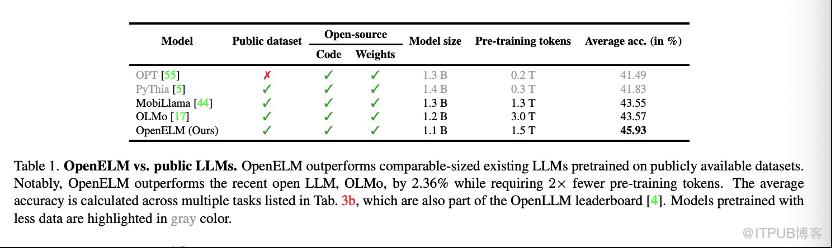
参数小1M,训练集只有一半(1.5T token)。效果比Olmo提升了2.4个百分点。属实难得。1)在所有全连接(也称为线性)层中不使用可学习的偏置参数。2)使用RMSNorm进行预归一化,并使用旋转位置嵌入(ROPE)来编码位置信息。3)采用分组查询注意力(Grouped Query Attention, GQA)代替多头注意力(Multi-Head Attention, MHA)。4)用SwiGLU FFN替换传统的前馈网络(Feed Forward Network, FFN)。5)使用Flash Attention计算缩放点积注意力(scaled dot-product attention)。对多头注意力进行分group目前基本成了模型结构的标配。确实有效果。唯一的创新点是他对每层参数量大小做了缩放。我详细看了下公式计算规则。他这个是从前往后参数量增加的模式来设计模型结构的。他构建了一个缩放因子 ai,层数i越深,缩放因子a越大,从而多头注意力机制中的head数nh越多,参数量就越大。
训练他用的是8卡H100的GPU,评测他用的是4090。具体配置如下:i9的intel CPU,64G的内存,1块4090显卡。这个配置我试了下,也可以训练270M的模型。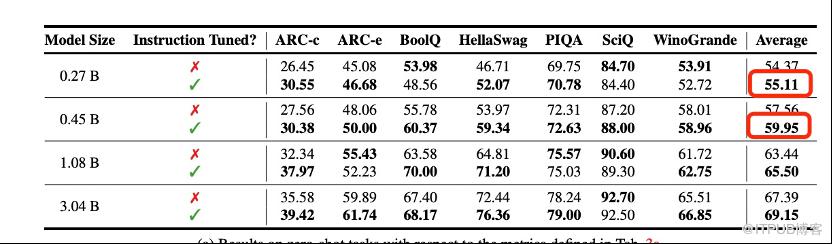
就是0.27B和0.45B的模型效果相差很小。平均不到5个点。
原文作者:Agent的潜意识;如有侵权,请联系管理员删除。

