下午才有朋友给我发了潞晨科技的这个开源chatgpt的火爆宣传文。核心卖点是1.62GB和提速7.73倍。
有些国人真是浮躁,新闻工作者就更加喜欢搞人咬狗的大新闻了。
这个开源项目ColossalAI本来也算是有些东西的,不过一万颗星我估计有些是花钱买的吧。
先谈整体的,这个不是一个chatgpt,如果你真做出来了就不要记者写大新闻,直接给个API跟openai一样就可以了。或者你自己让机器写一篇宣传稿不就比啥都有说服力了。
其次谈具体的,这个团队是做高性能计算的,一直在做模型压缩加速,在这方面有不少沉淀,模型策略训练和并行化训练框架上做了不少优化,但他们的思维惯性也在这里,他们不会去关心算法效果的,所谓的算法效果就是说chatgpt能给你写一个面向对象的python代码这种挑战coder底线的效果。
整个架构的chatgpt这块的代码我全看明白了。但还没跑通,还有很多bug。接下来谈技术点。你可以认为目前社区写了一个pytorch版的RLHF on GPT2的算法,并且做了底层训练器的显存优化。
可取的点:用pytorch重构了一把RLHF on GPT2,

左边是潞晨开源的,右边是RLHF on gpt2,基本结构是相同的。这里报个bug:训练脚本里有一个from chatgpt.trainner import RewardModelTrainer,事实上,这个RewardModelTrainer他放在了chatgpt.trainner.rm里面去了。直接运行会报错的。
并且把已有的训练器底层优化工具有机结合到了一起。非常不错的一个贡献。
底层训练器优化模块在这里:
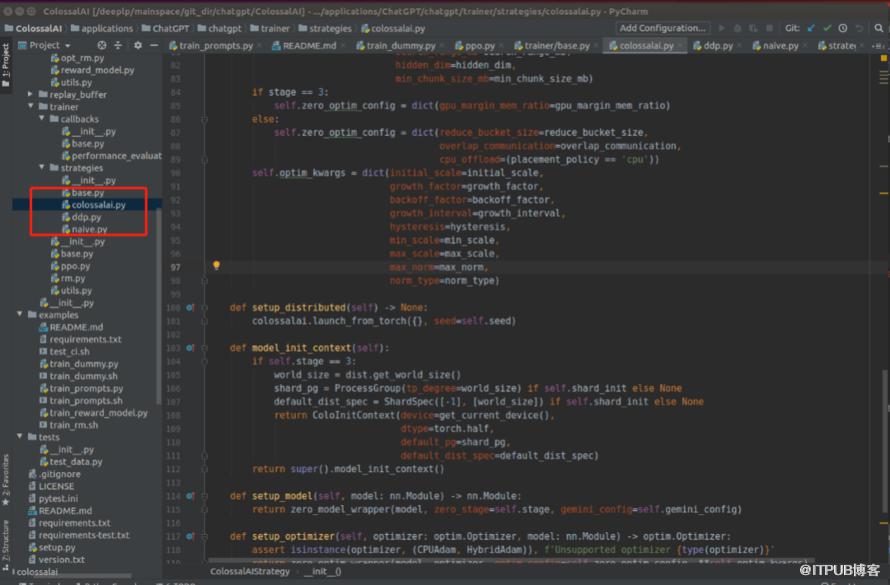
这也是一个可行的第一步。我们不需要一开始就买很多显卡,然后去搞很大的模型,去琢磨一些资源的事情,首要的应该是把算法底盘摸清楚,在点上做突破。比如说我虽然模型小服务器少,但我把中国历史人物全部学明白了。可以对答如流,就是一个真正的chatgpt单科简易版。
不可取的点:有点削足适履。底层优化器这些应该是作为一个library导入进工程中。这个chatgpt的工程要面向算法效果建模,随便说一下现在这个工程的不可取的点:
当前的工程是没有COT功能的,现在ICLR有一个auto-cot[1]的算法,我需要把这块加进去,作为效果训练的核心组件,这个工程就不支持这样的扩展了。
理想的开源chatgpt工程应该是有数据集板块,有算法板块,随需应变支持效果的反推理和算法模块的插拔,以便达到理想的算法效果。而底层优化器应该是一个非常便捷的library,可以直接调用进trainer类中。
凡是过往,兼为过往。老实说,每天清晨醒来我也会发现自己对于chatgpt而言昨天只学了个皮毛。包括我直接分享的内核,我觉得也还只算是皮毛。后面在分享一些我当面觉得不错,后面会觉得是皮毛的点。责人之心责己,恕己之心恕人。我觉得社区这个工作还是不错的。
参考文献:
[1] https://github.com/amazon-science/auto-cot
原文作者:Agent的潜意识;如有侵权,请联系管理员删除。

