一、为什么要做数据清理?
数据清理的具体方法可能因数据类型、业务需求和数据源而异。因此,在实际操作中,需要根据具体情况调整和优化数据清理策略。此外,定期审查和更新数据清理规则也是非常重要的,以确保数据质量的持续提高。
二、数据清理的关键点是什么?
-
删除重复数据:在提取数据后,首先需要检查并删除重复的记录。这可以通过比对不同字段(如主键)来实现,确保数据集中每条记录的唯一性。
-
处理缺失值:数据中的缺失值是一个常见问题。处理缺失值的方法包括删除含有缺失值的记录,使用默认值、平均值、中位数或众数等统计量来填充缺失值,或者通过插值法(如线性插值、多项式插值等)来估算缺失值。
-
纠正错误数据:对于错误的数据,可以通过统计分析、偏差分析或识别不遵守分布或回归方程的值来识别并纠正。此外,还可以使用简单规则库、业务特定规则或外部数据来检查和清理数据。
-
处理异常值:异常值是指那些明显偏离正常范围的数值。这些值可以通过删除、修正或使用统计量(如平均值、中位数等)来替代。
-
数据格式统一:对于日期、时间、货币等字段,需要确保它们的格式标准化。此外,还需要统一字符串的大小写,清理特殊字符或空格。
-
数据类型转换:在ETL过程中,可能需要将不同数据类型的字段转换为目标数据类型。例如,将文本格式的日期转换为日期格式。
-
业务规则处理:根据业务规则进行数据的筛选、过滤或转换。这可以确保数据符合特定的业务需求和逻辑。
-
数据合并:如果数据来自多个数据源,需要将它们合并在一起。在合并过程中,需要确保数据的完整性和一致性。
数据去重:除了处理重复记录外,还需要处理重复的字段或属性,确保数据的唯一性。
三、南瓜数智平台的数据清理实现
南瓜数智平台已具备数据ETL的功能,可以在平台上进行全表的数据采集、以及数据的增量抽取。
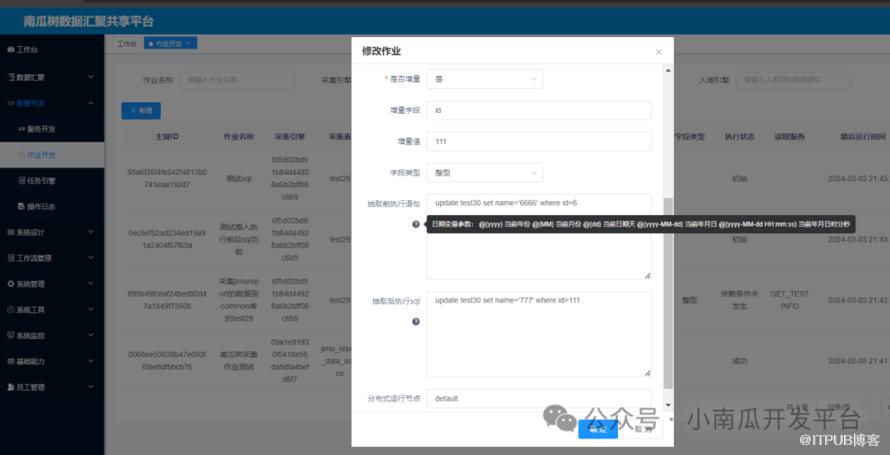
在数据入库前和数据入库目标库后,可通过sql的方式对目标库进行相关数据操作,确保数据的准确性、完整性、唯一性、权威性和合法性。
这包括识别和纠正数据中的错误、删除重复数据、填充缺失值、处理异常值等,以确保数据的质量满足业务需求和分析要求。同时使数据更适合进行数据挖掘、展示和分析。通过数据清理,可以消除数据中的噪声和冗余信息,提高数据的可读性和可理解性,使数据更易于被用户理解和使用。同时,数据清理还可以提高数据的一致性和可比性,为数据分析和决策提供支持。
原文作者:小南瓜开发平台;如有侵权,请联系管理员删除。

