大模型已经在部分场景成功落地应用,例如写作、代码、对话等,但大模型的体量在那摆着,如何高效的推理仍然是一个亟待解决的问题,英伟达的Triton是为了模型推理提效专门的框架,Triton-llm是针对大模型定制的框架,本文先以Triton为例进行探索学习记录。
1. 获取镜像
从官网找到要使用的镜像
https://catalog.ngc.nvidia.com/orgs/nvidia/containers/tritonserver/tags

这里下载的是:triton-py3.tar
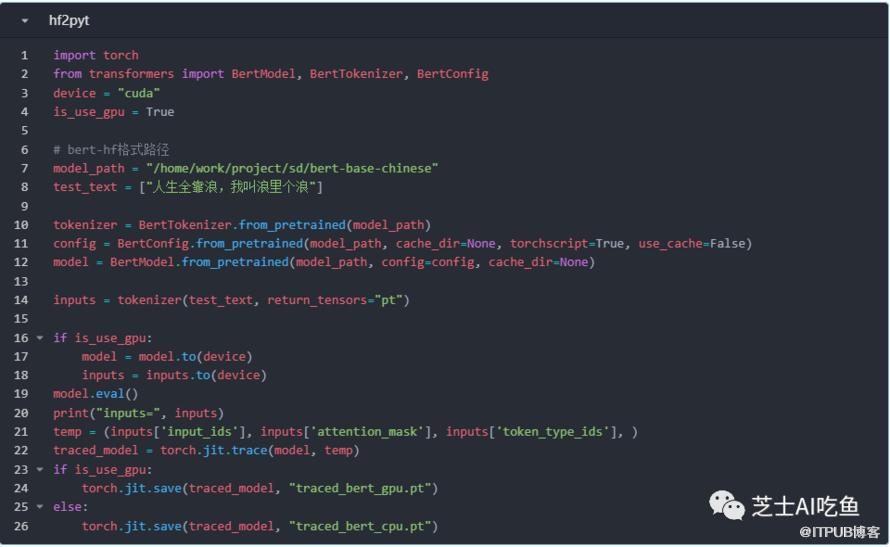
2. 将Hugging Face的模型转化为pytorch的格式
从Hugging Face获取Bert模型,下载到本地路径下,例如:/home/work/project/sd/bert-base-chinese
将HF格式的Bert转化为Pytorch格式的模型,利用如下脚本
3. 从宿主机,设置模型仓库
注意:以下操作是在宿主机,不是在docker容器内!!!
假定当前用户是root,当前所在路径是/root,设定宿主机的模型仓库为${PWD}/llm_model_repository,那么将上述导出的模型,放在模型仓库下,目录结构如下:

llm_model_repository是模型仓库,该目录下存放不同的模型,创建bert文件夹,里面包括一个1文件夹和config.pbtxt文件,1文件夹内是上述导出的traced_bert_gpu.pt文件,重命名到model.pt。config.pbtxt文件内容如下:
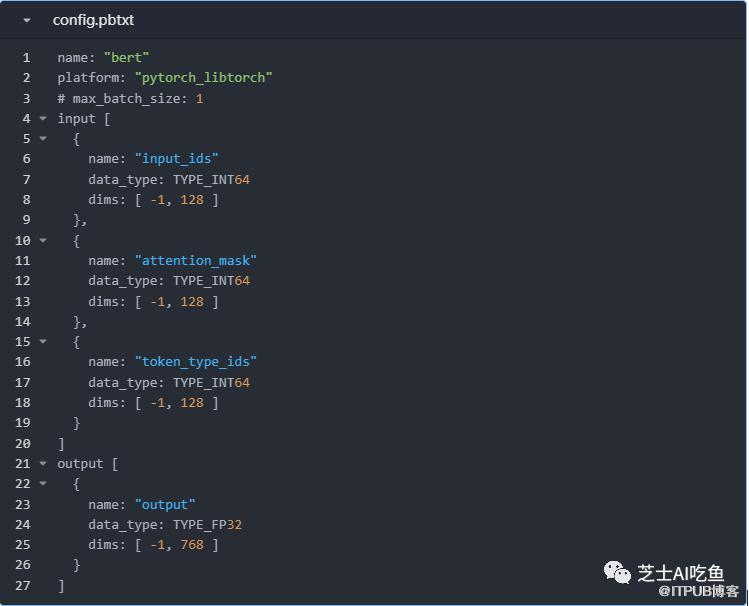
如果请求服务第一次成功,第二次报错:error: extra text after expected end of number
那么在config.pbtxt 添加如下配置项
parameters: {
key: "ENABLE_JIT_EXECUTOR"
value: {
string_value: "false"
}
}
4. 前端执行,可以观察是否能正常加载模型
执行如下的命令:
docker run --gpus=1 --rm -p 10003:8000 -p 10004:8001 -p 10005:8002 -p 10006:22 -v ${PWD}/llm_model_repository:/models nvcr.io/nvidia/tritonserver:23.10-py3 tritonserver --model-repository=/models
如果前端执行,输出successfully loaded ‘bert' 代表模型加载成功,最终访问的IP和端口会打印在最下面:

5. 测试能正常加载模型,则压后台执行 -d命令
上述测试能够成功加载模型后,需要压后台执行如下命令:
docker run --gpus=1 --rm -p 10003:8000 -p 10004:8001 -p 10005:8002 -p 10006:22 -d -v ${PWD}/llm_model_repository:/models nvcr.io/nvidia/tritonserver:23.10-py3 tritonserver --model-repository=/models
6. 执行测试Bert脚本
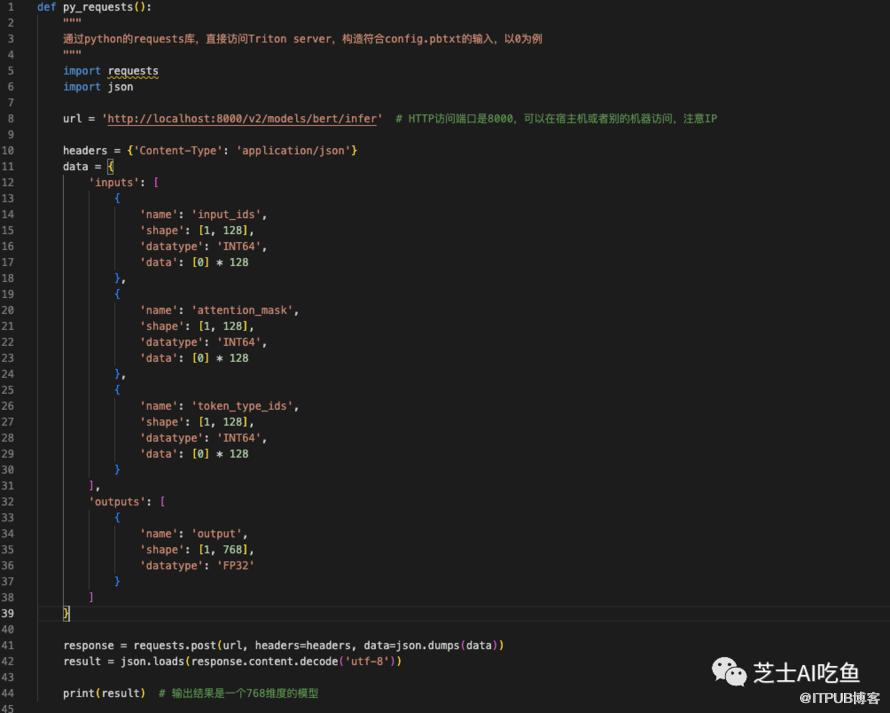
请求Triton server可以通过多种方法:python的第三方库requests、Triton提供的client方式访问,而client方式又支持http和grpc两种方式,client的http和grpc方式是一致的,只是client实现方式不一样,传参一致,可以直接替换。
直接用python的requests库访问
通过Triton的client方式访问
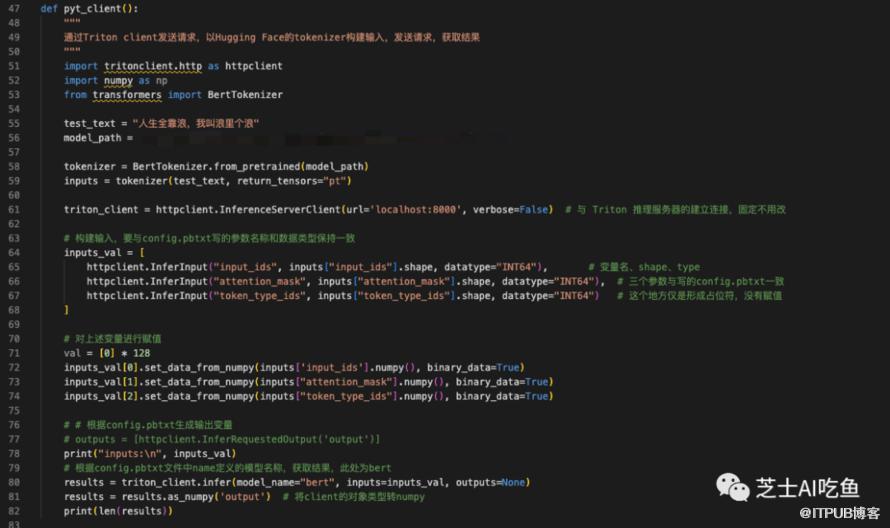
返回如下信息,代表访问成功
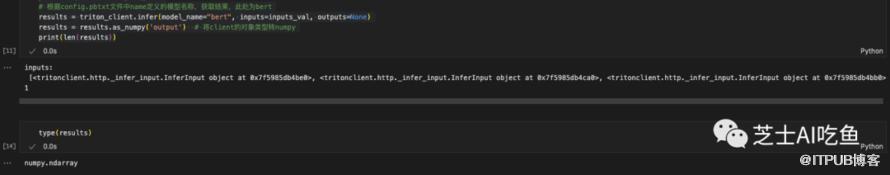
由于返回的是模型的logits,需要根据logits进一步的处理,例如转换为标签、类别等。
一切源码可在github获取:
https://github.com/alg-bug-engineer/daily-record/blob/main/triton_client_test.py
原文作者:芝士AI吃鱼;如有侵权,请联系管理员删除。

