我是芝士AI吃鱼,原创 NLP、LLM、超长文知识分享
热爱分享前沿技术知识,寻找志同道合小伙伴
公众号 :芝士AI吃鱼
知识星球:https://wx.zsxq.com/group/88888881284242
1. 研究背景与动机
近年来,大语言模型(Large Language Models, LLMs)在人工智能领域取得了巨大的进展。为了评估这些模型的能力,研究人员开发了许多评估基准。然而,随着这些基准的广泛使用,人们对其适当性和公平性产生了越来越多的担忧。
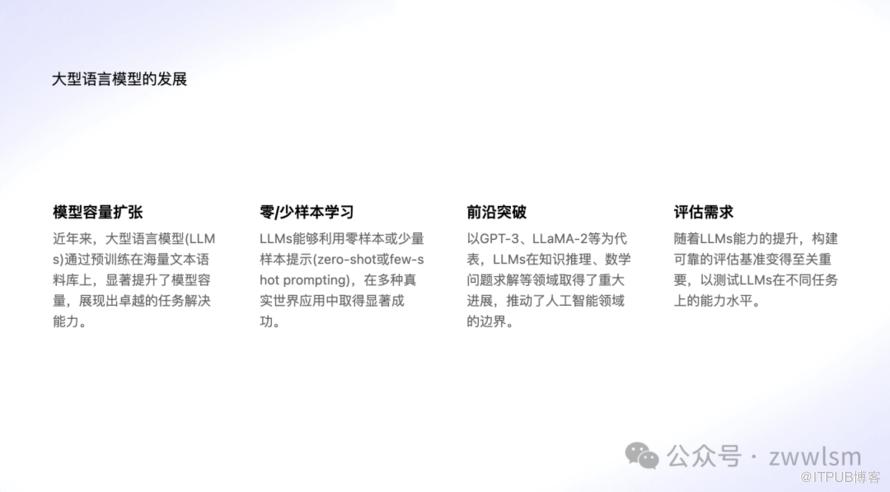
本研究的主要动机包括:
评估基准的重要性:评估基准是衡量LLMs能力的关键工具,对于理解模型进展至关重要。 数据泄露问题:在准备预训练数据时,可能无意中包含了未来评估数据集的相关内容,这可能导致不公平的性能优势。 公平比较的需求:需要确保不同LLMs之间的比较是公平和可靠的。
例如,GPT-3在训练过程中发现其预训练语料库包含了Children's Book Test数据集,而LLaMA-2则提到BoolQ数据集中的上下文是直接从网页中提取的,这些网页可能已经包含在公开可用的语料库中。这些情况都可能导致评估结果的偏差。
2. 基准数据泄露的实证研究
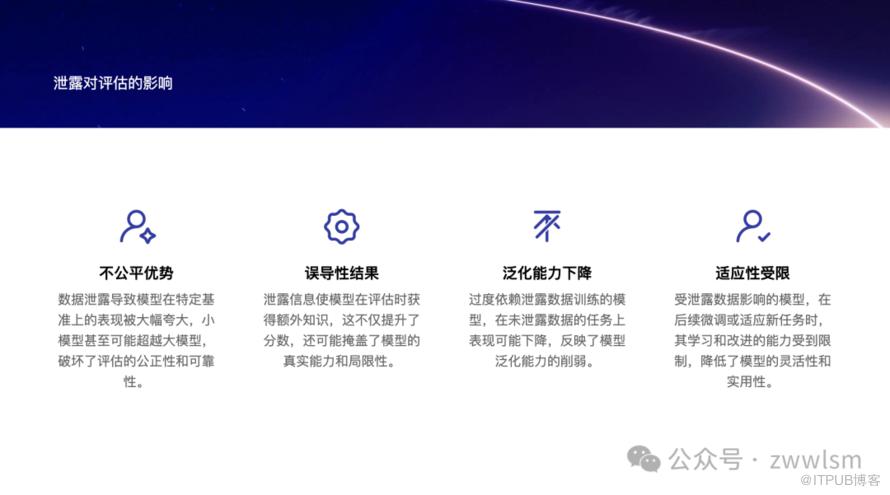
为了研究基准数据泄露的影响,研究人员设计了三种数据泄露场景:
使用MMLU训练集:仅使用MMLU基准提供的辅助训练集进行训练。 使用所有训练集:使用所有收集到的评估基准的训练集进行训练。 使用所有训练集和测试提示:使用所有训练集,并加入相应的测试提示(如任务描述和少样本示例)。 使用所有训练集、测试集和测试提示:这是最极端的情况,包含了所有信息(仅用于参考,实际中绝不应发生)。
研究者选择了四种不同规模的语言模型进行评估:
GPT-Neo-1.3B phi-1.5 (1.3B参数) OpenLLaMA-3B LLaMA-2-7B
评估基准包括:
MMLU(多任务语言理解) 开放域问答任务(如BoolQ, PIQA, Hellaswag等) 推理任务(如CommonsenseQA, GSM8k, AQuA) 阅读理解任务(如RACE, CoQA, CMRC2018等)
实验结果显示,数据泄露显著提升了模型在相关基准上的表现。以下是部分结果的示例:
| 模型 | 训练设置 | MMLU | BoolQ | PIQA | Hellaswag |
|---|---|---|---|---|---|
| GPT-Neo (1.3B) | 无 | 24.04 | 62.57 | 70.57 | 38.65 |
| GPT-Neo (1.3B) | +所有训练集 | 35.10 | 78.32 | 68.61 | 42.46 |
| GPT-Neo (1.3B) | +所有训练集+测试提示 | 36.15 | 76.91 | 73.72 | 42.75 |
这些结果清楚地表明,即使是较小的模型(如1.3B参数的模型)在数据泄露的情况下也能显著提高性能,有时甚至超过了未经泄露数据训练的更大模型。
3. 基准数据泄露的潜在风险
研究还探讨了基准数据泄露可能带来的其他风险:
3.1 对其他任务性能的负面影响
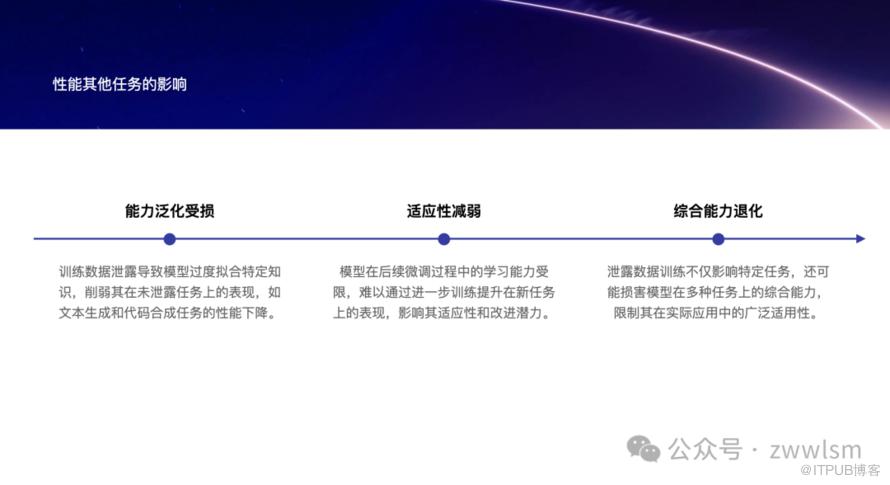
研究者选择了三个未包含在泄露数据中的任务来评估影响:
LAMBADA(语言建模任务) XSum(文本摘要任务) HumanEval(代码合成任务)
结果显示,在泄露数据上训练后,模型在这些任务上的性能普遍下降。例如:
| 模型 | 训练设置 | LAMBADA | XSum | HumanEval |
|---|---|---|---|---|
| LLaMA-2 (7B) | 无 | 68.20 | 8.67 | 26.83 |
| LLaMA-2 (7B) | +泄露 | 61.00 | 0.25 | 8.54 |
这表明,仅在泄露数据上训练可能会导致模型在其他常规任务上的性能下降。
3.2 降低模型的适应能力
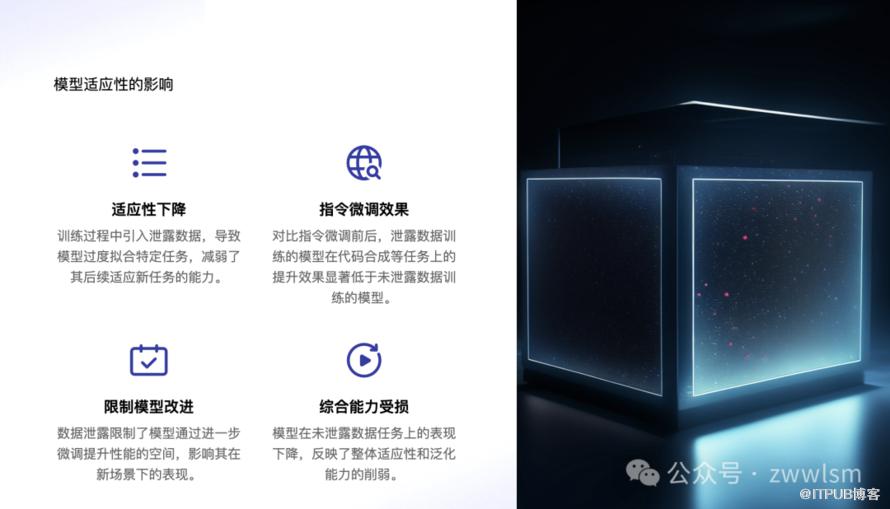
研究者还探讨了数据泄露对模型后续适应性的影响。他们使用Alpaca和CodeAlpaca数据集对模型进行指令微调,然后评估其性能。结果显示:
| 模型 | 训练设置 | LAMBADA | XSum | HumanEval |
|---|---|---|---|---|
| LLaMA-2 (7B) | +指令微调 | 60.30 | 8.64 | 28.66 |
| LLaMA-2 (7B) | +泄露+指令微调 | 53.60 | 8.55 | 20.73 |
这表明,在泄露数据上训练的模型在后续适应新任务时可能面临更大的困难。
4. 讨论与建议
基于研究发现,论文提出了以下建议:
4.1 通用建议
使用更广泛的、来源多样化的基准进行评估,以减轻数据污染风险。 除了评估高级能力(如推理和事实知识),也应该评估基本能力(如文本生成)。
4.2 对LLM开发者的建议
在预训练数据中进行严格的数据去污染检查,避免包含任何后续评估数据。 如果可能,建议也排除主流评估基准的训练数据。 报告潜在的数据污染风险和污染分析结果。 详细报告预训练数据的组成,特别是与主流评估基准相关的数据集。
4.3 对基准维护者的建议
提供构建基准的数据源详细信息,并进行与主流预训练语料库的污染分析。 要求每次提交都附带具体的污染分析报告。 提供多样化的测试提示,最终评估结果应该是多次运行的平均值。
5. 局限性与未来工作
本研究存在一些局限性:
未直接在预训练阶段引入数据泄露,而是在现有预训练模型上继续训练。 未探索更细粒度的数据泄露场景,如仅泄露不带标签的训练样本。 未计算主流基准与常用预训练数据集之间的污染程度。
未来工作可以focus在这些方向上,进行更系统、更全面的研究。
6. 结论
本研究深入探讨了大语言模型评估中的基准数据泄露问题,得出以下主要结论:
基准数据泄露会导致不公平和不可信的评估结果,即使是小型模型也可能因此获得显著的性能提升。 数据泄露不仅影响相关任务的性能,还可能对其他任务和模型的适应能力产生负面影响。 需要采取多项措施来改善现有评估基准的使用,包括更严格的数据检查、多样化的评估方法和透明的报告机制。
这项研究为公平、可靠地评估大语言模型提供了宝贵的见解和实用建议,对于推动LLM评估领域的发展具有重要意义。
论文原文:《Don’t Make Your LLM an Evaluation Benchmark Cheater》
原文作者:芝士AI吃鱼;如有侵权,请联系管理员删除。

