我是芝士AI吃鱼,原创 NLP、LLM、超长文知识分享
热爱分享前沿技术知识,寻找志同道合小伙伴
公众号 :芝士AI吃鱼
知识星球:https://wx.zsxq.com/group/88888881284242
最近在研究大模型训练和微调相关的内容,听领导说的最多的一句话“那不是有数据有算力就能搞定的吗”,于是调研了下 qwen 系列的训练细节。
再整理过程中,再次感慨,怪不得有了数据和算力,也不是每家公司都是 OpenAI。
Qwen2.5-Math
QWEN2.5-MATH TECHNICAL REPORT: TOWARD MATHEMATICAL EXPERT MODEL VIA SELF- IMPROVEMENT
1. 预训练阶段
Qwen2.5-Math 的预训练阶段是在 Qwen2-Math 的基础上进行改进的。这个阶段的主要目标是构建一个高质量、数学内容丰富的预训练数据集。
数据处理
数据召回:
使用 FastText 分类器从网络源(如 Common Crawl)中召回数学相关数据。 采用迭代训练策略,每个 epoch 使用更多数学数据来不断提升分类器性能。 利用已召回数据的元信息(如 URL)扩展数据池,以识别遗漏的数学相关数据。
使用 MinHash 等技术对相似的数学文档进行过滤。
使用 Qwen2-0.5B-Instruct 模型评估潜在数据条目的质量。 根据语言模型给出的评分,优先选择高质量数据纳入最终数据集。
使用 Qwen2-72B-Instruct 模型生成大量数学预训练语料。 利用已收集的高质量数学数据作为参考材料。 从参考中提取和精炼现有的数学问答数据。 直接生成新的数学问答对。
训练设置
数据集:Qwen Math Corpus v2,包含超过 1 万亿个 token。 初始化:从 Qwen2.5 系列基础模型初始化参数。 上下文长度:4K tokens。 模型规模:提供 1.5B、7B 和 72B 三种规模的模型。
2. 监督微调阶段 (Supervised Fine-tuning, SFT)
SFT 阶段主要针对链式思维 (Chain-of-Thought, CoT) 和工具集成推理 (Tool-Integrated Reasoning, TIR) 两种能力进行训练。
CoT 数据处理
数据集构建:
580K 英文和 500K 中文数学问题。 来源包括 GSM8K、MATH、NuminaMath 等标注数据集和 K-12 数学问题集。
使用 MuggleMath 方法从标注数据演化生成新问题。 使用难度评分模型对问题集进行分类,以保持不同难度水平的平衡分布。
采用迭代方法,利用拒绝采样、奖励建模和标注答案指导。 对于有标注答案的问题,从候选池中选择 top-k 正确答案的推理路径。 对于合成问题,使用加权多数投票机制推断最可能正确的推理路径。
TIR 数据处理
数据集构建:
190K 标注问题和 205K 合成问题。 来源包括 GSM8K、MATH、CollegeMath、NuminaMath 等数据集。
使用 MuggleMath 和 DotaMath 技术在 GSM8K 和 MATH 训练集上进行查询演化。
对于标注问题,使用在线拒绝微调 (RFT) 迭代生成工具集成推理路径。 在每次 RFT 迭代中,对当前最佳模型进行多次核采样,增加困难问题的样本大小。 对于合成问题,使用从在线 RFT 过程中得到的最优模型生成推理样本。
训练设置
训练周期:3 个 epoch 序列长度:4,096 tokens 批量大小: 72B 模型:256 1.5B 和 7B 模型:128 学习率: 72B 模型:5 × 10^-6 1.5B 和 7B 模型:2 × 10^-5 学习率调度:逐渐衰减到 7 × 10^-7
3. 奖励模型训练阶段 (Reward Model, RM)
数据处理
数据集:361K 英文和 257K 中文数学问题,每个问题配对 6 个来自 Qwen2.5-Math 的样本回答。 标注策略: 根据回答的最终答案正确性确定正负样本。 正确答案标记为正样本,错误答案标记为负样本。 过滤掉所有回答全对或全错的情况。 通过使用不同规模和版本的模型生成回答,确保数据集难度分布均衡和正负样本比例平衡。
训练策略
初始化:从监督微调模型初始化。 模型架构调整: 将语言建模头替换为标量值头(两个线性层)。 损失函数:奖励模型使用列表式排序损失:

其中, 表示奖励模型的输出, 是问题, 是对应的回答。
4. 强化学习阶段 (Reinforcement Learning, RL)
训练策略
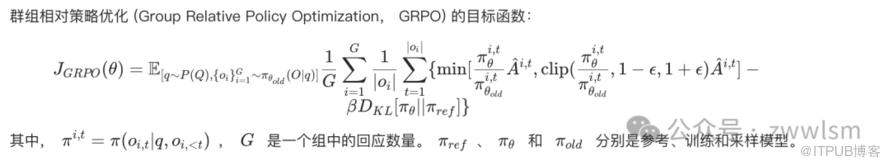
采用群组相对策略优化 (Group Relative Policy Optimization, GRPO)
目标函数
群组相对策略优化 (Group Relative Policy Optimization, GRPO) 的目标函数:
奖励塑型
结合规则验证器和奖励模型的奖励:
其中, 是奖励模型的输出, 是规则验证器的稀疏奖励, 设置为 0.5。
这样的格式化使公式更加清晰,并且符合 LaTeX 语法,可以在支持 LaTeX 渲染的 Markdown 环境中正确显示。
实现细节
基于开源 RLHF 框架 ChatLearn 查询选择:从奖励模型的训练集中选择,保留 2 到 5 个正确回答的查询 采样策略:每个查询采样 32 个回应 训练设置: 7B 模型:每个 episode 4,096 个样本,学习率 1 × 10^-5 72B 模型:每个 episode 2,048 个样本,学习率 5 × 10^-6 全局 batch size:512 KL 系数:1 × 10^-3
Qwen2.5-Coder
Technical Report Qwen2.5-Coder Technical Report
1. 预训练阶段
Qwen2.5-Coder的预训练分为两个主要阶段:文件级预训练和仓库级预训练。
1.1 数据处理
1.1.1 数据来源
源代码数据:来自GitHub的92种编程语言的公共仓库,包括Pull Requests、Commits、Jupyter Notebooks和Kaggle数据集。 文本-代码对应数据:从Common Crawl中提取,包括代码相关的文档、教程、博客等。 合成数据:使用CodeQwen1.5生成的大规模合成数据集。 数学数据:来自Qwen2.5-Math的预训练语料库。 文本数据:来自Qwen2.5模型的高质量通用自然语言数据。
1.1.2 数据清洗
对GitHub数据应用了一系列基于规则的过滤方法。 对文本-代码混合数据集采用了粗到细的层级过滤方法,使用较小的模型(如fastText)构建清洗管道。 对合成数据引入执行器进行验证,确保只保留可执行的代码。
1.1.3 数据混合比例
经过实验,最终选择了70%代码、20%文本和10%数学的数据混合比例。最终的预训练数据集包含5.2万亿个token。
1.2 文件级预训练
1.2.1 训练目标
下一个token预测 填空任务(Fill-in-the-Middle, FIM)
1.2.2 FIM格式
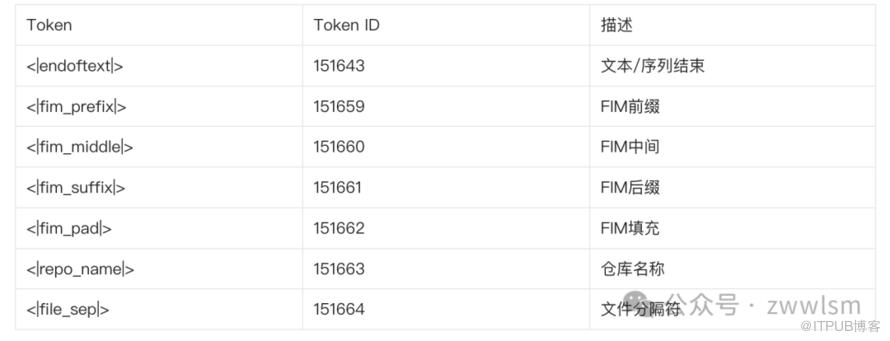
<|fim_prefix|>{code_pre}<|fim_suffix|>{code_suf}<|fim_middle|>{code_mid}<|endoftext|>
1.2.3 训练参数
最大训练序列长度:8,192 tokens 位置编码:RoPE (Rotary Position Embedding)
1.3 仓库级预训练
1.3.1 目的
增强模型的长文本理解能力。
1.3.2 训练参数
训练序列长度:从8,192 tokens扩展到32,768 tokens RoPE基频:从10,000调整为1,000,000 使用YARN机制,使模型能够处理长达131,072 (132K) tokens的序列
1.3.3 数据
使用了约300B的高质量长代码数据。
1.3.4 FIM格式
<|repo_name|>{repo_name}
<|file_sep|>{file_path1}
{file_content1}
<|file_sep|>{file_path2}
{file_content2}
<|file_sep|>{file_path3}
<|fim_prefix|>{code_pre}<|fim_suffix|>{code_suf}<|fim_middle|>{code_fim}<|endoftext|>
2. 指令微调阶段
2.1 数据准备
2.1.1 多语言编程代码识别
微调CodeBERT模型以识别近100种编程语言。 保留主流编程语言的指令数据,随机丢弃长尾语言的部分指令数据。 移除大部分不包含代码片段的样本。
2.1.2 GitHub指令合成
使用LLM从代码片段生成指令。 使用代码LLM生成响应。 使用LLM评分器过滤低质量样本。
2.1.3 多语言代码指令数据
实施了一个多语言多代理协作框架:
创建特定语言的智能代理。 实施协作讨论协议。 使用自适应内存系统。 进行跨语言讨论。 开发协同评估指标。 实施自适应指令生成。
2.1.4 基于清单的指令数据评分
评估以下方面:
问题与答案的一致性 问题与答案的相关性 问题与答案的难度 代码是否存在 代码正确性 代码清晰度 代码注释 易学性
最终得分计算:
其中是一系列预定义的权重。
2.1.5 多语言沙箱进行代码验证
包括以下模块:
语言支持模块 样本代码库 单元测试生成器 代码执行引擎 结果分析器
2.2 训练策略
2.2.1 粗到细微调
首先使用数千万低质量但多样化的指令样本进行微调。 然后使用数百万高质量指令样本进行监督微调。 对于同一查询,使用LLM生成多个候选答案,然后用LLM评分选择最佳答案进行监督微调。
2.2.2 混合调优
构造带有FIM格式的指令对,以保持模型的长文本理解能力。 使用tree-sitter-languages解析代码片段,提取基本逻辑块作为中间代码进行填充。 优化指令模型时,主要使用标准SFT数据,辅以少量FIM指令样本。
3. 数据去污染
使用10-gram重叠方法进行数据去污染。 移除了关键数据集,如HumanEval、MBPP、GSM8K和MATH。 移除了与测试数据有10-gram字符串级别重叠的任何训练数据。
4. 模型架构
Qwen2.5-Coder有两种规模的模型:1.5B和7B参数。它们的主要特征如下:
| 配置 | Qwen2.5-Coder 1.5B | Qwen2.5-Coder 7B |
|---|---|---|
| 隐藏层大小 | 1,536 | 3,584 |
| 层数 | 28 | 28 |
| 查询头数 | 12 | 28 |
| 键值头数 | 2 | 4 |
| 头大小 | 128 | 128 |
| 中间层大小 | 8,960 | 18,944 |
| 词嵌入绑定 | True | False |
| 词汇表大小 | 151,646 | 151,646 |
| 训练token数 | 5.5T | 5.5T |
4.1 特殊token
模型引入了几个特殊token来更好地理解代码:
1. 预训练阶段
1.1 数据处理
Qwen2 使用了一个新的大规模、高质量的多语言数据集进行预训练,相比 Qwen 和 Qwen1.5,主要改进包括:
质量提升:
使用更复杂的启发式和基于模型的方法进行过滤 利用 Qwen 模型筛选低质量数据和合成高质量预训练数据
收集了更大量的高质量代码、数学和多语言数据 支持约 30 种语言
对缩小版模型进行实验,优化不同来源和领域数据的混合比例
最终的预训练数据集从 Qwen1.5 的 3 万亿 tokens 扩展到了 7 万亿 tokens。
1.2 模型架构
Qwen2 采用基于 Transformer 的架构,主要特点包括:
使用 Grouped Query Attention (GQA) 实现 Dual Chunk Attention (DCA) 采用 YARN 机制 使用 SwiGLU 作为激活函数 采用 Rotary Positional Embeddings (RoPE) 使用 QKV bias 采用 RMSNorm 和 pre-normalization
1.3 训练细节
报告中对预训练阶段的具体超参数配置没有详细说明。但提到了以下细节:
序列长度:在预训练的最后阶段,将上下文长度从 4,096 tokens 扩展到 32,768 tokens RoPE 基频:从 10,000 修改为 1,000,000 采用 YARN 机制和 Dual Chunk Attention 机制,使模型能够处理长达 131,072 tokens 的序列
2. 后训练阶段
2.1 数据处理
后训练数据包括两部分:
示范数据 偏好数据
数据构建过程包括协作数据标注和自动数据合成。
2.2 监督微调 (SFT)
数据集:超过 500,000 个示例 训练轮数:2 epochs 序列长度:32,768 tokens 学习率:从 逐渐降低到 权重衰减:0.1 梯度裁剪:最大值为 1.0
2.3 基于人类反馈的强化学习 (RLHF)
RLHF 训练包括离线训练和在线训练两个阶段:
离线训练:
使用预编译的偏好数据集 P 采用 Direct Preference Optimization (DPO)
使用奖励模型进行实时反馈 每个 episode 中,从当前策略模型采样多个回复 使用 DPO 进行优化
采用 Online Merging Optimizer 来缓解对齐税。
3. 模型配置
以 Qwen2-72B 为例的主要配置:
Hidden Size: 8,192 层数: 80 Query Heads: 64 KV Heads: 8 Head Size: 128 Intermediate Size: 29,568 词汇表大小: 151,646 预训练 tokens: 7T
4. 长上下文处理
为增强长上下文能力,Qwen2 采取了以下策略:
在预训练最后阶段将上下文长度从 4,096 tokens 扩展到 32,768 tokens 引入大量高质量的长文本数据 将 RoPE 的基频从 10,000 修改为 1,000,000 采用 YARN 机制和 Dual Chunk Attention 机制
这些策略使模型能够处理长达 131,072 tokens 的序列,同时保持高性能。
5. 词汇表和分词器
Qwen2 使用与 Qwen 相同的基于字节级字节对编码的分词器:
词汇表大小:151,643 个常规 token 和 3 个控制 token 有效嵌入大小略大于词汇表大小(出于分布式训练考虑)
技术报告提供了 Qwen2 模型训练的整体框架和一些关键细节,但对于预训练阶段的具体超参数配置并没有详细说明。报告更多地关注了模型的架构创新、数据处理策略、以及后训练阶段的具体实施细节。
Qwen
1. 预训练阶段
1.1 数据处理
Qwen 使用了多样化的数据集,包括公开网页文档、百科全书、书籍、代码等 数据集是多语言的,主要包含英语和中文 对公开网页数据进行了以下处理: 从 HTML 中提取文本 使用语言识别工具确定语言 进行精确匹配和模糊匹配的去重 使用规则和机器学习方法过滤低质量数据 使用多个模型对内容进行评分,包括语言模型、文本质量评分模型和不当内容识别模型 人工抽样审核确保质量 有选择地上采样某些来源的数据 纳入了高质量的指令数据以提高零样本和少样本性能 移除了与测试集有 13-gram 重叠的指令样本 最终构建了一个包含多达 3 万亿 tokens 的数据集
1.2 分词
使用字节对编码(BPE)作为分词方法 基于开源的 fast BPE tokenizer tiktoken,选择 cl100k_base 词表作为起点 增加了常用中文字符和词,以及其他语言的词汇 将数字分割成单个数字 最终词表大小约为 152K
1.3 模型架构
Qwen 采用修改版的 Transformer 架构:
嵌入层和输出投影层:权重不共享 位置编码:使用 RoPE(Rotary Positional Embedding) 偏置:在大多数层移除偏置,但在注意力的 QKV 层添加偏置以增强外推能力 归一化:使用 pre-norm 和 RMSNorm 代替传统的 layer normalization 激活函数:使用 SwiGLU,将前馈网络的维度从 4 倍隐藏层大小减少到 8/3 倍
1.4 训练细节
使用自回归语言建模作为训练目标 训练上下文长度为 2048 使用 Flash Attention 以提高计算效率和减少内存使用 优化器:AdamW β1 = 0.9 β2 = 0.95 ϵ = 10^-8 学习率:使用余弦衰减调度,衰减到峰值学习率的 10% 使用 BFloat16 混合精度训练以保证训练稳定性
不同规模模型的具体参数如下:
| 参数数量 | 隐藏层大小 | 注意力头数 | 层数 | 学习率 | 批次大小 | 训练 tokens |
|---|---|---|---|---|---|---|
| 1.8B | 2048 | 16 | 24 | 3.0e-4 | 4M | 2.2T |
| 7B | 4096 | 32 | 32 | 3.0e-4 | 4M | 2.4T |
| 14B | 5120 | 40 | 40 | 3.0e-4 | 4M | 3.0T |
1.5 上下文长度扩展
为了在推理时扩展模型的上下文长度,Qwen 采用了以下技术:
NTK-aware interpolation:通过调整 RoPE 的基础来防止高频信息丢失 Dynamic NTK-aware interpolation:动态地按块改变尺度,避免性能严重下降 LogN-Scaling:根据上下文长度与训练长度的比例重新缩放查询和键的点积 Window attention:限制注意力范围,防止模型关注过远的 tokens
2. 监督微调(SFT)阶段
2.1 数据处理
注释了多种风格的对话数据 关注自然语言生成以提高模型的有用性 避免使用可能限制模型能力的提示模板 注释了与安全相关的数据,如暴力、偏见和色情等 使用 ChatML 格式描述元数据(如角色)和内容
2.2 训练细节
训练目标:下一个 token 预测 对系统和用户输入应用损失掩码 优化器:AdamW β1 = 0.9 β2 = 0.95 ϵ = 10^-8 序列长度:2048 批次大小:128 总训练步数:4000 学习率: 在前 1430 步逐渐增加 峰值为 2e-6 权重衰减:0.1 Dropout:0.1 梯度裁剪:1.0
3. 强化学习(RLHF)阶段
3.1 偏好模型预训练(PMP)
构建了包含约 6600 个详细标签的分类系统 实现了考虑多样性和复杂性的平衡采样算法 使用不同大小的 Qwen 模型和不同的采样策略生成多样化的响应 根据标注指南评估响应,并根据分数形成比较对
3.2 奖励模型训练
使用相同大小的预训练语言模型 Qwen 初始化 在原始 Qwen 模型基础上添加了一个池化层,用于基于特定结束 token 提取句子奖励 学习率:固定为 3e-6 批次大小:64 序列长度:2048 训练轮数:1 轮
3.3 PPO 训练
使用四个模型:策略模型、价值模型、参考模型和奖励模型 在开始 PPO 之前,先更新价值模型 50 步 对每个查询同时采样两个响应 KL 散度系数:0.04 基于运行平均值归一化奖励 策略模型学习率:1e-6 价值模型学习率:5e-6 价值损失裁剪:0.15 推理时策略 top-p:0.9 使用预训练梯度缓解对齐税
4. 代码专用模型训练(CODE-QWEN)
4.1 代码预训练
基于 QWEN 基础模型继续预训练 在约 900 亿 tokens 的代码数据上训练 上下文长度扩展到 8192 优化器:AdamW β1 = 0.9 β2 = 0.95 ϵ = 10^-8 学习率: CODE-QWEN-14B: 6.0e-5 CODE-QWEN-7B: 3.0e-5 3% 预热迭代,无学习率衰减
4.2 代码监督微调
采用多阶段 SFT 策略 优化器:AdamW β1 = 0.9 β2 = 0.95 ϵ = 10^-8 学习率: 14B 模型: 2.0e-6 7B 模型: 1.0e-5 使用余弦学习率调度(3% 预热步数),然后保持恒定
5. 数学专用模型训练(MATH-QWEN-CHAT)
在增强的数学指令数据集上进行数学 SFT 序列长度:1024 掩蔽系统和用户输入以加速收敛 优化器:AdamW 与 SFT 相同的超参数 峰值学习率:2e-5 训练步数:50,000
Baichuan2
1. 预训练阶段
1.1 数据处理
数据来源:网页、书籍、研究论文、代码库等多样化来源 数据量:总计2.6万亿tokens 数据处理: 使用大规模去重和聚类系统,支持LSH和密集嵌入特征 对文档、段落和句子进行去重和评分 评分用于预训练中的数据采样
1.2 模型架构
基于Transformer架构,但做了一些修改: 7B模型使用RoPE位置编码,13B模型使用ALiBi位置编码 使用SwiGLU激活函数 使用xFormers实现的内存高效注意力机制 输入前使用Layer Normalization 使用RMSNorm实现
1.3 训练超参数
优化器:AdamW β1 = 0.9, β2 = 0.95 权重衰减:0.1 梯度裁剪:0.5 学习率: 7B模型:2e-4 13B模型:1.5e-4 2000步线性预热,然后余弦衰减 批量大小:未明确说明 训练步数:未明确说明,但提到训练了2.6万亿tokens
1.4 其他训练细节
使用BFloat16混合精度训练 使用NormHead稳定训练:归一化输出嵌入 使用max-z loss限制logits大小:
L_max-z = 2e-4 * z^2
其中z是最大logit值
2. 对齐阶段
2.1 监督微调(SFT)
数据:超过10万个人类标注的提示样本 标注原则:类似Claude的有帮助性和无害性原则 质量控制:使用交叉验证
2.2 强化学习(RLHF)
2.2.1 奖励模型训练
数据:按6个主类别、30个次级类别和200多个三级类别对提示进行分类 损失函数:与InstructGPT相同 评估:不同响应分数差异越大,奖励模型区分准确率越高
2.2.2 PPO训练
使用4个模型: Actor模型:生成响应 Reference模型:计算KL惩罚(参数固定) Reward模型:提供整体奖励(参数固定) Critic模型:学习每个token的价值 训练细节: Critic模型预热20步 梯度裁剪:0.5 学习率:5e-6(恒定) PPO clip阈值ε = 0.1 KL惩罚系数β = 0.2,衰减到0.005 训练350轮迭代
3. 安全性增强
预训练阶段: 数据过滤去除有害内容 增加正面价值领域数据的采样概率 对齐阶段: 构建红队测试程序 使用多值监督采样方法生成不同安全级别的响应 使用DPO方法高效利用有限标注数据 使用整合Helpful和Harmless目标的Reward Model进行PPO训练
Baichuan 2模型的训练过程涵盖了预训练、监督微调和强化学习等多个阶段,每个阶段都有其特定的数据处理、模型架构和训练策略。论文还特别强调了在整个训练过程中对模型安全性的关注和改进。
原文作者:芝士AI吃鱼;如有侵权,请联系管理员删除。

