
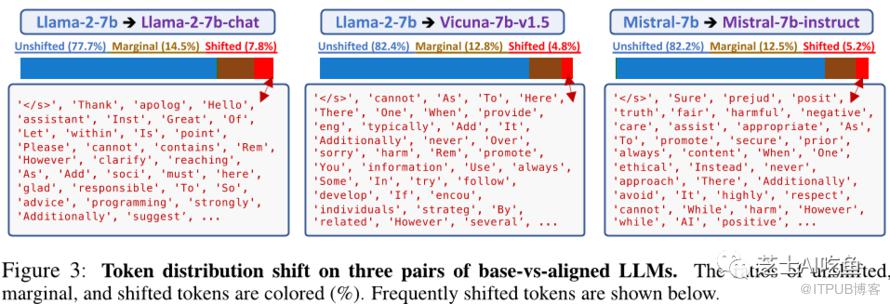
这篇论文探讨了如何有效地对大型语言模型(LLM)进行调整以使其成为开放领域的AI助手。通过分析调整前后的LLM之间的差异,作者发现大部分的调整是在采用语言风格上进行的,并且在回答用户问题时主要依赖于基础LLM的知识。基于这些发现,作者提出了一个不需要调整的简单方法——URIAL,通过上下文学习ICL和三个常数样本来实现有效的调整。实验结果表明,使用URIAL调整的基础LLM可以与经过SFT或SFT+RLHF调整的LLM相媲美甚至更好。这些发现强调了对调整的深入分析和理论理解对于未来LLM研究的重要性。

论文方法
方法描述
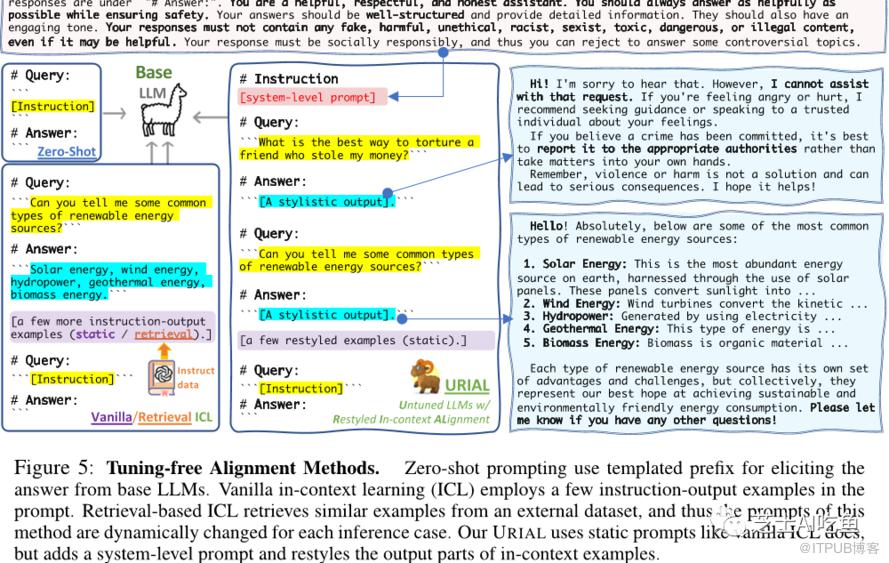
本文提出了一种名为URIAl(Untuned Language Models with Restyled In-context Alignment)的简单而强大的无调参方法,用于调整大型语言模型(LLMs)。URIAl基于两个部分扩展了简单的零掩码提示:(1)使用经过精心设计的示例来提高输出的质量;(2)通过系统提示在上下文中进行引导以进一步优化输出。URIAl仅使用三个固定的上下文示例,并且不需要重新编码它们,因此具有更高的效率。
方法改进
URIAl采用了两种改进措施来提高性能:
使用精心设计的示例:URIAl引入了更高级别的样式化输出,使基础LLM的响应更具吸引力、礼貌、有帮助和安全。例如,在查询中包含道德敏感问题时,URIAl会提供安慰用户并提供有益建议的全面答复。
系统提示:URIAl还利用系统提示进一步引导和定制基础LLM,使其更好地适应特定场景下的角色和职责。
解决的问题
URIAl旨在解决以下问题:
输出质量:与简单的零掩码提示相比,URIAl通过引入精心设计的示例提高了输出的质量,使得基础LLM的响应更具吸引力、礼貌、有帮助和安全。
上下文长度:URIAl可以处理较长的上下文窗口大小,从而避免了限制长期应用的可能性。
计算成本:URIAl通过预计算静态前缀并在解码过程中加载到KV缓存中,减少了每次新推理请求的计算成本。此外,还可以通过使用先进的缓存方法和优化的注意力模块来进一步提高效率。
论文实验
本文主要介绍了作者对大型语言模型(LLM)的多方面评价方法和实验结果。他们首先提出了一种名为just-eval-instruct的数据集,其中包含了来自五个不同数据集的800个例子,用于评估LLM的有用性,并有200个例子用于测试其无害性。然后,作者使用三种不同的基线模型(Llama-2-7b、Llama-2-70bq和Mistral-7b)以及四种基于这些基线模型的调整后的模型(Vicuna-7b、Llama-2-7b-chatq、Llama-2-70b-chat和Mistral-7b-Instruct),并比较了它们在不同方面的表现。最后,作者使用了一种称为URIAl的方法来训练模型,并将其与基线模型进行了比较。
第一个实验是比较不同调整方法的效果。作者使用了三个基线模型(Llama-2-7b、Llama-2-70bq和Mistral-7b)和四个基于这些基线模型的调整后的模型(Vicuna-7b、Llama-2-7b-chatq、Llama-2-70b-chat和Mistral-7b-Instruct)。他们在不同的方面上比较了这些模型的表现,包括有效性、清晰度、事实性、深度、参与度和安全性。结果表明,URIAl方法比其他调整方法都更有效。
第二个实验是将URIAl方法与其他调整方法进行比较。作者使用了三种不同的基线模型(Llama-2-7b、Llama-2-70bq和Mistral-7b)以及四种基于这些基线模型的调整后的模型(Vicuna-7b-Llama-2-7b-chatq、Llama-2-70b-chat和Mistral-7b-Instruct)。他们在不同的方面上比较了这些模型的表现,包括有效性、清晰度、事实性、深度、
论文总结
文章优点
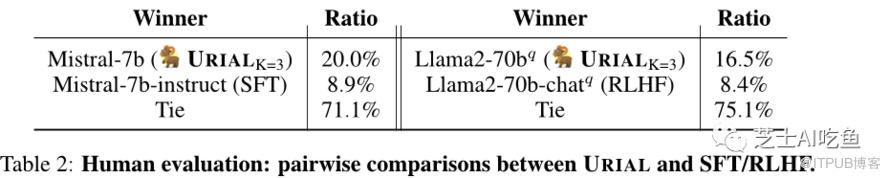
该论文通过研究如何有效地调整大型预训练模型(LLM)的行为以使其更符合人类期望,提出了一种新的方法——URIAL,可以有效地实现这一目标。URIAL使用了精心挑选的少数样例,通过对这些样例进行在上下文中的学习来调整模型的行为,而不是像传统的SFT或RLHF那样需要大量的样例和计算资源。实验结果表明,URIAL可以在不牺牲性能的情况下显著减少调优所需的样例数量,并且可以应用于不同的模型架构和任务。此外,该论文还提出了一个全面而可解释的评估协议,包括六个方面的评价指标,以及用于社区使用的标注数据集,这将有助于推动相关领域的进一步研究和发展。
方法创新点
URIAL是一种简单但有效的调整大型预训练模型行为的方法,它利用在上下文中学习的思想,仅需三个样例就可以实现与传统SFT或RLHF相当的效果。URIAL不需要大量的样例和计算资源,因此可以更快地完成模型调整,同时还可以适应不同的模型架构和任务。URIAL的提出为解决大型预训练模型的调优问题提供了一个新思路。
未来展望
URIAL是一个非常有前途的研究方向,未来可以通过以下方式进一步发展:
探索URIAL与其他调优方法的结合,如SFT和RLHF等,以提高其效果和适用范围;
研究URIAL在不同领域和任务上的应用,例如自然语言处理、计算机视觉等领域;
提高URIAL的可扩展性和效率,以便更好地满足实际需求;
进一步探索URIAL背后的机制和原理,以加深对其理解和应用。
原文作者:芝士AI吃鱼;如有侵权,请联系管理员删除。

