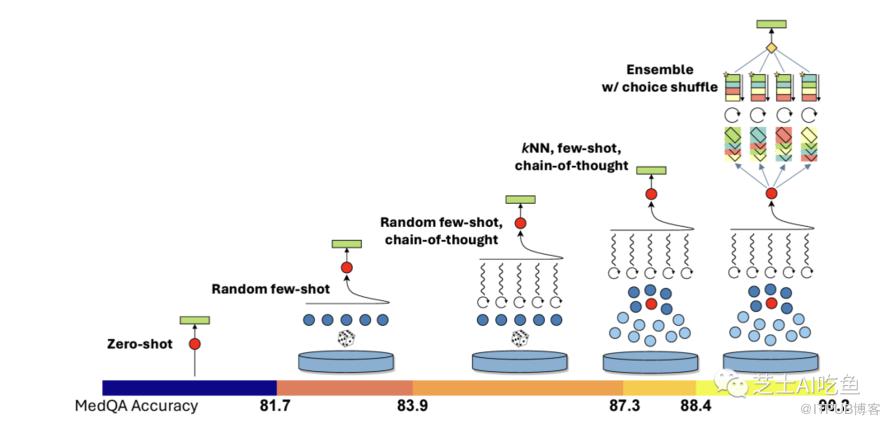
这篇论文探讨了通用模型在医学领域的应用能力,并通过系统性的探索和实验设计证明了通用模型在特定任务中的表现可以超过专门训练过的模型。作者使用了多种提示策略来提高模型性能,并提出了一个名为Medprompt的方法,该方法可以在不依赖专家知识的情况下显著提高模型的表现。Medprompt在九个基准数据集上取得了最先进的结果,并且比最好的专业模型Med-PaLM 2的错误率降低了27%。此外,Medprompt还展示了在其他领域(如电气工程、机器学习等)的广泛适用性。这些发现表明,通用模型可以通过创新的提示策略实现更深入的专业能力,并具有超越专门训练过的模型的潜力。
论文方法
方法描述
本文提出的Medprompt方法是一种基于GPT-4的自动CoT演示生成技术,用于在医疗领域中帮助模型更好地解决复杂问题。该方法包括以下关键概念:
In-Context Learning(ICL):这是一种基础模型的关键能力,允许模型仅通过几个任务示例就能解决新任务。
Chain of Thought(CoT):这是一种提示方法论,它在引入样本答案之前使用中间推理步骤。通过将复杂问题分解为一系列较小的步骤,CoT被认为有助于基础模型生成更准确的答案。
Ensembling:这是一种结合多个模型运行输出以获得更稳健或准确结果的技术。Ensembling方法使用诸如平均、共识或多数投票等函数来合并单独的输出。
方法改进
Medprompt方法主要改进了传统的CoT提示方法,通过使用ICL和Ensembling技术,实现了更加高效和自动生成CoT演示的能力。具体来说,Medprompt方法通过提供[question, correct answer]对从训练数据集中自动学习CoT提示,使得GPT-4能够自主地生成高质量、详细的CoT提示,即使对于最复杂的医学挑战也是如此。
此外,Medprompt方法还采用了Ensembling技术,通过重新排列或洗牌少量提示组件,解决了基础模型常见的顺序敏感性问题,从而提高了鲁棒性。
解决的问题
Medprompt方法的主要目标是在医疗领域中提高GPT-4的基础模型性能,特别是在处理复杂问题时。传统的CoT提示方法需要人类专家制定CoT提示,而Medprompt方法通过自动化生成CoT提示,消除了这一限制,并且在实验中表现出色。此外,Medprompt方法还通过Ensembling技术进一步增强了模型的性能和鲁棒性。
论文实验
本文主要介绍了在医疗领域中使用 GPT-4 进行多选题自动答题的实验研究。首先,文章对数据集进行了描述,并给出了测试方法的设计。然后,文章介绍了 Medprompt 算法的设计和组成部分。最后,文章展示了 Medprompt 在不同数据集上的表现,并与其他算法进行了比较。
具体来说,在实验部分,作者使用了九个医疗领域的多选题数据集作为基准数据集,其中包括 MedQA、MedMCQA、PubMedQA、MMLU 等。这些数据集涵盖了医学、药学、心理学等多个学科领域的问题。作者采用了随机划分的方法将每个数据集分为训练集和测试集,以避免过拟合的风险。同时,为了进一步验证 Medprompt 的泛化能力,作者还将其应用于六个不同的数据集中,包括工程、机器学习、哲学、会计、法律等领域的挑战问题。
对于 Medprompt 算法的性能评估,作者采用了准确率(Accuracy)这一指标来衡量其效果。结果显示,Medprompt 在各个数据集上均取得了较高的准确率,且相对于其他算法具有显著的优势。例如,在 MedQA 数据集上,Medprompt 相比于其他算法的准确率提高了约 5% 左右。此外,作者还通过与零样本提示(Zero-Shot Prompting)和五样本提示(Five-Shot Prompting)的比较,证明了 Medprompt 的优越性。
总之,本文通过对 GPT-4 在医疗领域中的应用进行实验证明了其在多选题自动答题方面的潜力。该算法不仅在医疗领域表现出色,而且具有较强的泛化能力,可以应用于多个学科领域的问题解答。这对于提高自然语言处理技术在实际应用中的效率和准确性具有重要意义。
论文总结
文章优点
该研究通过系统性的提示工程来引导通用型基础模型GPT-4在医疗挑战问题上发挥出专家级能力。
研究采用了多种提示策略,并对其进行了综合比较,发现了Medprompt是最佳的提示策略之一。
研究还探索了GPT-4自主创作链式思维提示的能力,并将其与手工制作的专家提示进行了比较。
研究结果表明,Medprompt可以显著提高GPT-4在医疗问答数据集上的准确率,超越了目前最好的模型。
研究还展示了Medprompt在其他领域的应用潜力,包括电气工程、机器学习、哲学、会计、法律、护理和临床心理学等领域。
方法创新点
该研究采用了多种提示策略,并对其进行了综合比较,以找到最佳的提示策略。
研究还探索了GPT-4自主创作链式思维提示的能力,并将其与手工制作的专家提示进行了比较。
研究中采用了眼睛离线评估案例库的方法,避免了过拟合的问题。
未来展望
研究认为,进一步研究GPT-4反思和创作少样本示例的能力,并将这些示例编织成提示,可以释放通用型基础模型在各个领域中的专业能力。
研究建议,除了探索提示工程外,还可以继续研究针对参数更新的基础模型微调等方法,以释放其在高风险领域的潜力。
研究认为,应该谨慎地探索这两种方法,以实现通用型基础模型的最大化利用。
原文作者:芝士AI吃鱼;如有侵权,请联系管理员删除。

