原文参考:https://openai.com/research/weak-to-strong-generalization
在未来的超级人工智能系统(即超级对齐)中,一个核心挑战是人类需要监督比他们更智能的AI系统。我们研究了一个简单的类比:小型模型能否监督大型模型?我们发现,可以使用一个类似GPT-2水平的模型来引发GPT-4的大部分能力——接近GPT-3.5水平的表现——即使在小型模型失败的难题上也能正确概括。这为我们直接解决未来超级人工智能模型对齐的中心挑战提供了一个新的研究方向,同时也让我们在当前就可以取得阶段性的实证进展。
超级对齐问题
我们认为,在未来十年内可能会开发出远超人类智能的人工智能。然而,我们仍然不知道如何可靠地引导和控制超人类AI系统。解决这个问题对于确保未来最先进的AI系统对人类保持安全和有益至关重要。
今年早些时候,我们成立了超级对齐团队来解决超级智能对齐的问题。今天,我们发布了该团队的首篇论文,介绍了一个用于实证对齐超人类模型的新研究方向。
当前的对齐方法,如基于人类反馈的强化学习(RLHF),依赖于人类监督。然而,未来的AI系统将能够实现极其复杂和创造性的行为,这将使得人类难以可靠地监督它们。例如,超人类模型可能能够编写数百万行新颖且潜在危险的计算机代码,即使是专业人士也很难理解。
相对于超人类AI模型,人类将成为“弱监督者”。这是人工通用智能(AGI)对齐的一个核心挑战:弱监督者如何信任并控制更强大的模型?
我们的设置
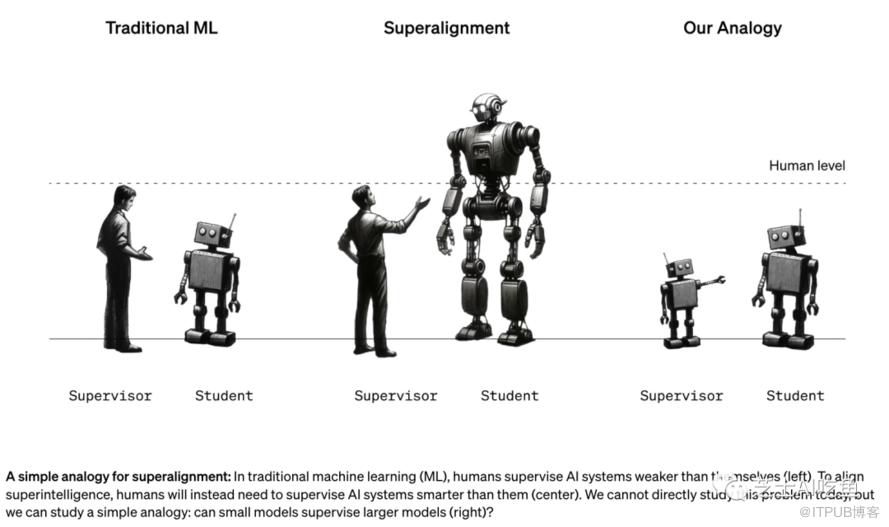
为了在这个核心挑战上取得进展,我们提出了一个我们今天可以实证研究的类比:我们能否使用一个较小(能力较弱)的模型来监督一个较大(能力更强)的模型?
超级对齐简单类比:在传统的机器学习(ML)中,人类监督比自己弱的AI系统(左)。为了对齐超级智能,人类将需要监督比他们更智能的AI系统(中)。我们今天无法直接研究这个问题,但我们可以研究一个简单的类比:小型模型能否监督大型模型(右)?
天真地,我们可能不会期望一个强大的模型比提供其训练信号的弱监督者表现更好——它可能只是学会模仿弱监督者所犯的所有错误。另一方面,强大的预训练模型具有出色的原始能力——我们不需要从头开始教它们新任务,我们只需要引发它们潜在的知识。关键问题是:强大的模型是否会根据弱监督者的潜在意图进行概括——即使在弱监督者只能提供不完整或有缺陷的训练标签的困难问题上,也能利用其全部能力解决任务?
我们的结果

我们使用一个类似GPT-2
水平的模型作为弱监督者对GPT-4进行微调。在NLP基准测试中,我们可以显著改善概括性能。我们使用了一种简单的方法,鼓励强大的模型更加自信——包括在必要时自信地反对弱监督者。当我们使用这种方法让GPT-2级别的模型监督GPT-4在NLP任务上时,结果模型的表现通常介于GPT-3和GPT-3.5之间。我们能够在只有更弱监督的情况下恢复GPT-4的大部分能力。
这种方法是一个概念验证,具有重要的局限性;例如,它仍然不适用于ChatGPT偏好数据。然而,我们还发现了其他方法的生机,例如最优早停和从小型到中型再到大型模型的引导。
总的来说,我们的结果表明:(1)天真的人类监督——例如基于人类反馈的强化学习(RLHF)——可能无法很好地扩展到超人类模型,需要进一步工作,但(2)显著改善弱到强概括是可行的。
研究机会
在我们当前的实证设置和最终对齐超人类模型的问题之间仍然存在重要的不同之处。例如,未来模型模仿弱人类错误可能比当前强模型模仿当前弱模型错误更容易,这可能会使未来的概括变得更加困难。
尽管如此,我们相信我们的设置捕捉到了对齐未来超人类模型的一些关键难点,使我们能够开始在今天对这个问题进行实证进展。未来工作的许多有前景的方向包括修正我们设置中的不同之处、开发更好的可扩展方法,以及提高我们对何时以及如何应该期望良好的弱到强概括的科学理解。
我们认为这是机器学习研究社区取得对齐进展的一个激动人心的机会。为了在这一领域开展更多研究,
我们正在发布开源代码,方便今天开始进行弱到强概括实验。
我们正在启动一个价值1000万美元的补助计划,用于资助研究生、学者和其他研究人员从事广泛的超人类AI对齐工作。我们特别期待支持与弱到强概括相关的研究。
弄清楚如何对齐未来的超人类AI系统以确保安全从未如此重要,而且现在比以往任何时候都更容易在这个问题上取得实证进展。我们期待看到研究人员发现的突破。
原文作者:芝士AI吃鱼;如有侵权,请联系管理员删除。

