在上一篇文章《1.Spark 简介》中我们了解了Spark是分布式的内存计算引擎,本篇我们就来初窥Spark核心原理。本篇我们来初窥下Spark的核心原理。
一、Spark中常用名词解释
Driver Program
顾名思义,Driver Program是整个Application运行驱动者,其运行Application的main()函数并且创建SparkContext,当Executor部分运行完毕后,Driver负责将SparkContext关闭
Spark Context
Spark Context 是Driver的核心,可以理解成Spark的入口,对于Spark来说相当重要,在Spark中由SparkContext负责和ClusterManager通信,进行资源的申请、任务的分配和监控等,通俗来讲记录了整个Application 要做什么,找谁做,怎么做。
Cluster Manager
Cluster Manager是集群资源管理的一个抽象,在Spark2.3版本下,有Yarn、Mesos、Standalone、k8s、Local的几种选型,无论是哪一种资源管理方式都会为Application提供资源。
Worker Node
集群中任何可以运行Application代码的节点,类似于YARN的nodemanager节点,在Standalone模式中指的是Slave文件配置的Worker节点,在Spark on Yarn模式中指的是nodemanager节点。
Executor
Executer是Application运行在Worker Node上的进程,该进程负责运行Task,并负责将数据存在内存或者磁盘上,每个Application都会独自拥有一个或者多个Executor进程。Excutor运行在JVM中,并通过线程池的方式,多线程并行运行Task (Task暂时可以理解成拆分后的小部分数据,可以类比成MapReduce的MapTask和ReduceTask)。
二、Application执行流程
Spark中Application的概念和MapReduce中的概念类似,这里指的用户编写的Spark程序。
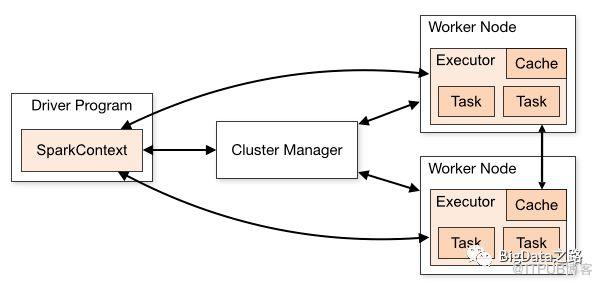
我们来看下通用架构中Spark的任务是如何提交的?
用户通过SparkContext提供的Api编写程序(即使使用其他Spark的API,其内部也是对SparkContext进行了封装),提交任务。
根据设置deploy-mode的不同,会在本地或者某一个worker节点首先占用一份资源,启动Driver进程。
Driver进程中,会初始化SparkContext,SparkContext通过RpcEnv向Cluster Manager注册 Application,并告知Cluster Manager执行Application所需要的资源(cpu 、memory)数量。
Cluster Manager 会通知Spark Context 注册成功,并返回Applicatoin id。
Cluster Manager 在对应的worker(根据Cluster Manager类型的不同,worker对应的类型也不同)节点上,分配Excutor资源,并且在Worker上启动CoarseGrainedExecutorBackend进程(该进程内部将创建Executor)。
-
Excutor会通过RpcEnv向Driver注册所有Excutor的信息。
注意点:
每个Application获取到它自己的 Executor 进程后,直到整个Application的生命周期结束才消亡,并且始终多线程运行 Task。这样做的优点是把App互相隔离,在调度方面(每个 driver 调度它自己的 task)和 Executor 方面(不同应用的 task 运行在不同的 JVM 中,以实现资源隔离)。与此同时,这也意味着若是不把数据写到外部的存储系统中的话,数据就不能够被不同的 Spark 应用(SparkContext 的实例)所共享。
默认的分配资源的方式是粗粒度的。如果没有任何Job,只完成上述过程,是有实际的资源分配的,默认情况下,虽然没有job计算,只要提交了程序并注册了,就会分配资源(如spark-shell)。
通常情况下一个Driver只会有一个SparkContext实例,但可通过spark.driver.allowMultipleContexts配置来允许driver中存在多个SparkContext实例
至此为止Spark提交任务的一个基础环境就此完成。接下来的Application执行,会放在下一篇讲解。
如有疑问,可随时联系我或公众号留言。
你的关注,是我的动力~
推荐关注BigData之路,第一时间,分享更多干货,欢迎关注和转发。
原文作者:BigData之路;如有侵权,请联系管理员删除。

