在《Spark 核心原理结构(一)》中我们讲解了Spark的基本架构,介绍了Spark环境常用的专属名词,并且勾画了Spark的基础运行环境,本节我们就来了解下Spark的任务调度。
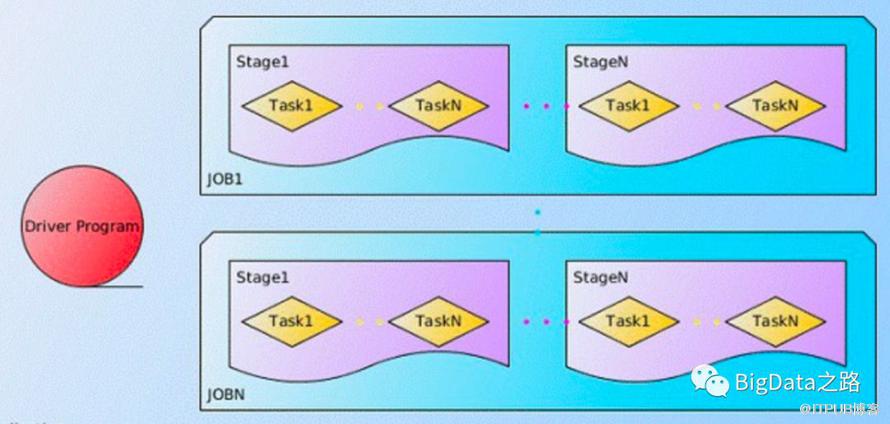
上图为Spark Application的组成简图。
一、任务调度名词解释
RDD
RDD是Resillient Distributed Dataset的缩写。其意为“弹性分布式数据集”,是Apache Spark中数据的核心抽象,这里我们暂时将其理解为,它是一种弹性的、只读的、分区的数据集合。本篇中所涉及的RDD的概念会使用通俗易懂的语言描述,尽量让大家好理解,详细内容会在后面文章中进行讲解。
Job
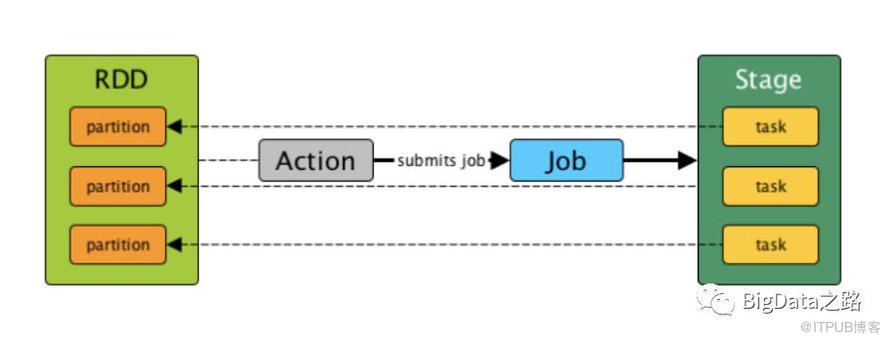
通常一个Application会由一个或者多个Job组成,Job的数量是根据RDD的Action类型的操作数量所决定。Action是针对RDD这种数据集合的操作,由于RDD有Lazy的特性(惰性),只有在某些特定操作才可以触发整个数据集(RDD)的处理(可以类比成python中 yield的用法,需要在循环中再次执行到这一步,才可以触发继续执行。或者类比成redis中的惰性删除,对于超过ttl的过期key,只有再次被读写的时候,才会触发删除)。因此每次Action类型的操作相当于触发执行条件,一旦RDD进行Action操作,整个RDD Action之前的操作才会执行。我们可以理解成Action操作和Job是一对一的关系。
Stage
每个Job由一个或者多个Stage所组成,Stage有非最终的Stage(Shuffle Map Stage)和最终的Stage(Result Stage)两种。Stage的划分依据是根据RDD间的依赖关系所决定。RDD之间的关系和B-Tree有一些相似,也有父子关系,只不过不是树状结构。RDD的父子关系有一对一和一对多两种,Spark会把一对一的父子RDD划分到一个Stage中,而Stage之间就是一对多关系的父子RDD。
Task
其概念很像MapReduce中的MapTask和ReduceTask,是运行Application的最小单位,在Spark中每个Stage由一个或者多个task所组成。真正被送到某个Executor上的工作单元,上面有提到每个RDD会有分区的,在Executor上对RDD每一个分区的处理就对应一个Task。
最后用一幅图,总结一下Job,Stage和Task的关系。
二、任务调度
在解释了Spark的基本任务术语后,再结合上一篇讲的内容。我们再来思考一下,暂时不考虑Spark透明的Cluster Manager选型和将数据Cache到内存的任务执行方式,Spark比MapReduce快在哪里呢?我们先来对比一下Spark和MapReduce的架构。
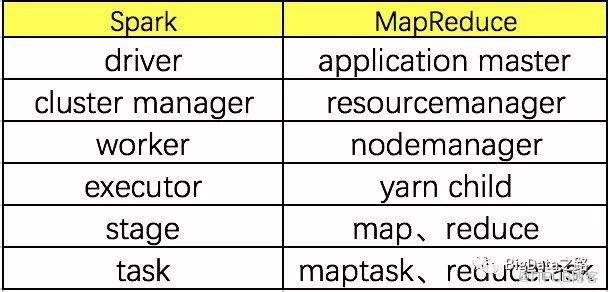
这样看来Spark架构似乎和传统的MapReduce并没有其他区别。相比MapReduce来说,Spark速度更快还有另一个比较重要的原因,那就是Spark的任务调度机制。接下来我们就来详细讲一讲任务调度机制。

上图为任务调度的总体图,大家可以根据图示,再对照一下面每一步过程的描述。
名词解释中我们提到RDD在Action操作之前,会进行一系列数据处理,如下图所示,就是一个较为简单的数据处理过程,从RDD1 经过多次处理操作最终变化为RDDn,每次处理操作都对应了一个新的RDD,直到被Action操作所触发执行。我们称这样的RDD转化过程称为RDD lineage,也可以叫做RDD的血缘关系,这样无论其中任何一个RDD因为意外丢失了,都可以通过RDD lineage重新计算得到,这也就实现了Spark任务容错的特性。
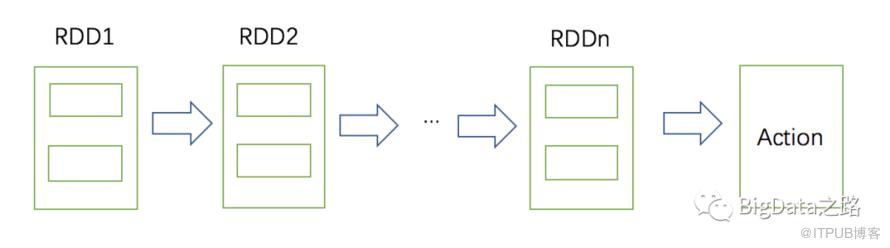
血缘关系(RDD lineage)其实是一个逻辑执行计划,如何将其转变Spark能理解的物理执行计划呢?这里就引入了Spark Context中的重要角色DAGScheduler,它的工作职责就是将RDD lineage转化为Stage/Task。
一旦RDD被Action类型操作所触发,DAGScheduler就会根据逻辑执行计划生成一个Job,然后根据RDD之间的依赖关系(父子RDD一对一或者一对多的关系)将RDD lineage,划分成不同Stages,形成有向无环图DAG(Apache Tez实际也是通过形成DAG去优化呆板的MapReduce模型),Stage之间也是有父子关系的,DAGScheduler会根据顺序来提交Stage,从执行的角度来讲,一个Stage的parent Stage(如果存在的话)执行完以后,该Stage才会被执行,最后一个执行的Stage就是最终产生结果的Stage,我们把他称为ResultStage,而其余的Stage叫做ShuffleMapStage。DAGScheduler在提交Stage的时候,会根据Stage的类型生成对应类型的Task(ResultTask/ShuffleMapTask),然后将一个Stage中的Tasks封装成一个TaskSet提交到后其他角色上,至此为止DAGScheduler的工作就完成了。
接下来接手工作的是Spark Context另一个比较多重要的角色TaskScheduler,它的作用是task的调度管理。
这里有分成两个部分TaskScheduler通过TaskSetManager维护了所有通过DAGScheduler封装过Taskset,并且通过不同的调度模式(FIFO或者FAIR,默认为FIFO),将TaskSetManager添加到调度池中。紧接着TaskScheduler会根据Cluster Manager的不同(local、standalone、yarn、mesos、k8s),在driver中启动对应的SchedulerBackend进程,并告知Driver。由于Driver上注册了所有Excutor的信息,因此会根据资源使用情况,将每个TaskSetManager分解成多个TaskDescriptions(其实就是task信息),通过SchedulerBackend,将调度池中维护的Task发往各个work节点上ExecutorBackend所创建的Executor进程中。最后在Executor中多线程运行Task,直到Task执行完成,释放资源。
本篇讲述了Spark的任务调度,相对上一篇Spark运行环境的讲解来说相对复杂一些,希望大家能静下心来,慢慢阅读。
如有疑问,可公众号留言和微信联系
推荐关注BigData之路。第一时间,分享更多干货,BigData之路与你共同成长,欢迎关注和转发。

原文作者:BigData之路;如有侵权,请联系管理员删除。

