源头
上上周有一个读者问我,数据库架构设计到底是啥?
结合职业生涯中做过DBA,并且这几年也在持续关注数据库,果断安排!
无奈前一阵持续高烧6、7天,感觉大脑处于空转状态
这周好转以后,开始搞起!
数据库设计要设计啥?
只要涉及到业务肯定都会需要
依据业务模式,设计库结构、表结构 依据访问模式,设计索引结构
这里值得一提的是,关于库表设计有些公司会交给DBA来负责,并优化读写
其实这一部分更需要业务工程师和业务架构师来进行
因为无论是库、表还是索引结构都和业务的架构设计息息相关
那除了库表、索引结构还需要设计什么?
一般理解下设计了库表、索引就不影响业务开发了,真的是这样吗?
随着数据上涨,在高可用容灾、读写性能、一致性、扩展性等多个方面都会面临着瓶颈
这更应该是数据库设计中尤为关注的
高可用
现在的业务架构中,基本都会做集群,这时候业务层解决了单点异常的问题
但此时数据库挂了影响会进一步放大,尤其产生堆积以后,恢复时间会拉长
读性能
数据库和大数据架构的访问模式类似,都是读多写少
读请求一般对应着业务的搜索,爬虫,浏览、列表,详情
写请求一般对应加减、核销库存,付款,下单
根据绝大部分互联网业务的经验,数据库往往最先成为系统的瓶颈
而在数据库的读和写上,往往读会率先成为瓶颈点
如果为了增加数据库的读性能
无论是加从库,加缓存还是其他方式,在业务的架构设计时,需要考虑这点
一致性
刚才提到了,加从库增加数据库读请求的上限
但是增加了从库后,可能会导致延迟增加,造成主从数据的不一致
加缓存也是一样,在正常读库之前增加了缓存层
但会导致缓存和数据库数据不一致
因此做数据库冗余、做缓存高可用,数据不一致如何解决也是数据库架构设计重要课题
扩展性
当我们在使用数据库时,随着业务体量增加,经常会面临如下几个问题:
数据量大如何扩展? 写性能扩展? 读性能扩展?
典型的数据库架构
1. 单用户单实例
单用户单实例其实没啥专门讲的,业务前期所有表都在一个库里
不过多表join的场景会出现拆库拆不动,因为都在一个db实例上
如果要拆库改动的话涉及到业务改造
假设单库若干张表,实际上只要加了uuid属性
并且设计好索引,性能也基本满足小业务需求
业务的订单表和库存表如果不在一个库中,就一定会涉及到分布式事务
这时才是一个大坑,如果你不了解分布式事务,可以看看之前写的文章《啥?分布式啥?啥事务?》
2. 分组(group) + 复制(replication)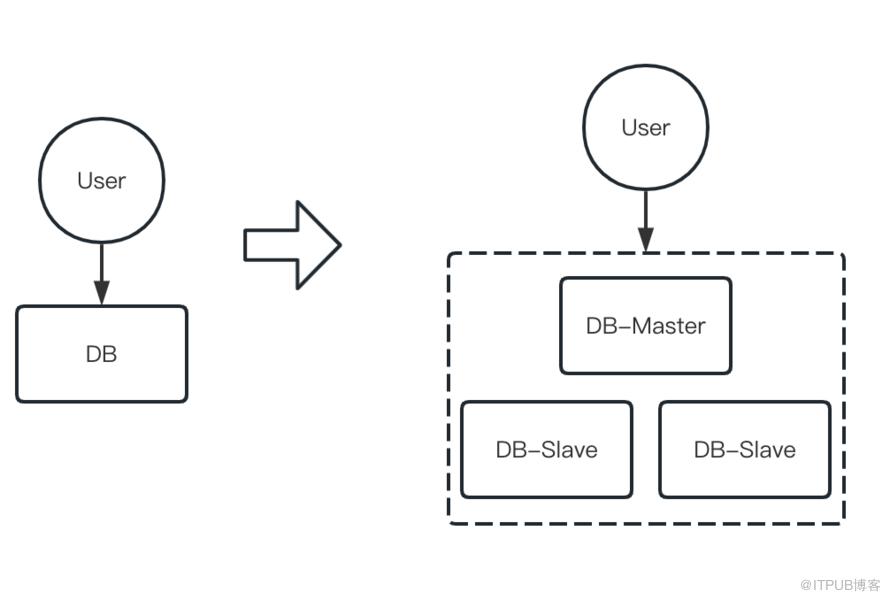
2.1 分组解决什么问题?
原本的读由单实例扩展到3实例,读性能增加
读上可容忍2个实例挂掉,进一步扩展读高可用
写单点扩展到写高可用,但这里实际上仍旧只有Master1个实例提供写
此时如果Master实例挂掉,Slave实例会提升成主来提供写
在切换过程中,写上有秒级别的不可用
写高可用有一定扩展 扩展读高可用 扩展读性能 2.2 分组带来什么问题?
由于使用Master-Slave架构,通过binlog方式进行主从同步
主从之间会有一定延迟,数据敏感度高的业务依旧只能读Master节点
主从延迟问题 2.3 分组没有解决什么问题?-
由于只有Master实例提供写能力,实际依旧是单点,只不过可以尽快可以把Slave提成Master
尽管此时有多个实例,但仍旧是单数据存储
分组+复制使用资源来换取读性能和高可用的扩展
实际上这种架构也是算是分布式系统,关于分布式系统CAP沙盘推演,可以看看之前写的《拜托!这才是分布式系统CAP的正确打开方式!》
没有解决数据存储的问题 写高可用不彻底
3. 分片(sharding)+ 路由(router)
3.1 分片解决了什么问题?
原有是单数据存储,依托分片架构,可以进行数据存储的水平扩展
由于从单实例过渡到了多实例,每个实例都能提供读能力
原有架构只有1个实例可提供写,分片后多实例都可以提供写能力
写性能扩展 读性能扩展 扩展数据存储 3.2 分片带来了什么问题?
写从单实例扩展到了多实例,原有的SQL会产生兼容性问题
跨库Join查询,原本直接写SQL就能实现的逻辑,现在会产生变化
比如求个数据的Min,这时只拿一个库的数据,结果显然是不准确的
解法1: DB层保持不变,业务层改造进行多实例数据聚合的读取;
但涉及到业务逻辑改变,有比较高的改造成本,需要和业务进行拉手
解法2: 业务层保持不变,在中间件层进行join逻辑重写,
解析业务SQL的join逻辑,转译到多实例场景
使用分片路由的架构,因为增加了路由策略层,复杂度会增加很多
不同的路由规则会导致新的问题产生,常见的路由分片策略如下:
<1> 哈希(Hash)路由
一致性哈希、哈希取模或哈希桶,是目前最主流和常见的方案
哈希路由解决了数据实例之间负载不均衡的问题
但实例扩展的过程,会导致数据迁移,进而对读写性能产生一定影响
一致性Hash相关的内容,可以看看之前写的《求锤得锤,你要的一致性hash来了(上)[附代码]》和 《求锤得锤,你要的一致性hash来了(下)[附代码]》
Hash取模相关的内容,可以看看之前写的《3行代码实现Hash路由分片(附代码)》
Hash桶相关内容,可以看看之前写的《原来这个“桶”也能路由分片》
<2> 范围(Range)路由
除了哈希路由外,比较常见策略的还有范围路由
他解决了Hash路由的模型限制,支持了范围查询
扩展起来比较方便,不需要大幅度迁移数据
典型的范围分片一般会使用LSM树,以此来提升批量写效率
但范围分片经常会受业务的逻辑影响导致读写负载不均衡
也就是我们经常说的热点情况
比如APP注册新用户活跃度高,读写请求会远高于活跃度低的老用户
再比如微博文章库,vip账号的数据存储往往会是普通账号的N倍
范围分片相关的内容,可以看看之前写的《震惊!全网唯一 直击范围分片本质[适用HBase、Tidb等]》
带来路由规则的问题 牺牲掉sql的特性 3.3 分片没有解决什么问题?
分片的架构写实例拆分后,依旧存在写单点的问题
每个实例中都是独立的数据表,如果一个实例挂掉
即使中间件层做路由切换,历史数据也无法读取
并且还会造成新、老数据的不一致。
没有解决高可用问题
4. 分片(Sharding)+分组(Group)
4.1 分组+分片解决什么问题?
写扩展性问题 读扩展性问题 数据扩展问题 读+写高可用问题
分组+分片的架构,目前在一些公司也有应用
解决了读写扩展性、高可用和数据扩展问题
优势相关的细节在上面章节都有,这里就不细说了
4.2 分组+分片带来什么问题?
整套架构很美好,关键的数据库架构问题基本都有解了
但这套架构成熟度比较高,意味着复杂度也很高
需要业务、中间件、数据库层面的同步拉手和对齐
由于涉及到改造,在演变过程中对业务冲击是很大的
因此改造带来的收益和风险需要仔细评估,切记拍脑袋
5. 垂直拆分
垂直拆分是一种和业务紧密相连的数据库架构
原来的业务表User存储在单库下
垂直拆分后User表分裂成User.Base + User.Extend表
分别存储在两个库下
5.1 垂直拆分解决了什么问题?
解决性能问题
访问频繁和短的数据放到基础表,不频繁的放到扩展表上 MySQL buffer能够缓存更多频繁的使用的数据,非列式数据都可以缓存在内存中,比如布尔型的字段,年龄、性别、状态等1-8字节的字段,让数据更多落到buffer里,提升访问效率,反之比如自我介绍类的,char/varchar类型,一般都几十、上百字节,这类则如果放在自我buffer里,则缓存的内容会大大减少,这类不频繁使用的读写磁盘更合适
5.2 垂直拆分带来了什么问题?
垂直拆分和分片得到的结果是一样的
区别在于是业务层做还是数据库层面来做
由于表分裂成两个表分别存储单库
因此带来了和单独分片一样的问题
需要SQL1拆2,在业务层面需要改在,进行聚合
因此使用垂直拆分+分组的架构,也是一个比较好的架构
垂直拆分是一个业务工程,如果对业务理解不够是玩不转的
但现状是DBA通常面向的是整个公司,并不仅仅支撑某个业务
深入了解业务的细节逻辑,显然是难度非常大的
因此垂直拆分需要业务架构师或者研发深度参与
和业务需要紧密配合 SQL拆分问题
怎样选择合适的数据库架构
上面我们聊了很多数据库架构
那么如何选型其实是一个非常重要的问题
在我看来做数据库架构设计2个关键点:
知道业务想要什么?切忌自嗨
对于底层基础服务来说,如何解决业务最痛的问题是尤为重要的
做Inf实际很苦,毕竟不直接产生经济价值
只能通过帮助业务实现商业成功来体现我们的价值
因此如果业务想要性能,给业务整个高可用方案显然是不恰当的
“卖”给业务一个他想吃的苹果,和业务同频共振,这样才能前进
知道自己有什么?切忌短视
脱离经济基础,而大谈上层建筑是非常可怕的
知道业务想要什么之后,我们一定还要知道自己处于一个什么阶段
对数据库现状要有清晰的认知,还涉及到资源投入、短中长规划等等
比如目前业务很稳定,并没有很多需求,只是日常的一些支持
但业务的变化通常非常迅猛,如果不想数据库成为业务的瓶颈
我们还是得做点什么,比如预研新技术、新架构等等
这时需要做Inf长期的规划,用规划倒逼出里程碑和路径
「原创推荐」
云栖大会|小米大数据运维管理体系的建设与实践
Chatgpt是否会背叛人类?
2023年总结|人生本是一场修行
联邦架构是大规模YARN的唯一选择吗?
揭开Linkedln YARN集群性能预测的面纱
LinKedIn YARN集群10000节点性能优化实战
「最佳实践」
「职场生活」
原文作者:BigData之路;如有侵权,请联系管理员删除。

