在几篇理论过后,本篇让我们动动手,实操安装部署一个Spark环境,以供后续的学习探究。Spark的环境有预编译和源码编译两种方式,在官网可选择安装包,如下所示

一、预编译
在Apache官网找到最新的Spark预编译版本,这里选择的是spark-2.3.0-bin-hadoop2.7.tgz
1、需要注意的是,从Spark2.2版本开始不再兼容java1.7,因此选用java1.8版本(安装过程略)
2、解压tar包
tar xvf spark-2.3.0-bin-hadoop2.7.tgz
3、添加环境变量
export JAVA_HOME=/usr/java/jdk1.8.0_65
export SPARK_HOME=/home/hadoop/spark-2.2.0-bin-hadoop2.7
export PATH=$PATH:$SPARK_HOME/bin:$SPARK_HOME/sbin:$JAVA_HOME/bin
此时我们的spark 就安装好了,没错,确实已经安装好了!是不是开箱即用。
接下来我们使用spark自带的pi的示例程序,检测下spark环境是否正常,如下所示:
run-example SparkPi 10
二、源码编译
为了最大化Spark版本兼容性,可以针对实际集群版本进行源码编译。这里我们使用Maven进行编译(当然使用SBT也可),Spark版本为的2.3.0。
1、maven部署
1.1 这里选择的版本是3.5.3,下载maven软件包,并解压
1.2 添加环境变量
export MAVEN_HOME=/home/hadoop/apache-maven-3.5.3
(使用国内源则改为 export M2_HOME=/home/hadoop/apache-maven-3.5.3)
export PATH=$PATH:$MAVEN_HOME/bin
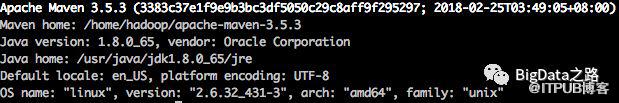
1.3 执行mvn -v,结果如下,此时maven就安装好了
1.4 由于官方源比较慢,修改配置文件,添加国内阿里的镜像源
进入maven中的conf,修改settings.xml文件
<mirror>
<id>nexus-aliyun</id>
<mirrorOf>*</mirrorOf>
<name>Nexus aliyun</name>
<url>http://maven.aliyun.com/nexus/content/groups/public</url>
</mirror>
2、编译spark源码
2.1 这里选择的版本是2.3.0,下载Spark 源码包,并解压
2.2 进入到spark-2.3.0目录下,开始针对Spark基础包进行编译
mvn -Dhadoop2.7 -DskipTests clean package
具体编译多久,就看网速决定了。。。
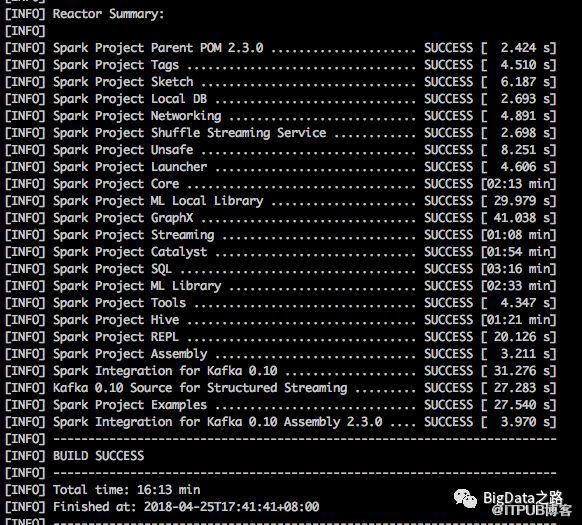
编译完成后,如上图所示。当然也可以通过编译生成Spark安装包,用于多个节点的安装。
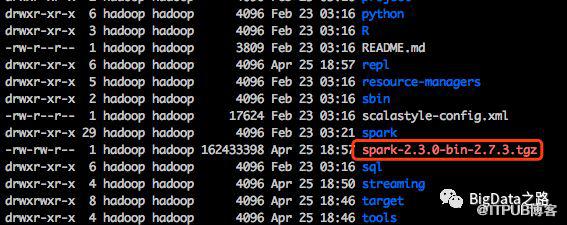
./dev/make-distribution.sh --name custom-spark --pip --r --tgz -Psparkr -Phadoop-2.7 -Phive -Phive-thriftserver -Pmesos -Pyarn -Pkubernetes
执行完成后,Spark的主目录下会出现一个spark的二进制压缩包
三、语言终端
在《Spark简介》中,我们有提到,Spark支持scala、python、R和Java语言。Spark对其中三种提供了轻量级的交互终端。
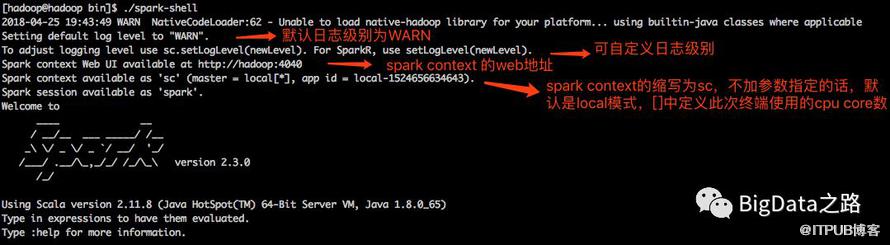
对于scala 语言来说,需要通过spark-shell执行。如下所示
对于python语言来说, 需要提前安装python环境,要求python2.7+,通过pyspark执行对于R语言来说,需要提前安装好R依赖,对R版本无特殊要求,通过sparkR执行。此处就不上图了。
对于Java来说,Spark并没有提供直观的交互性终端,只提供了Spark-submit的方式提交任务。(虽然看似Spark对Java累觉不爱,但是实际上,Spark所有的语言终端都是根据Spark-submit来完成)
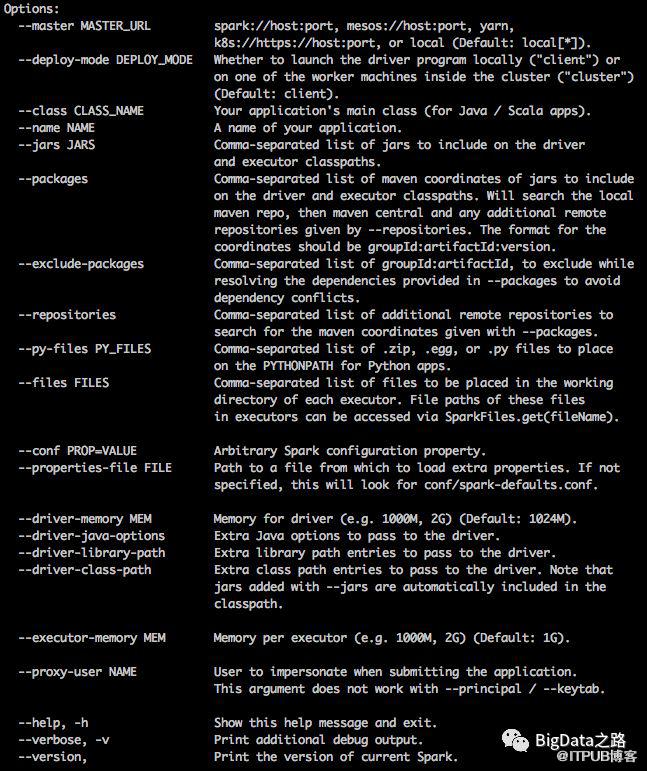
各种终端来说,有默认的启动参数,如果你希望根据不同的环境进行适配的话,需要通过其他参数进行指定,查看参数可以通过 --help 查看,如下所示。
四、终端解析
介绍了常用终端以后,我们来看看这种终端是如何实现的,还是以Spark-shell为例。在Spark-shell脚本的前半部分,检查了系统环境,设置了Shell为POSIX的标准模式,并且声明了环境变量。着重说一下SPARK_SUBMIT_OPTS这个环境变量,如下所示,Spark-shell是为scala提供的交互式终端,默认情况下是不会使用Java的ClassPath的,所以需要显示指定。
SPARK_SUBMIT_OPTS="$SPARK_SUBMIT_OPTS -Dscala.usejavacp=true"
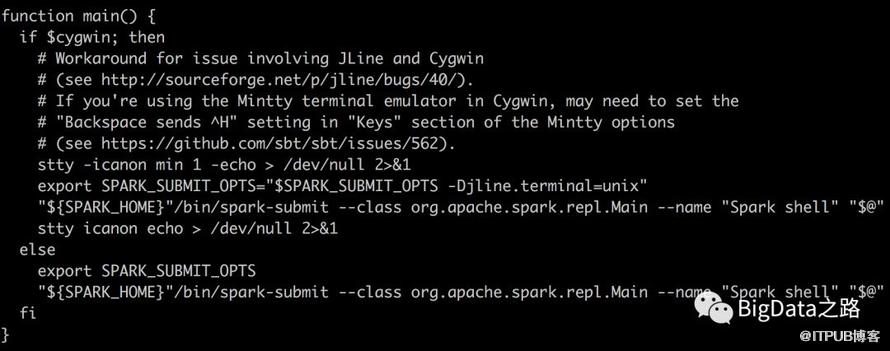
上图为Spark-shell的主函数,在主函数中首先使用stty关闭了回显示,然后使用spark-submit去调用 org.apache.spark.repl.Main 类。我们再看看spark-submit中是做了什么。
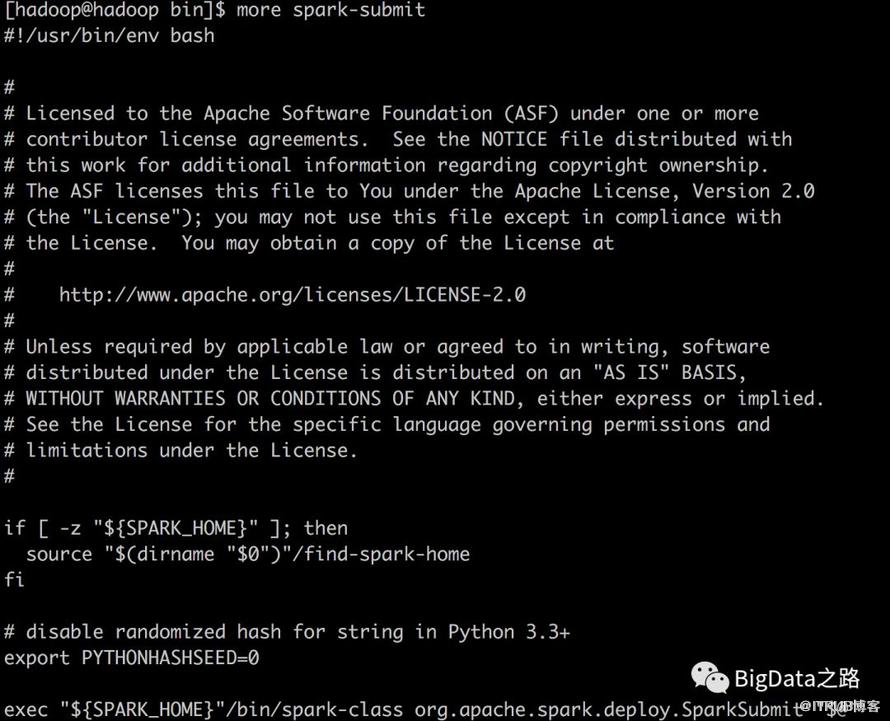
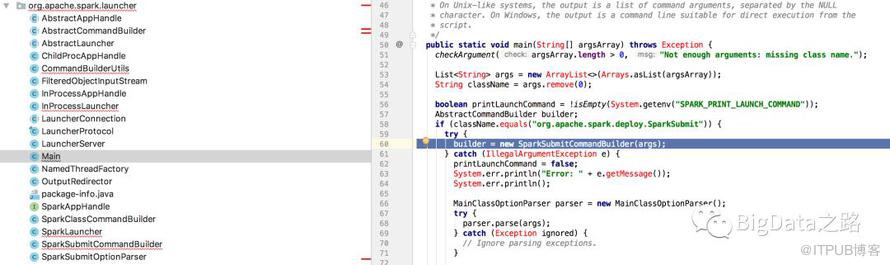
spark-submit直接通过spark-class调用了org.apache.spark.deploy.SparkSubmit类。我们再来看看spark-class中的内容,在spark-class中,有很大篇幅都是重新声明环境变量(SPARK_HOME、JAVA_HOME、lib包),最主要的就是下面的内容。调用的是org.apache.spark.launcher.Main
这个类。

org.apache.spark.launcher.Main 类中会判断传入的Class Name,然后通过SparkSubmitCommandBuilder方法判断传不同类型客户端的传参,紧接着根据对应客户端类型,构造spark的提交命令。
如有疑问,可公众号留言和微信联系
推荐关注BigData之路。第一时间,分享更多干货,BigData之路与你共同成长,欢迎关注和转发。
原文作者:BigData之路;如有侵权,请联系管理员删除。

