
时隔两年再次拿起公众号,心态上有了很多变化。在大数据领域探索了几年,确实也到了静下心来,沉淀一下的时候了。接下来的一系列文章也算是将现有理解和学习所得相结合的一些产物,绝对原创。本人文笔拙略,知识点尽量深入浅出,如有不当之处还请各位海涵并指出,同时欢迎技术交流和沟通,期待和大家共同成长。
本文为先导文,分片路由实现、一致性等文章,请关注后续。
在如此的背景下传统数据库,以Oracle、MySQL等为代表的数据库为了不断前行,在纵向不断深挖,也推出了很多小机、一体机等专用机型,但硬件上推陈出新的速度相比数据增长的速度来说,永远是滞后的,虽然各自也推出以RAC、主从等架构一定程度上进行了横向扩展缓解了单点的压力,但面对庞大的数据依旧显得较为“单薄”。目前主流的Hadoop系存储计算系统基本采用的是横向扩展,即通过增加机器数量来增加水平扩展的能力。
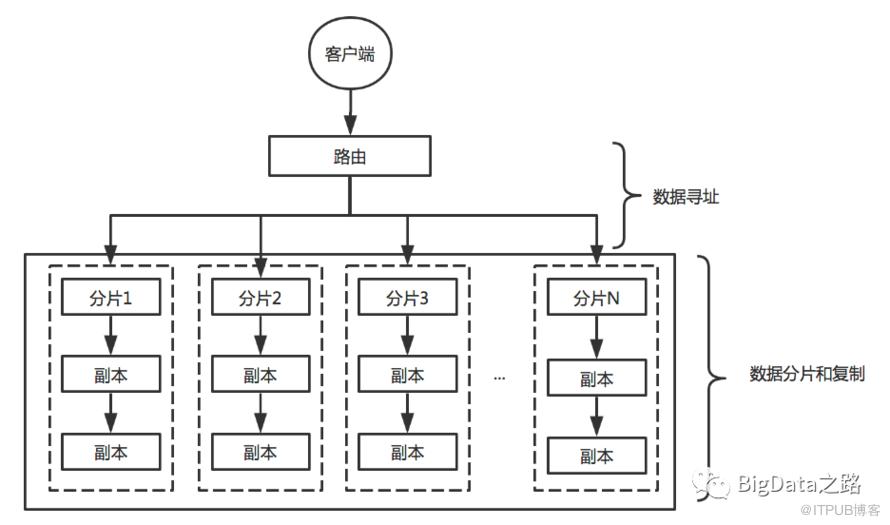
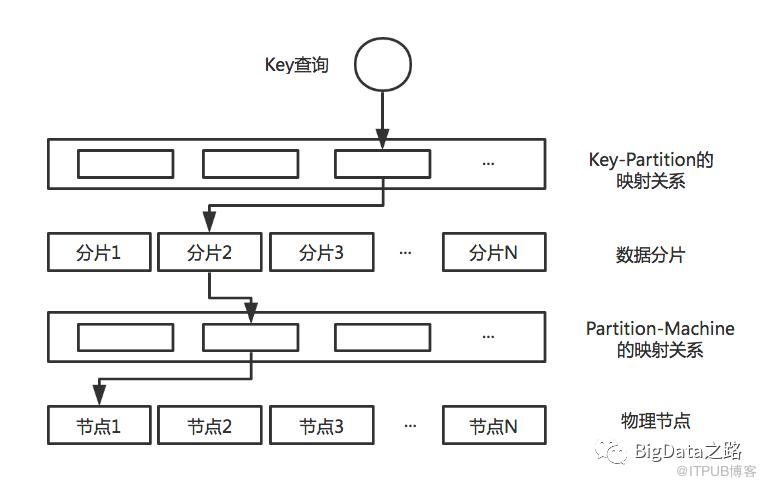
此时我们反过来思考,哪些系统符合上述通用的路由模型呢?
a.在狭义的定义下,是不是像极了Hbase中RegionServer-Region-Key的关系,Client 通过ZooKeeper 的meta-region-server找到了Meta表,访问Meta表获取了RowKey和Region信息,最后去RegionServer的rpc操作数据。
b.此时我们再稍微广义的横向对标下其他服务,貌似我们不必纠结于是否该系统是否为KV系统,同样的对于Kafka来说,存在Broker:Topic Partition:Message,Producer首先找到Topic的Partition信息,然后通过PartitionLeader位置连接Broker的ip:port来生产数据。HDFS也是类似的存在着DataNode-block-file/dir的映射关系。
所以虽然服务类型定位不同,具体实现方式不同,但都有着类似的路由、分片方法。这就是大数据技术的殊途同归,咳咳,这里有些扯远了,我们下一节再回归正题。
数据分片的道理也是类似,并不是分片越多效率越高、副本越多数据安全性就越高,分片和副本增加会给元数据维护、数据一致性带来巨大的挑战,当然,随之而来的也会带来存储成本的增长。
哈希分片,顾名思义通过将每个Key进行hash操作,通过hash函数将Key-Value 分配在不同分片中。因为需要对每一组KV进行映射维护,所以对点查询(即单Key查询)非常有优势。
范围分片,将一段范围内的Key-Value进行规整切分为一个分片,这样就形成若干个内部有序的分片。同样的这种分片手段优势也十分的明显,非常适合范围查询(即多Key查询)。
原创不易,觉得有点用的话,就请你为本文点个在看或者无情转发吧。
你的支持是我写作的动力。
原文作者:BigData之路;如有侵权,请联系管理员删除。

