一、Spark是什么?
Spark官方定义为一种处理大规模数据的统一分析引擎。(如果对引擎没有概念的话,可以浅比成MySql的innodb、myisam、ndb引擎),很多人都说Spark会取代Hadoop,在这里纠正大家的一个误区,Hadoop作为老牌的大数据系统,实现的是数据的存储和计算,那Spark是干什么的呢?Spark是一种数据处理引擎,其本身只做数据计算,不做数据存储,所以其实更恰当的类比是将Spark和Mapreduce去对比。MapRduce是一个分布式计算框架,而Spark是分布式内存计算模型。
二、Spark为什么会“火”?
1、性能表现优异
Spark运行速度快,在内存中计算比MapReduce快100倍,在磁盘上比MapReduce快10倍。Spark是基于内存的分布式计算引擎,不再像MpReduce一样,需要中间结果需要存在磁盘上,而是存储在内存中,且后续计算都在内存中迭代,因此在速度上有了明显提升。这个提升在数据量大的场景下尤为明显,相反在数据量小,计算密度低的场景下,两者性能的差距会逐渐缩小。
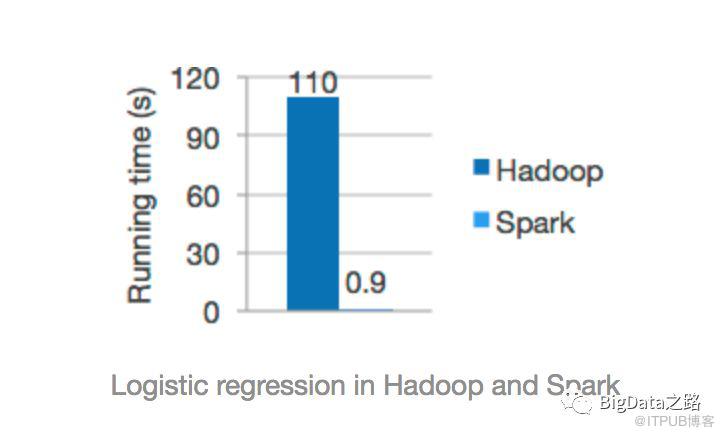
2、易用性高,支持语言Java、Scala、Python、R
Spark是使用Scala编写,Scala又是从Java语言演变而来,所以支持Java和Scala语言;Python在人工智能,机器学习的时代持续走热,由于其拥有已封装好的算法库,引入库后,只需要完成逻辑部分即可,大大降低了门槛,所以受到很多人的追捧;Spark中有专门语言包SparkR,提供一个轻量级的环境,供R语言使用。
3、兼容性好,覆盖面广,支持SQL、Streaming 、Graphx、MLlib
Spark SQL在1,.0版本的时候摒弃了Shark,大刀阔斧的对Spark SQL进行重构,从而在效率上比Hive提升很多;对于流式数据,通过Streaming的方式对数据进行批处理;MLlib提供了机器学习的支持;Graphx提供给了图形处理的支持。
4、在任何地方都能运行
支持Local、Yarn、Mesos、Kubernets、Standalone集群模式,同时Spark操作支持HDFS、Cassandra、Hbase、Hive等百余种数据源。
三、Spark 发展过程

Spark于2009年,在加州大学伯克利分校AMP实验室诞生,2010年他被AMP实验室公诸于世(正式开源),2013年6月正式被纳入Apache开源项目, Apache看中了其潜在价值,不久之后就将Spark提升为Apache 的顶级项目。Spark自开源之后,受到广泛关注,一度成为apache最炙手可热的项目(没有之一)。
四、Spark 重要版本及更新内容
Spark的发展是十分迅速的,在两年左右的时间从1.6版本到最新的2.3版本,几乎每几个月都会有新版本产出。

大版本主要更新内容如下所示(看不懂没关系,随着Spark后续内容的讲解,大家会渐渐理解)
Spark-1.1 :引入SparkSQL和MLlib
Spark-1.3 : 增加 DataFrame新API
Spark-1.4 : 增加 分析开窗函数
Spark 1.5 : DataFrame底层优化
Spark-1.6 : “钨丝计划”,优化cpu和内存
Spark-2.0 :新增Structured Streaming
Spark-2.1 :改进Structured streaming,增加对kafka 0.10的支持
Spark-2.2 :扩展spark sql功能,移除structured streaming实验标签
Spark-2.3 :添加对Kubernetes的支持
推荐关注BigData之路,第一时间,分享更多干货,欢迎关注和转发。

原文作者:BigData之路;如有侵权,请联系管理员删除。

