4 个实用的数据科学中级 SQL 查询
SQL 是开发者、工程师和数据专业人员必备的语言。掌握中级 SQL 知识能为你的数据科学职业生涯带来优势。
因此,在本文中,我们将讨论一些数据专业人员必备的中级 SQL 查询。我们将讨论 4 个 SQL 查询,问题是,为什么要学习这 4 个 SQL 查询?
我们都熟悉在 SQL 中创建数据库,但更重要的是知道如何根据我们的需求有效地清洗和过滤数据。这正是这些查询帮助我们之处,那么让我们来看看这些查询是什么
SQL 中的触发器(Trigger),以及如何在我们的查询中使用它?
SQL 中的 Partition By
SQL 中的 Limit,以及我们如何使用 LIMIT 语法来限制 SQL 表中的查询?
SQL 中的 COALESCE 函数,以及它如何帮助我们消除 NULL 值?
1. SQL 中的触发器
在本文中,我们将讨论 SQL 中触发器的强大功能。
SQL 中的触发器是什么?
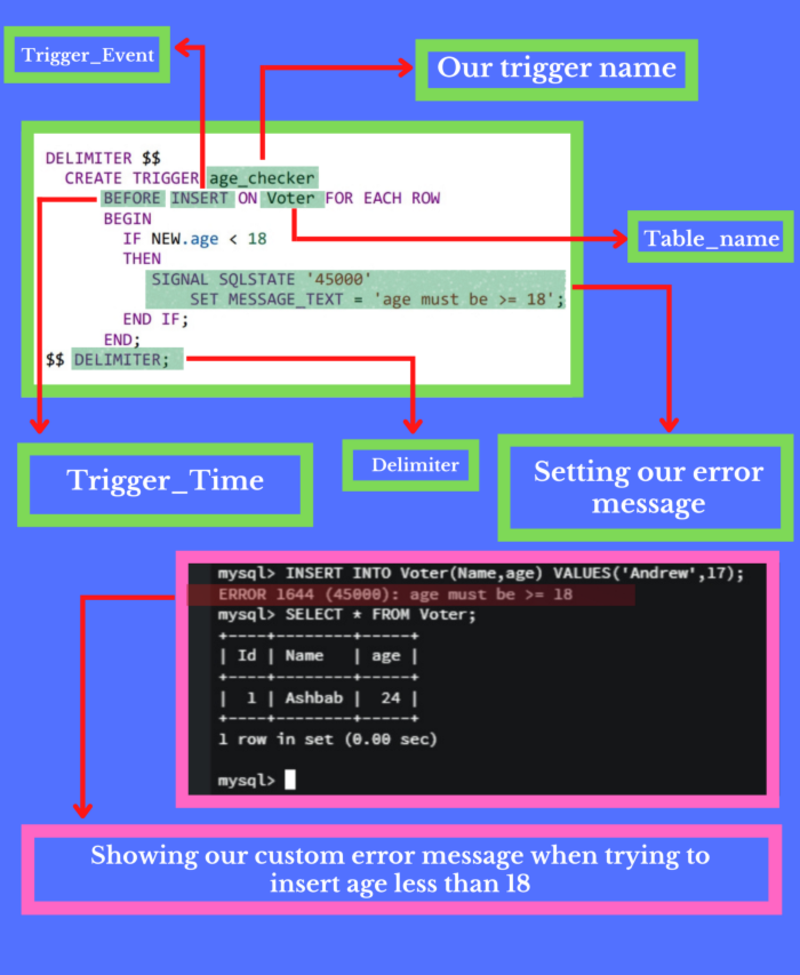
触发器是一段 SQL 代码,当某个事件被执行时会自动运行。例如:在下面的查询中,当用户尝试向表中插入值时,我们的触发器会运行。
触发器主要分为三个部分
1. Trigger_Time:触发时间是指你希望该触发器何时运行,例如,在事件之前或之后。
在我们下面的查询中,我们使用了 before,为什么?因为我们希望代码在插入到表之前运行。
2. Trigger_Event:触发器事件是我们希望运行此触发器的时机,例如 INSERT、UPDATE 和 DELETE
在上面的示例中,我们使用 INSERT,因为我们希望在执行 INSERT 事件时运行触发器。
3. Table_name:表名是我们表的名称
因此,让我们通过适当的实际解释来详细讨论触发器语法
BEGIN 和 END 之间代码的作用是,每当我们向 Voter 表中插入一个值时,触发器会检查年龄,判断其是否小于 18 或大于 18。如果大于或等于 18,则不会发生任何事情;但如果小于 18,触发器将显示错误,并且我们设置了消息。
例如,查看上图,我们设置了 message_text = ' age must be >=18',因此每当我们尝试插入小于 18 的值时,就会显示此错误消息。在输出部分,当我们尝试插入 Andrew,17 时,查询显示错误,其中包含我们的自定义消息。这就是 SQL 中的触发器以及如何在查询中使用它们。
查看下面的代码以获得更实际的理解
DELIMITER $$
/* creating a trigger whose name is age_checker */
  CREATE TRIGGER age_checker
     /* defining when our trigger run before inserting or after inserting
        in our case we choose before inserting that's why we use BEFORE */
      BEFORE INSERT ON Voter FOR EACH ROW
      BEGIN
     /* Now we are checking the inserted value in our age column if it is
        less then 18 then show our error message */
        IF NEW.age < 18
        THEN
           SIGNAL SQLSTATE '45000'
              /* setting our error message in the MESSAGE_TEXT */
              SET MESSAGE_TEXT = 'AGE MUST BE >= 18';
        END IF;
     END;
DELIMETER;
2. SQL 中的 Partition by
本文将讨论 partition 以及如何在 SQL 中使用它。
那么第一个问题是,SQL 中的 partition 是什么?
partition 的作用是将具有相似值的行分组,但不限制行数。
让我们通过一个例子来更清楚地说明。
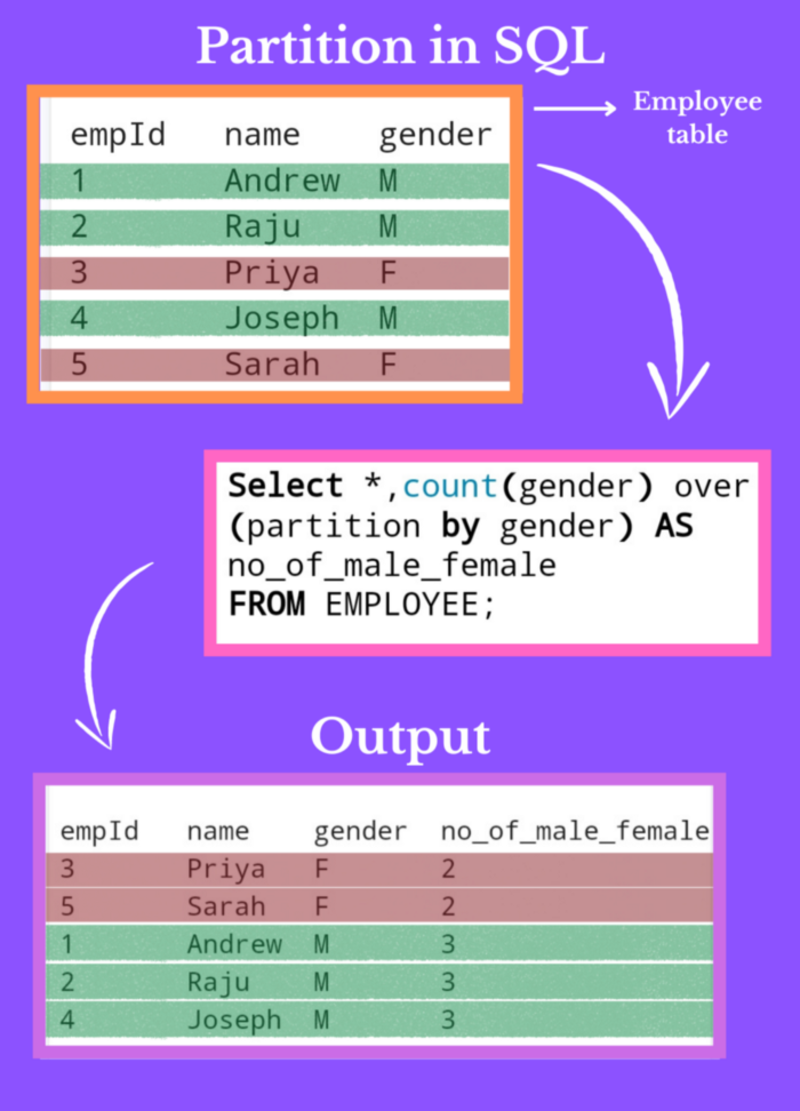
请查看上面的第二张图片。
表中有五行数据,其中有一列名为 gender,包含三名男性和两名女性,那么如果我们想要一个新列来显示男性和女性的数量该怎么办?
partition 语法根据相似的值对行进行分组,这意味着在我们的查询中,我们使用 partition by gender。这意味着我们希望根据 gender 对行进行分组,因此 gender 列中只有两个唯一值,第一个是 M,第二个是 F,所以它将行分为两组。
1 在 gender 列中包含 M 的行
2 在 gender 列中包含 F 的行,这就是 SQL 中 partition 的作用,我们使用 count 函数来统计组中的行数。
在输出中,你可以看到创建了一个名为 no_of_male_female 的新列,该列包含组中的行数。例如,F 组中有两行,所以显示 2,M 组中有三行,所以显示 3。
SQL 中 group by 和 partition by 有什么区别,因为两者的作用相似。答案是,如果你使用 group,你的五行数据只会转换为两行。为什么?
因为 group by 显示的是组的数量,在我们上面的查询中,我们的表被分为两组,M 和 F,所以 group by 只显示每个组的第一行,这意味着如果组中包含十行,但它在输出中只显示 1 行,因为它只显示每个组的 1 行。
但如果你使用 partition by,那么你的行数保持不变,正如你所看到的,输出中的行数和表中的行数保持不变。
SQL 中的 partition 显示所有行。
两者都有优点和缺点,你可以根据自己的需求使用它们。
如果需要,请查看下面的代码
/* count function used to count number of gender after partition and then
   show output in no_of_male_female column */

SELECT * , COUNT(gender) OVER (PARTITION BY gender)
AS no_of_male_female FROM EMPLOYEE;
3. 限制查询
SQL 中的 LIMIT 及其工作原理,尽管某些 SQL 数据库不支持 LIMIT,例如 SQL Server 和 MS Access。
LIMIT 子句在 SQL 数据库中被广泛使用,主要用于限制行数。
例如:如果我们想从数据库中查找排名前十或最差的十张专辑,那么 LIMIT 就很有用。我们在查询的最后使用 LIMIT 10,工作就完成了。
但这里有一个问题:LIMIT 是如何工作的,我们如何有效地使用它?
我们可以以两种方式使用 LIMIT
1. LIMIT(任意常量值)
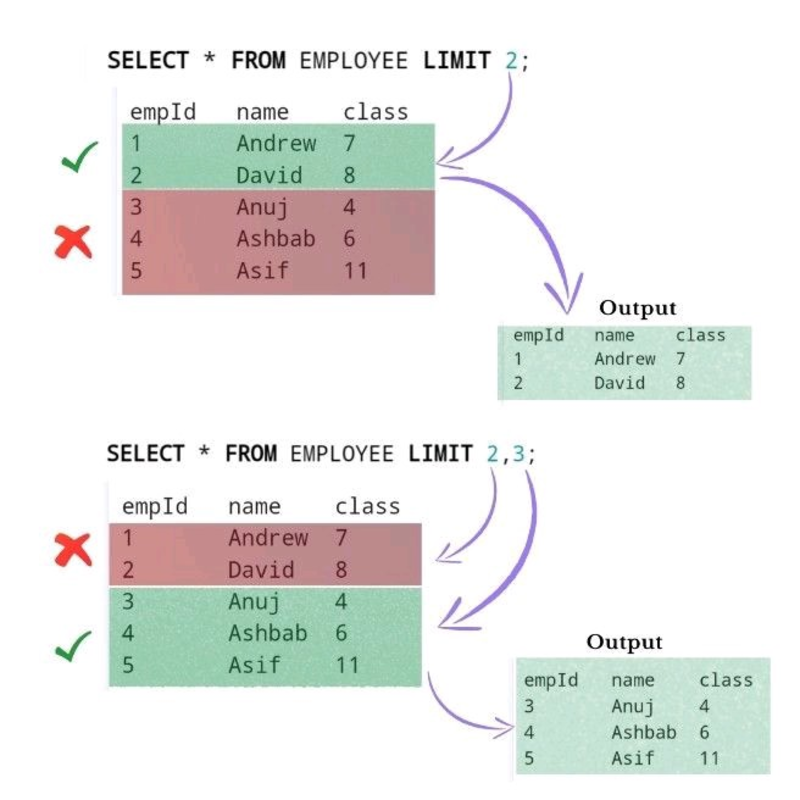
例如,下面的代码从表中选择前八行
SELECT * FROM table_name LIMIT 8;
这是一种更精确的限制表数据的方式。
x 参数用于从顶部消除若干行。
y 参数表示消除后你想要的行数。
Select * FROM table_name LIMIT 3,2;
此查询从顶部消除三行,然后显示消除三行后的两行。
查看下面的代码。
/* This command is used to select first two rows */

SELECT * FROM EMPLOYEE LIMIT 2;


/* This command is used to select 3 rows after eliminating first two rows */

SELECT * FROM EMPLOYEE LIMIT 2,3;
4. COALESCE 函数
你知道 SQL 中有一些很棒的函数可以节省你的时间吗?
这里我谈论的是 COALESCE 函数,这个函数会让你惊叹,所以请阅读完整篇文章。
COALESCE 函数接受 n 个值。
COALESCE(value_1,value_2,......, value_n)
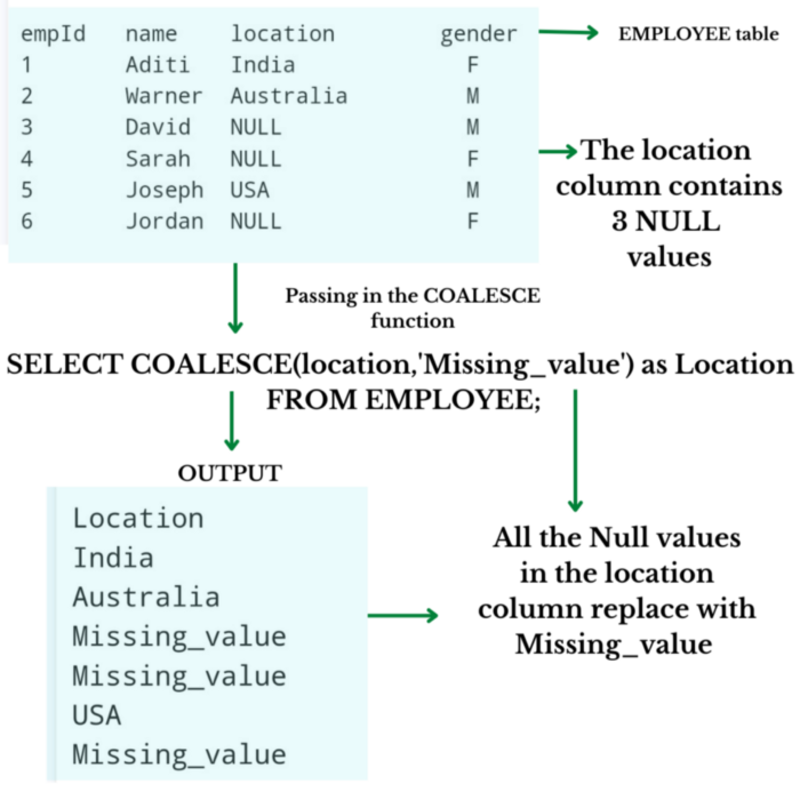
那么让我们来理解这一点;请看上面的第 4 张图片。你会看到一个 EMPLOYEE 表,其中包含一个名为 located 的列,在该列中有 3 个 NULL 值。那么如果我们想用有意义的词替换那个 NULL 值呢?所以如上面的图片所示,我们想用 Missing_value 这个词替换所有 NULL 值。
我们可以通过 COALESCE 函数做到这一点,只需查看上面图片中的代码。COALESCE 函数将所有 NULL 值替换为 Missing_value 这个词。
让我们逐步理解 COALESCE 函数。
步骤 1:我们在 COALESCE 函数中传递的第一个参数是我们想要查找 NULL 值的列名。这就是为什么我们使用 location。
步骤 2:如果它找到了一些值,那么什么也不会发生;正如你在图片中代码的输出中所看到的,值保持不变,但如果它找到了 NULL 值,那么它所做的就是简单地将该 NULL 值替换为我们在 COALESCE 函数中作为第二个参数给出的词,我们给出了 Missing_value 作为第二个参数,这就是为什么它将 location 列中存在的所有 NULL 值替换为 Missing_value。
这就是 COALESCE 函数在 SQL 中的工作方式。我们给出了使用单列的示例。如果我们想要替换多个列中的 NULL 值,也可以做同样的事情;我们也可以通过遵循上述语法来做到这一点。
查看下面的代码。
/* So we are targeting the location column from our EMPLOYEE table and
   then replacing the NULL values with Missing_value text */
SELECT COALESCE(location,"Missing_value") as Location
FROM EMPLOYEE;
我希望这篇文章能简要解释你如何在 SQL 中使用这些基本查询,以及使用它们有什么好处。如果你有任何问题,欢迎在评论区提问。
Ashbab Khan 是一名数据科学家、SQL 专家和创意技术作家。
原文。经许可转载。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:KDnuggets
原创地址:https://www.kdnuggets.com/2022/12/4-useful-intermediate-sql-queries-data-science.html#comment-184753
原文作者:https://www.facebook.com/kdnuggets;如有侵权,请联系管理员删除。

