在本博客中,你将学习如何在 AMD Instinct™ MI355X GPU 上使用 Primus 从零开始预训练混合 LLM。具体来说,我们将介绍如何通过单个配置字符串声明混合层堆栈、三种线性循环混合器(Mamba2、Gated DeltaNet 和 Kimi Delta Attention)如何在吞吐量与训练质量之间进行权衡、哪些配方设置首先决定你的运行能否装入内存,以及哪些环境变量可能会悄然改变你的结果。在此过程中,你将获得本文中每个数字背后已发布的配置,以便你可以自行复现这些运行。准备好训练你自己的混合模型了吗?拉取 Primus 镜像并跟随操作——这里的一切都在单个八 GPU 节点上运行。
为什么要在 Primus 上训练混合模型? #
语言模型架构正在超越纯 Transformer(深度学习中的注意力模型架构)。标准自注意力仍然是长上下文窗口的主要瓶颈:其计算成本随序列长度呈二次方 \(O(N^2)\) 增长,而其键值(KV)缓存随序列长度线性增长。相反,线性循环块提供了相反的权衡——通过固定大小的状态以线性成本 \(O(N)\) 处理序列。然而,线性循环层单独使用时,在精确的非局部检索方面表现不佳。混合模型通过结合两种类型的层来弥合这些权衡之间的差距。近期的设计,如 Jamba、Samba、Qwen3-Next 和 Kimi Linear [ 1 ],在以线性循环块为主的堆栈中穿插少量注意力层。注意力层提供对早期 token 的直接访问,这是固定大小的循环状态无法保证的。由于其中许多层可以是线性循环的,混合架构降低了内存和计算开销,同时在关键之处保留了检索能力。
在训练框架中支持这些架构带来了一个独特的工程问题。混合模型是由不同子层类型组装而成的异构堆栈,每种类型都有自己的自定义内核、内存特性和数值稳定性要求。生产级框架必须解决三个关键需求:
灵活放置,使子层可以任意排序而无需更改代码
内核融合,使每种类型的子层保留使其高效运行的融合内核
数值稳定性,在数万次连续迭代中保持稳定
Primus 是 AMD 在 AMD Instinct GPU 上用于基础模型的统一、后端无关的训练框架,是一个满足上述需求的平台,支持 Megatron-LM [ 2 ] 和 TorchTitan [ 3 ] 等后端。本文描述了为在 AMD GPU 上从零开始进行混合模型预训练而做出的设计与实现选择。此外,我们将详细阐述 Primus 支持的架构、每种设计选择相关的成本,以及我们通过在单个八块 MI355X GPU 节点上将五个模型训练至完成所获得的结果。
我们训练的模型 #
我们在一个八块 MI355X GPU 节点上将五个模型训练至完成,全部使用序列长度 2048、bfloat16 精度,并在 FineWeb-Edu [ 4 ] 上训练。“75% 混合”标签指的是 *-M-M-M-*-M-M-M-*-M-M-M- 模式,其中三个 MLA 注意力块 [ 5 ] 分布在十二个混合器中。
| 模型 | 规模 | Token 数 | 最终损失 |
| --- | --- | --- | --- |
| Pure GDN | 1B | 100B | 2.487 |
| Pure GDN | 300M | 10B | 3.411 |
| Pure KDA | 300M | 10B | 3.407 |
| 75% Hybrid Mamba2 | 300M | 10B | 3.385 |
| 75% Hybrid GDN | 300M | 10B | 3.382 |
表 1:产生本文结果的五次预训练运行。每次运行均完成,没有 NaN 值,也没有跳过迭代,所使用的配置包含在代码仓库中。
Primus 中混合模型的定义方式 #
Primus 中的混合模型是由三种子层构建而成的单一层堆栈,这些子层可以以任意顺序交错排列。
| 符号 | 子层 | 成本 |
| --- | --- | --- |
| * | 注意力块(MLA,多头潜在注意力) | 随序列长度呈二次方增长,对完整序列进行注意力计算 |
| M | 线性循环混合器(Mamba2、Gated DeltaNet 或 Kimi Delta Attention) | 随序列长度呈线性增长,状态大小恒定 |
| - | MLP / SwiGLU 前馈块 | 标准 |
表 2:用于组装混合堆栈的三种子层类型。
该排列方式直接在配置中声明,模型定义的其他部分无需更改:
model_type
:
mamba
# required for every hybrid model
is_hybrid_model
:
true
hybrid_override_pattern
:
"*-M-M-M-*-M-M-M-*-M-M-M-"
这个 24 字符的模式描述了十二个混合器块与十二个 MLP 块交替排列,注意力放置在混合器位置 0、4 和 8 处,其余每个位置为线性混合器。纯线性模型就是一个不包含 * 字符的模式,也可以用 hybrid_attention_ratio: 0.0 来表示。
对于所有混合器,周围的 SwiGLU MLP 和 RMSNorm 子层是相同的,训练配方也相同。由于只有 token 混合器发生变化,替换其中一个只需修改一行配置。这三种混合器在如何决定其固定大小状态中保留什么信息方面存在根本差异。
Mamba2 [ 6 ] 是一种选择性状态空间模型(SSM),使用每个头一个标量门来衰减其状态。
Gated DeltaNet (GDN) [ 7 ] 在 Mamba2 的基础上增加了 delta 规则,这是一种联想记忆形式,它更新当前键所存储的关联,而不仅仅是累积到状态中,同时保持每个头一个标量遗忘门。
Kimi Delta Attention (KDA) [ 1 ] 扩展了 GDN,将该门细化为每个键维度一个值,通过低秩瓶颈投影计算得出。这一优化提供了对状态保留内容的更精细控制,代价是吞吐量的轻微降低。
| 混合器 | 规模 | 纯配置 | 混合配置(含 MLA) |
| --- | --- | --- | --- |
| Mamba2 | 370M, 1B, 3B, 8B | mamba_370M-pretrain.yaml | zebra_llama_mamba_{1B,3B,8B}_BF16-pretrain.yaml |
| Gated DeltaNet (GDN) | 300M, 1B | gdn_{300M,1B}_BF16-pretrain.yaml | zebra_llama_gdn_1B_BF16-pretrain.yaml |
| Kimi Delta Attention (KDA) | 300M, 1B | kda_{300M,1B}_BF16-pretrain.yaml | zebra_llama_kda_1B_BF16-pretrain.yaml |
表 3:已发布的配置,位于 examples/megatron/configs/MI355X/ 。MI300X 也提供了混合配置,MI325X 提供了 Mamba2 配置。
在这些文件名中,zebra_llama_ 前缀记录了混合模型的血统,后缀则指明了线性混合器及其规模,例如 zebra_llama_gdn_1B 。此处使用的 MLA 注意力与线性块的特定组合遵循了 Zebra-Llama [ 8 ] 建立的层方案,并由 HyLo [ 9 ] 进行了扩展。需要注意的是,尽管这两篇论文都通过后训练对现有的 Transformer 检查点进行升级来训练混合模型,但本文所描述的工作是通过随机初始化从头预训练 Zebra-Llama 架构。
配方 #
默认发布的配置包含以下所有设置,但 batch size 和迭代次数除外,这两项被有意设置得较小,以便首次运行能够快速完成。
| 设置 | 300M | 1B |
| --- | --- | --- |
| 序列长度 | 2048 | 2048 |
| 精度 | bfloat16 | bfloat16 |
| 微批次 x GPU 数量 | 128 x 8 | 64 x 8 |
| 全局批次 | 1024(2.10M tokens/iter) | 512(1.05M tokens/iter) |
| 迭代次数 | 4,768(10B tokens) | 95,368(100B tokens) |
| 学习率 | 2e-4 至 2e-5,cosine | 3e-4 至 3e-5,cosine |
| 预热 | 200 次迭代 | 2,000 次迭代 |
| AdamW | beta = (0.9, 0.95),weight decay 0.01,gradient clip 1.0 | beta = (0.9, 0.95),weight decay 0.01,gradient clip 1.0 |
| 并行策略 | TP = PP = EP = 1(纯数据并行) | TP = PP = EP = 1(纯数据并行) |
| 优化器状态 | 复制 | ZeRO-1 分片( use_distributed_optimizer ) |
| 交叉熵 | fused_ce_mode: 2 ,8 个分块 | fused_ce_mode: 2 ,8 个分块 |
| FLA 融合 | 融合 SwiGLU、RMSNorm、gated norm、short conv | 融合 SwiGLU、RMSNorm、gated norm、short conv |
| Dropout / LayerNorm epsilon | 0.0 / 1e-6 | 0.0 / 1e-6 |
| 随机种子 | 42 | 42 |
表 4:完整的预训练配方。每一列都是一个自包含的设置。
此表中有两项在操作上至关重要,因为它们决定了一次运行能否执行,而不仅仅是它如何收敛。
分块融合交叉熵可防止 logits 张量在此规模的微批次下主导激活内存。在这些形状下,它决定了一次运行是能够容纳,还是引发内存不足错误。
四个 use_fla_* 标志将逐元素的 SwiGLU、归一化和短卷积路径替换为来自 FLA 的 Triton 内核。禁用它们会降低吞吐量和可用余量。
其余设置构成了一套常规的 GPT 风格预训练配方,可以按此对待。
快速开始 #
环境 #
docker
pull
rocm/primus:v26.7
docker
run
-it
\
--device
/dev/dri
--device
/dev/kfd
--device
/dev/infiniband
\
--network
host
--ipc
host
\
--group-add
video
--cap-add
SYS_PTRACE
\
--security-opt
seccomp
=
unconfined
--privileged
\
--shm-size
128G
\
rocm/primus:v26.7
在容器内,从主分支克隆 Primus,本文中使用的 Zebra-Llama 配置就在该分支中,同时克隆其子模块:
git
clone
--recurse-submodules
https://github.com/AMD-AGI/Primus.git
cd
Primus
pip
install
-r
requirements.txt
在首次运行之前,应设置四项配置:
export
HF_TOKEN
=# gated tokenizer repository
export
PYTORCH_CUDA_ALLOC_CONF
=
expandable_segments:True
# see discussion below
export
PRIMUS_FLA_MLA_ATTN
=
0
# hybrid models only
git
config
--global
--add
safe.directory
'*'
# if mounting a host clone
访问 tokenizer 仓库是一项硬性要求。发布的配置使用 meta-llama/Llama-3.2-1B 进行分词,这是一个受门控的 Hugging Face 仓库,如果没有有效凭据,启动器会在设置期间以 HTTP 401 错误终止。即使在使用模拟数据训练时也会发生这种情况,而模拟数据训练在其他方面并不需要 tokenizer。
分配器设置的影响比其简短表述所暗示的更大。这些模型会分配少量非常大的张量,如果没有可扩展段,缓存分配器会在这些张量周围产生碎片。随后,保留内存会大幅增长,远超实际使用量,即使运行仍有真正的余量,也可能因为没有单个连续块可用而失败。启用该设置后,保留内存会紧密跟随已分配内存。这会带来约 4% 的吞吐量损失,并且是使用更大微批次大小的前提条件。
PRIMUS_FLA_MLA_ATTN 仅适用于混合模型。将其设置为 0 可使 MLA 块保持在原生注意力路径上,在此处使用的形状下可提供最高吞吐量。该设置必须作为环境变量提供,因为环境变量的值优先于同名的 YAML 键。
最后,如果仓库克隆是从宿主机挂载而非在镜像内创建,git 将拒绝检查属于其他用户的目录树,这会导致可编辑安装在 setup 期间失败。safe.directory 条目可解决此问题。
模型配置与数据集 #
Primus 将配置分为两层,以便在不改变架构的情况下修改训练配方。模型定义位于 primus/configs/models/megatron/ 下,指定层数、隐藏大小、混合模式和混合器超参数。实验配置引用模型定义并提供其余所有内容:
modules
:
pre_trainer
:
model
:
zebra_gdn_1B_hybrid.yaml
overrides
:
micro_batch_size
:
128
global_batch_size
:
1024
seq_length
:
2048
lr
:
2.0e-4
tensor_model_parallel_size
:
1
pipeline_model_parallel_size
:
1
发布的配置设置了 mock_data: true,允许立即启动运行以验证软件栈,无需任何数据集。要在真实数据上训练,请先准备一次 Megatron 格式的数据集,然后设置 mock_data: false 并将 train_data_path 指向结果:
python3
examples/megatron/prepare_fineweb_edu_megatron_dataset.py
\
--out-dir
./data/fineweb-edu
--sample-size
10BT

python3
examples/megatron/preprocess_data.py
\
--input
./data/fineweb-edu/fineweb_edu_10BT_megatron.json
\
--output-prefix
./data/fineweb_edu_10BT
\
--tokenizer-type
HuggingFaceTokenizer
\
--tokenizer-model
meta-llama/Llama-3.2-1B
\
--append-eod
--workers
32
运行作业 #
Primus 通过单一入口点 primus-cli 启动每次运行。在容器内的 Primus 仓库中,以直接模式启动单节点运行并传入实验配置。GPUS_PER_NODE 默认为 8,日志和检查点写入 ./output 下:
export
EXP
=
examples/megatron/configs/MI355X/gdn_300M_BF16-pretrain.yaml
./primus-cli
direct
--
train
pretrain
--config
"
$EXP
"
将上述运行从 GDN 改为 KDA 只需一处编辑:将 EXP 指向 kda_300M_BF16-pretrain.yaml 即可。在 Slurm 集群上,从登录节点启动,Primus 检出位于共享文件系统上。primus-cli 在每个节点上启动一个容器,将检出挂载到其中并转发 HF_TOKEN;通过 --env 从 environment 部分传入另外两个设置。没有 Slurm 时,在每个节点的容器内运行直接模式命令,并设置 rendezvous 变量:
# Slurm
export
EXP
=
examples/megatron/configs/MI355X/zebra_llama_mamba_8B_BF16-pretrain.yaml
./primus-cli
slurm
srun
-N
4
--
container
\
--env
PYTORCH_CUDA_ALLOC_CONF
=
expandable_segments:True
--env
PRIMUS_FLA_MLA_ATTN
=
0
\
--
train
pretrain
--config
"
$EXP
"
# without Slurm, on each node (NODE_RANK=1 on the second node)
export
NNODES
=
2
NODE_RANK
=
0
MASTER_ADDR
=./primus-cli
direct
--
train
pretrain
\
--config
examples/megatron/configs/MI355X/zebra_llama_mamba_8B_BF16-pretrain.yaml
300M 配置附带一个刻意精简的配方,包括 micro-batch 2、global batch 16 和 50 次迭代,以便训练本身快速完成并确认软件栈正常运行。请注意,首次启动预计会花费更长时间,因为启动器的 setup 钩子会在训练开始前安装训练依赖,而这些依赖未被缓存。
要复现下面报告的结果,请将 micro_batch_size 增加到 128,将 global_batch_size 增加到 1024,这对应于八块 GPU 在 micro-batch 为 128 且无梯度累积的情况。每个配置都记录了已验证可在单块 MI355X 上容纳的最大 micro-batch。
结果 #
所有结果均在单节点八块 AMD Instinct MI355X GPU 上获得,序列长度为 2048,使用 bfloat16,采用发布的配置以及上述环境设置。
复现这些结果取决于两个运行时设置。混合配置默认使用分块的 fused_ce_mode: 1,该模式优先考虑内存效率;将 fused_ce_mode: 2 设置为这些结果中使用的高吞吐量模式,并设置 PRIMUS_FLA_MLA_ATTN=0。
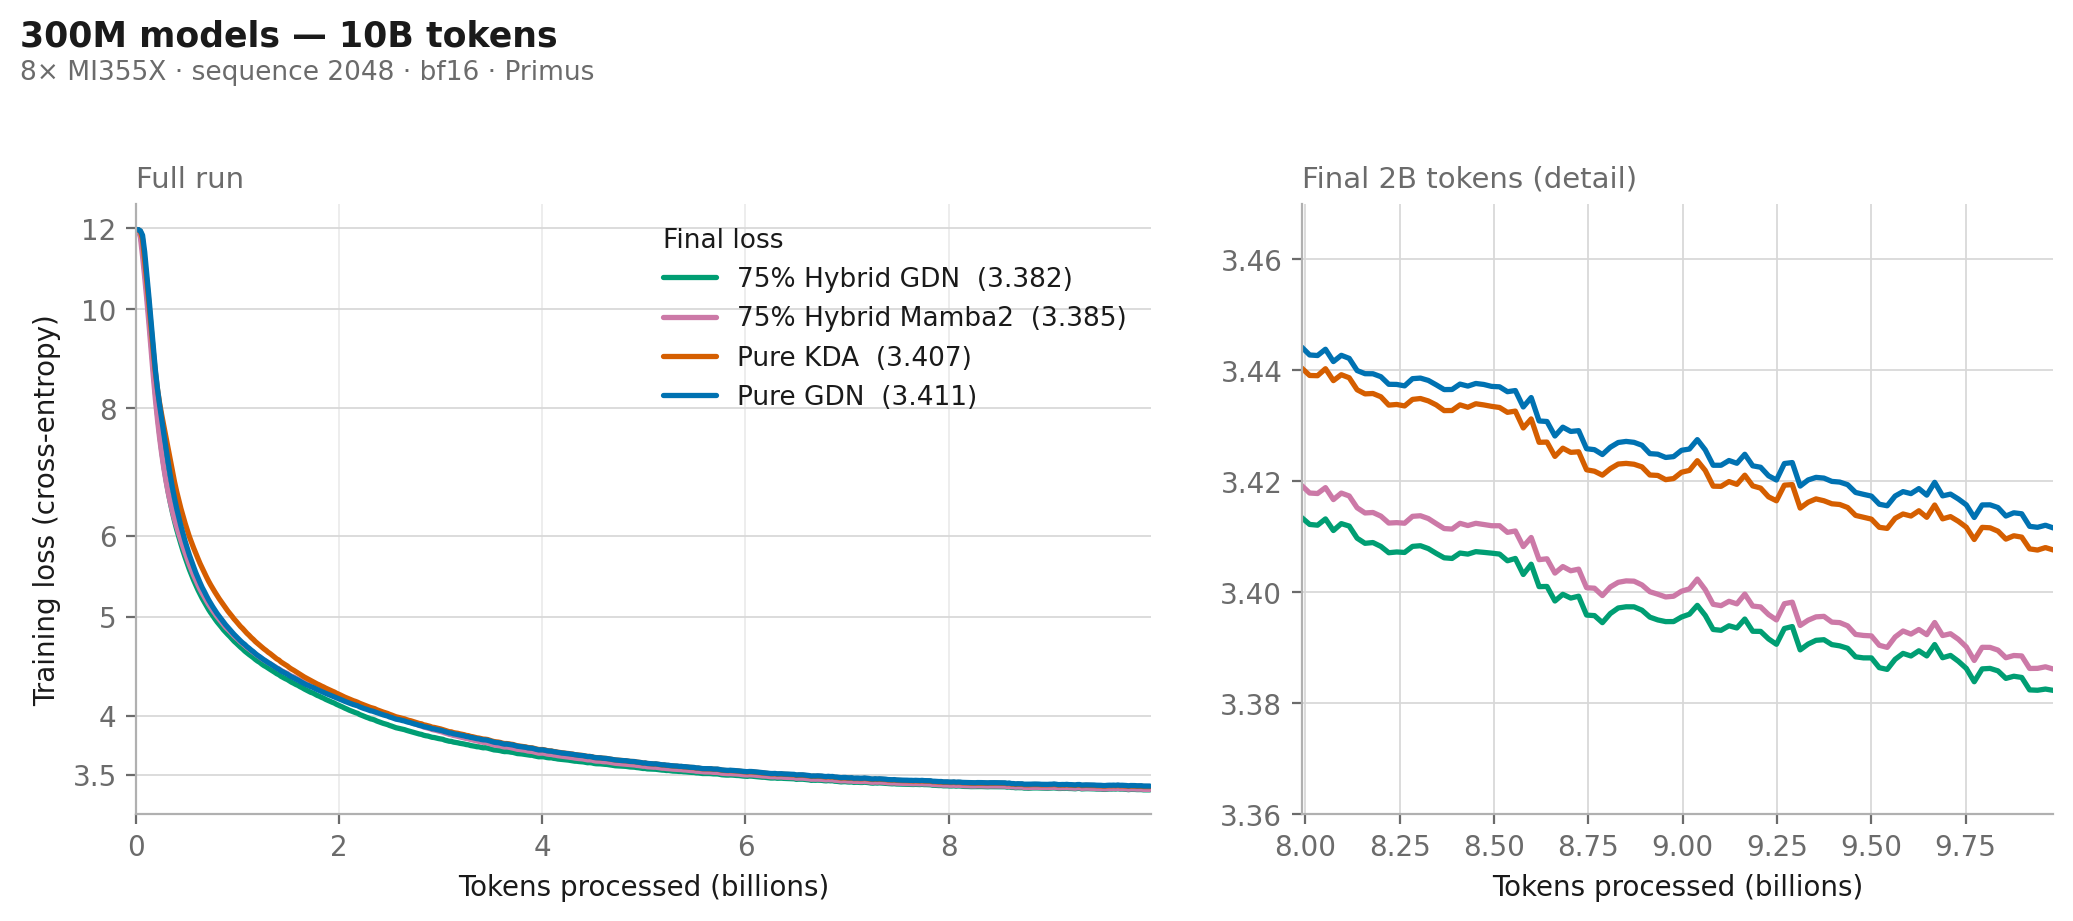
下图显示,与其他模型相比,我们仅使用三个注意力层的混合模型实现了最低的损失:
损失曲线 #
下图分别展示了五次运行的训练损失,从 1B 模型开始:
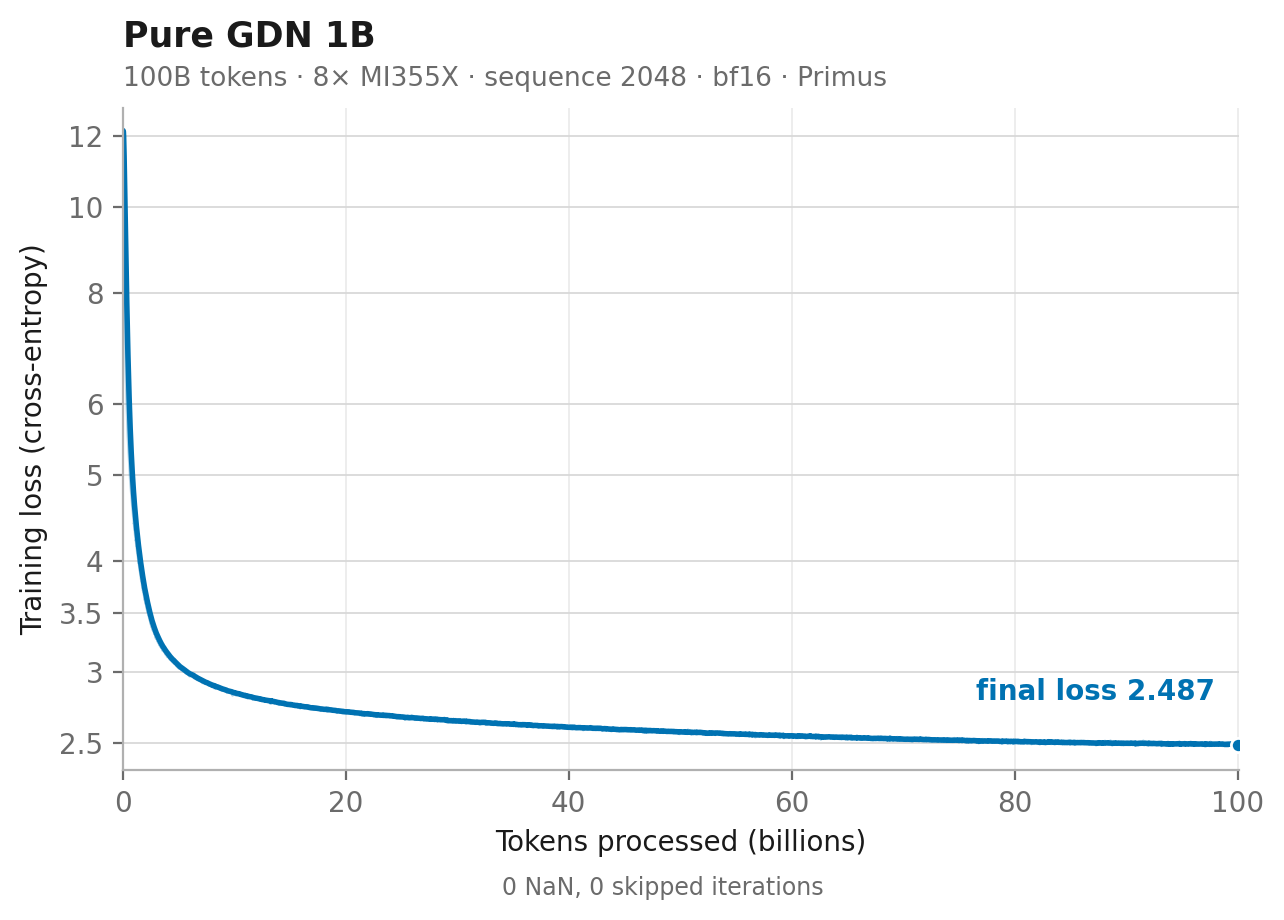
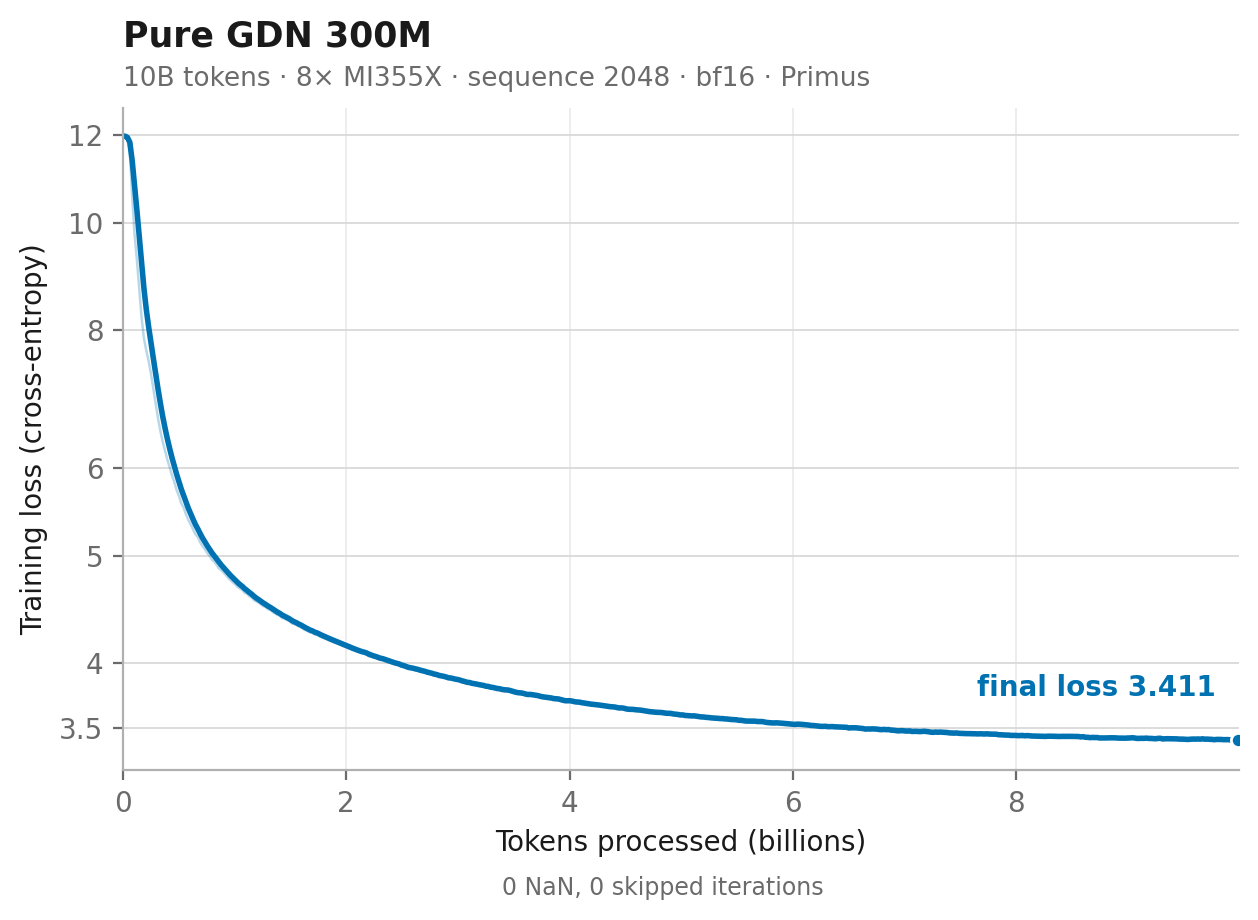
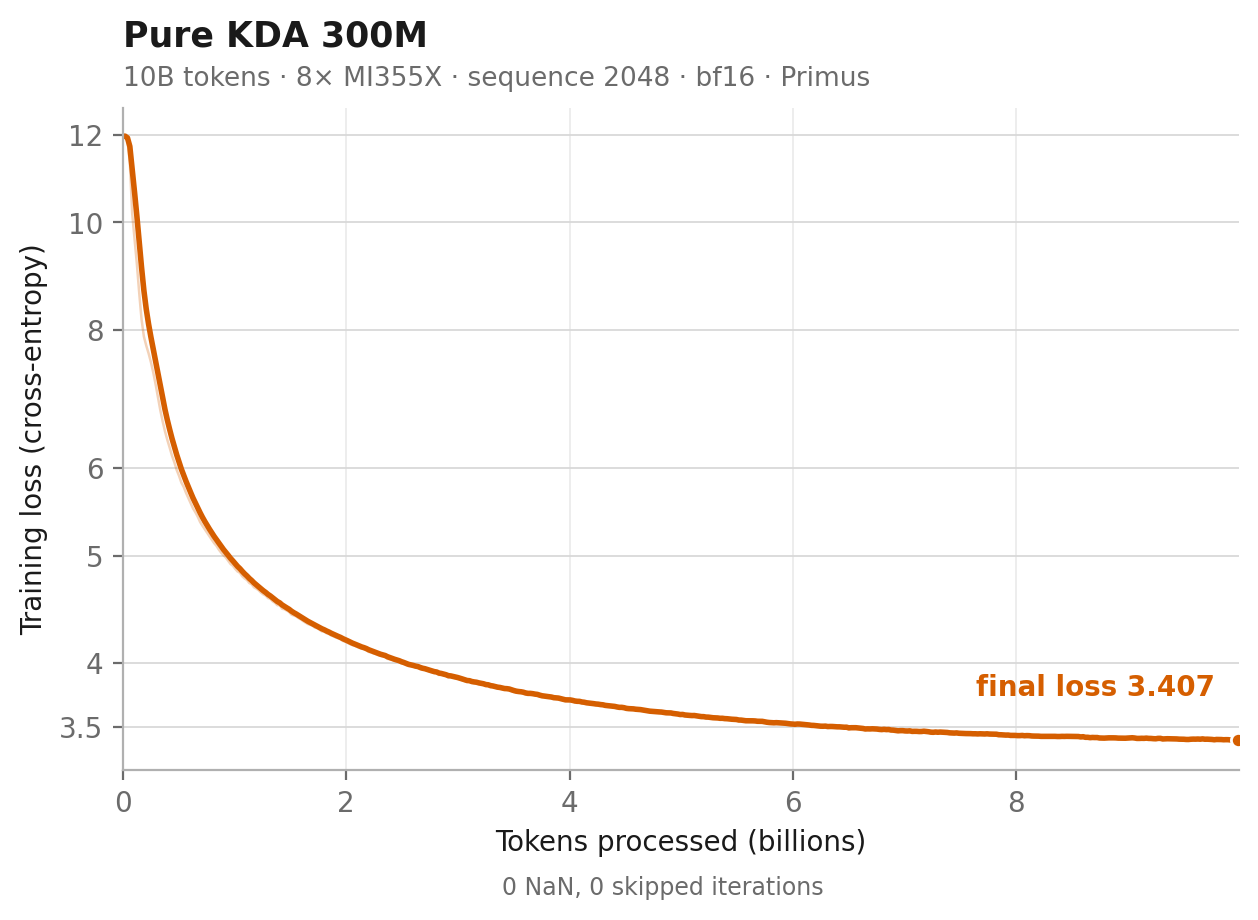
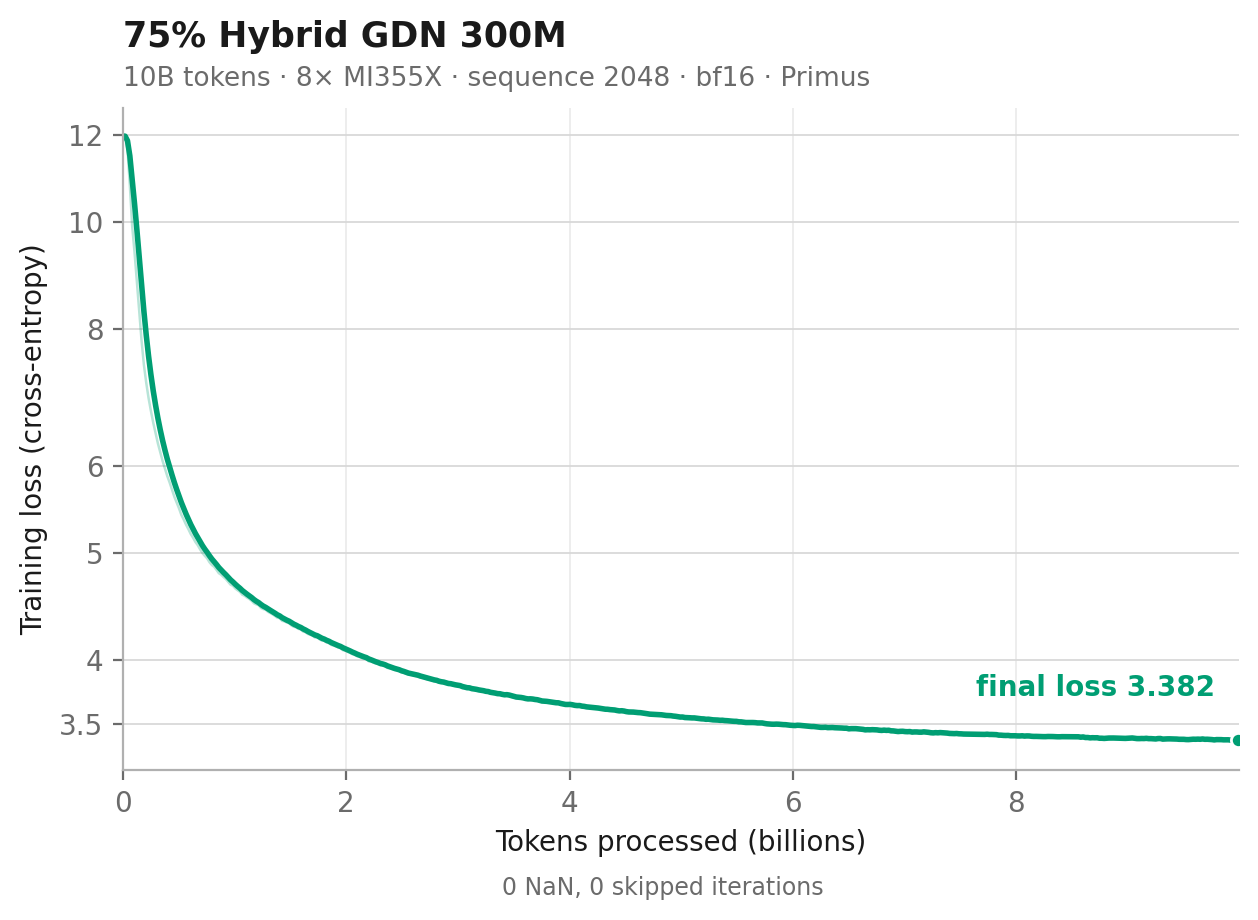
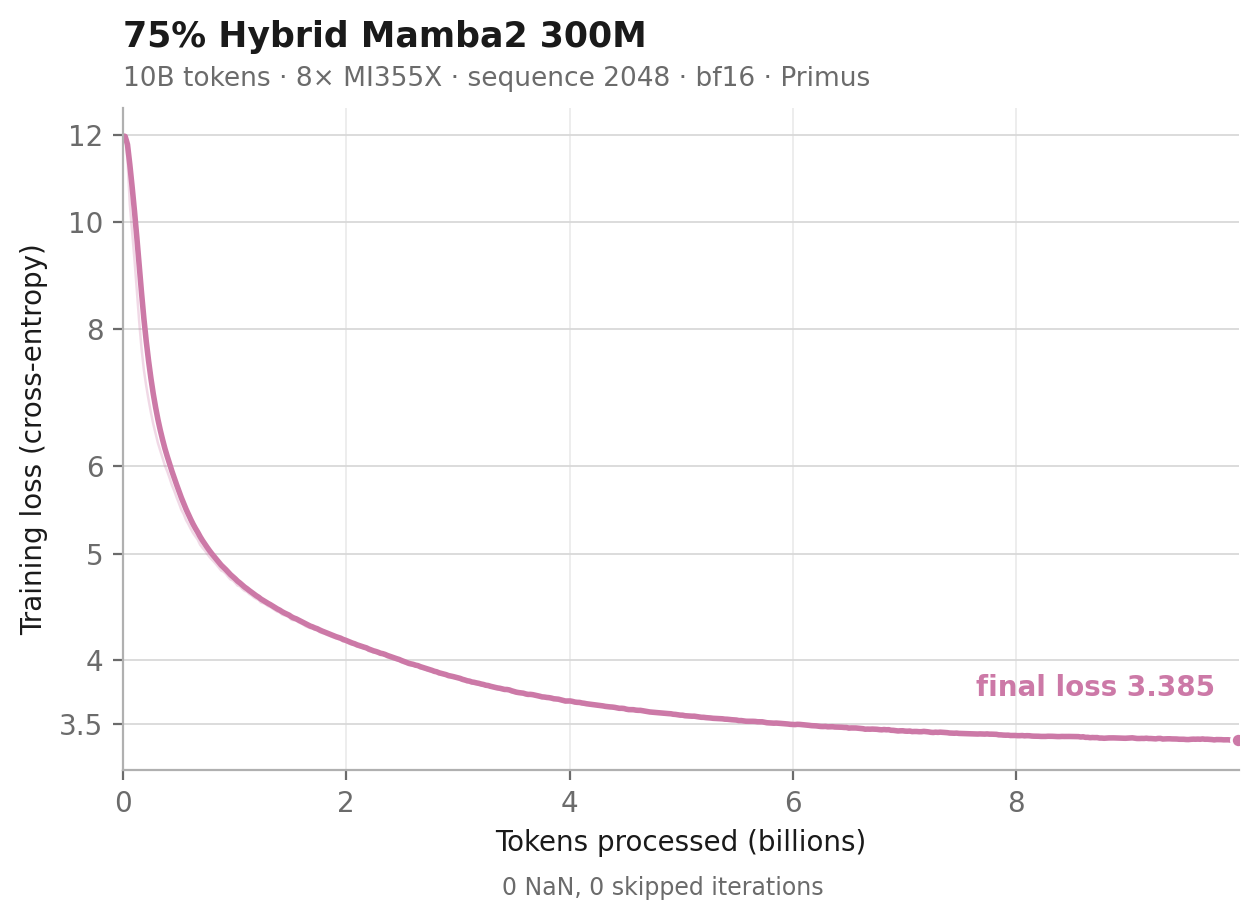
所有五条曲线均平滑下降,没有损失尖峰、没有发散,也没有恢复事件。1B 运行中任意单步的最大增幅为 0.03。
下游评估 #
下表报告了来自 lm-evaluation-harness [ 10 ] 的零样本准确率。纯线性模型在使用 tools/hybrid/ 中的转换器转换为 Hugging Face 格式后进行评测,混合模型则直接从 Megatron 检查点评测。
| 任务 | 指标 | GDN 1B (100B) | GDN 300M | KDA 300M | Hybrid GDN 300M | Hybrid Mamba2 300M |
| --- | --- | --- | --- | --- | --- | --- |
| arc_easy | acc | 0.6869 | 0.4764 | 0.4823 | 0.4684 | 0.4769 |
| arc_easy | acc_norm | 0.6183 | 0.4285 | 0.4335 | 0.4263 | 0.4293 |
| arc_challenge | acc | 0.3396 | 0.1937 | 0.1980 | 0.1817 | 0.1937 |
| arc_challenge | acc_norm | 0.3618 | 0.2287 | 0.2406 | 0.2287 | 0.2321 |
| hellaswag | acc | 0.4091 | 0.2750 | 0.2770 | 0.2752 | 0.2749 |
| hellaswag | acc_norm | 0.5212 | 0.2826 | 0.2876 | 0.2875 | 0.2864 |
| openbookqa | acc | 0.2640 | 0.1580 | 0.1660 | 0.1720 | 0.1600 |
| openbookqa | acc_norm | 0.3900 | 0.3000 | 0.2940 | 0.2920 | 0.3120 |
| piqa | acc | 0.7198 | 0.6066 | 0.6077 | 0.6121 | 0.6192 |
| piqa | acc_norm | 0.7220 | 0.6050 | 0.6121 | 0.5958 | 0.6072 |
| winogrande | acc | 0.5462 | 0.4807 | 0.5028 | 0.5209 | 0.4909 |
| race | acc | 0.3311 | 0.2498 | 0.2545 | 0.2660 | 0.2651 |
表 5:所有五个模型的零样本准确率。
这些结果总结了本研究的实际结论。在 10B token 的固定预算下,混合器(mixer)的选择对下游准确率几乎没有影响,但吞吐量差异可高达 1.75 倍,这使其主要是一个性能决策而非质量决策。真正提升质量的是 token 预算:1B 模型在 100B token 下,在大多数任务上比 300M 模型高出约十到二十分。这建议的策略是选择在可用硬件上训练最高效的混合器,然后将节省的资源再投资于额外的 token。
我们学到了什么 #
第一个经验是,在 Primus 中,混合层堆叠只是一个配置字符串。注意力、线性循环和 MLP 子层通过单个 hybrid_override_pattern 字段交错排列,因此尝试新架构意味着编辑一行代码,而不是编写新的模型代码。
这种灵活性之所以重要,是因为在固定的 token 预算下,mixer 的选择最终被证明是一个性能决策,而非质量决策。四个 300M 模型之间的 loss 差距在 0.03 以内,在几乎所有下游任务上的差距也在两个点以内,但吞吐量差异却高达 1.75 倍。真正提升质量的是 token 预算。在 100B tokens 上运行的 1B 模型在大多数任务上比 300M 模型高出大约十到二十个点,远超在 10B tokens 下所做的任何架构选择。
加入少量 attention 也被证明成本低廉且值得。在十二个 mixer 中放置三个 MLA 块,吞吐量下降不到 3%,而该模型在 300M 运行中产生了最低的 loss。
该配方在扩展时同样有效。1B 运行在 95,368 次迭代中,loss 从 12.17 降至 2.487,单步最大增幅为 0.03,没有 NaN 值,也没有跳过迭代。
最后,环境也是配方的一部分。allocator 设置和 MLA wrapper 变量各自对吞吐量或容量的影响都超过大多数超参数,而两者都不出现在配置文件中。当你复现这些运行时,请像对待 YAML 本身一样谨慎地对待这些设置。
总结 #
在本博客中,你探索了 Primus 如何从单个配置字符串预训练混合语言模型——可理解为 MLA attention、线性循环 mixer 和 MLP 块的任意交错组合——同时保留使每种子层类型高效的融合内核。你了解了配方、那些悄然影响结果的环境设置,以及在单节点八块 AMD Instinct MI355X GPU 上完成的五次运行。在这些运行中,mixer 的选择使吞吐量变化高达 1.75 倍,而对 loss 或下游准确率几乎没有影响。75% 混合模型引入了三个 MLA 块,吞吐量损失不到 3%,并取得了该组中最低的 loss,而一个 1B 模型完成了 100B tokens,没有 NaN 值,也没有跳过迭代。所有报告数字背后的配置都包含在代码仓库中。
现在训练你自己的混合模型吧。从已发布的配置之一开始,用一行编辑替换 mixer,并将你的吞吐量和 loss 与本文中的数字进行比较。关于这项工作的 upcycling 对应部分——将现有 Transformer 检查点转换为相同的混合架构——请参阅配套博客 Zebra-HyLo: Upcycling Transformers into Long-Context Hybrid LLMs on AMD Instinct™ GPUs。我们的团队正在继续这一方向的工作:研究高效模型架构,推进混合模型和 upcycling 研究,并让 Primus 在 AMD Instinct GPU 上更快。请关注 ROCm Blogs 上的后续文章。
其他资源 #
代码:Primus,混合配置位于 examples/megatron/configs/
混合模型:AMD-Hybrid-Models,AMD 的混合模型配方和代码集合,包括 Zebra-Llama 和 HyLo
算子:Primus-Turbo
线性 attention 内核:flash-linear-attention
基础镜像:Docker Hub 上的 rocm/primus:v26.7
文档:Training a model with Primus and Megatron-LM 和 Pretraining workflows
关于 upcycling 到相同架构的相关工作:HyLo 和 Zebra-Llama
配套博客:Zebra-HyLo: Upcycling Transformers into Long-Context Hybrid LLMs on AMD Instinct™ GPUs,涵盖相同混合架构的 upcycling 方面
免责声明 #
本文档中提供的信息仅供参考,可能包含技术不准确、遗漏和排版错误。本文所含信息可能会发生变化,并可能因多种原因而变得不准确,包括但不限于产品和路线图变更、组件和主板版本变更、新模型和/或产品发布、不同制造商之间的产品差异、软件变更、BIOS 刷新、固件升级等。任何计算机系统都存在无法完全预防或缓解的安全漏洞风险。AMD 没有义务更新或以其他方式更正或修订此信息。但是,AMD 保留修订此信息并不时更改其内容的权利,且无义务通知任何人此类修订或更改。此信息按“原样”提供。AMD 对此处内容不作任何陈述或保证,并且对此信息中可能出现的任何不准确、错误或遗漏不承担任何责任。AMD 明确否认任何关于不侵权、适销性或特定用途适用性的默示保证。在任何情况下,AMD 均不对任何人因使用本文所含任何信息而导致的任何依赖、直接、间接、特殊或其他后果性损害承担责任,即使 AMD 已明确被告知此类损害的可能性。AMD、AMD Arrow 标志及其组合是 Advanced Micro Devices, Inc. 的商标。本出版物中使用的其他产品名称仅用于识别目的,可能是其各自公司的商标。© 2026 Advanced Micro Devices, Inc. 保留所有权利
第三方内容由拥有该内容的第三方直接许可给您,而非由 AMD 许可给您。所有链接的第三方内容均按“原样”提供,不附带任何形式的保证。使用此类第三方内容完全由您自行决定,在任何情况下 AMD 均不对您因任何第三方内容承担责任。您承担所有风险,并对因使用第三方内容而可能产生的任何损害承担全部责任。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:AMD ROCm Blog
原创地址:https://rocm.blogs.amd.com/artificial-intelligence/primus-hybrid-llm/README.html
原文作者:Vansh Bhatia, Claire Lee, Aref Jafari, Mehdi Rezag;如有侵权,请联系管理员删除。

