我们为什么要做这件事
在过去十年的大部分时间里,我们的指标管道运行在 gostatsd 上,这是我们维护的开源 StatsD 实现。它主要做两件事:作为每台主机上的 sidecar,以及另一端的聚合层。它以 99.95% 的 SLO 和极低延迟从 14 个区域的约 10 万台主机接收指标,而且运行良好。没人过多关注它,这通常是良好基础设施的标志。
Gostatsd 为我们服务了很多很多年。然而,在过去几年里,社区持续且一致地转向 OpenTelemetry。它成为了所有人标准化的选择,而越来越多输入我们管道的数据都在发出我们根本不支持的 OTel 数据。Gostatsd 仅支持 UDP,对 traces 或 logs 没有任何方案,而 OTel Collector 社区发布的每一个巧妙功能,都是我们最终为了不掉队而不得不手工重建的东西。我们终将输掉这场竞赛。这只是时间问题。
所以“为什么”很容易回答。我们在这里讨论的是“怎么做”。可观测性已经接入数千个服务和许多不同的定制平台,显而易见的计划(拆除旧管道,让每个团队基于 OTel SDK(软件开发工具包) 重新埋点,然后切换开关)只是白日梦:这是一场持续数年、全组织范围的苦战,而这条管道不能停机,且极有可能丢失告警所依赖的确切数据。
我们真正需要回答的问题更具体。我们如何在不给 Atlassian 各项服务带来巨大影响的情况下替换整个引擎?
我们的赌注:替换采集和管道,保持接口不变
指标管道实际上是一份两端之间的契约。一端是服务所有者看到的:“通过 UDP 将 StatsD 发送到这个地址 → 你的指标就会出现在后端。”另一端是那个数据包与长期存储之间的一切。团队极其关心第一端,而几乎不关心中间层。因此我们保留了接口,重建了其背后的一切,从而将一场全组织范围的迁移转变为平台团队的迁移。
随之而来的是两件事。我们在四个阶段(采集、摄取、聚合、转发)分别部署了专门构建的 OTel Collector 发行版,这样我们就可以在不影响其他阶段的情况下处理任何一个阶段。我们还让采集端同时支持 StatsD 和 OTLP:在我们开始之前,没有人需要把 StatsD 客户端换成 OTel SDK。OTel Collector 在 Atlassian 内部并非新事物,这一点也帮了忙:tracing 团队多年来一直将它作为管道核心和主机指标 sidecar 运行,所以“它在我们这个规模下是否已可用于生产?”这个问题早已有了答案。
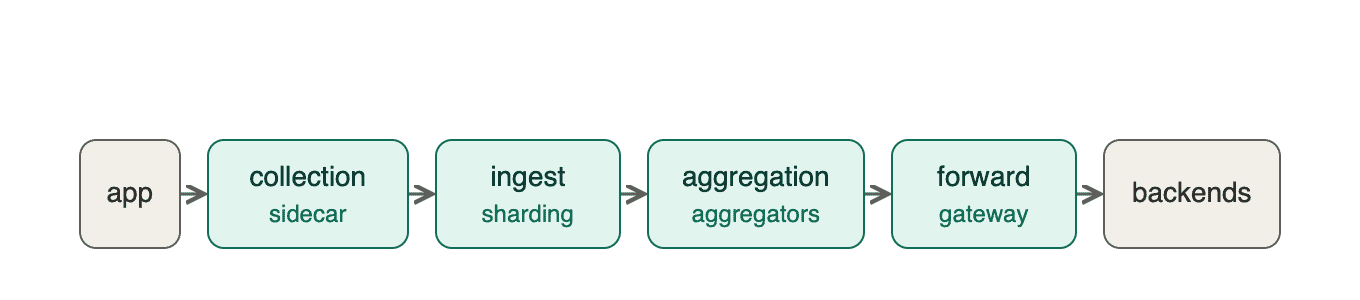
我们实际构建了什么
迁移是就地一步步进行的。
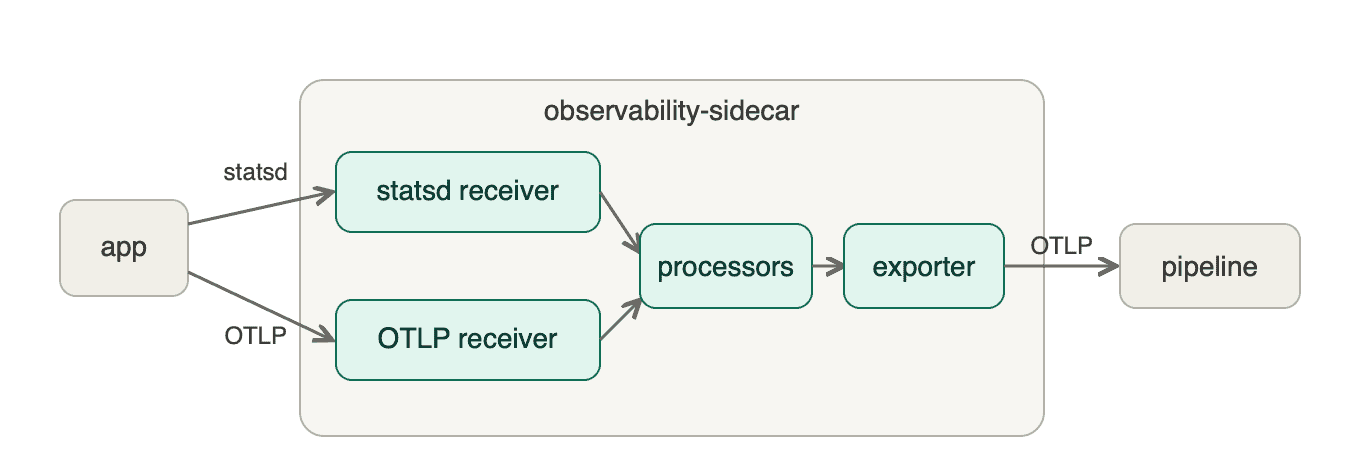
采集。我们用 OTel Collector 发行版替换了 gostatsd sidecar,这与追踪团队已经部署的版本相同,同时保持应用侧完全一致:应用程序仍像以前一样通过 UDP 发送 StatsD。第一天,没有任何团队察觉。好处是你不再需要在每台主机上运行两个 sidecar(一个 StatsD 和一个追踪)。将指标合并到追踪 sidecar 中并移除 StatsD sidecar,在我们最昂贵的 Micros 服务中平均每个服务节省了约 3.9% 的 CPU,在集群规模下大约削减了 30% 的 sidecar 成本。同时,我们启用了 OTLP receiver,使我们的采集层能够原生接收和转发 OTEL 指标。
摄取。聚合是有状态的:时间序列的每个数据点都必须到达同一个聚合器,因此不能只使用传统的负载均衡策略。多年来,一个内部代理(称为 nomad)通过对 (service, environment) 进行哈希到分片来保证这一点。但我们的服务到指标的负载分布是不均匀的,遵循长尾分布,拥有最大服务的分片变成了热分片。我们的解决方案是更好的路由策略:contrib loadbalancingexporter 可以按 streamID(单个时间序列的身份标识)而不是按服务进行哈希,这样一个大服务可以均匀地分散到整个池中,而任何给定的序列仍然始终落在同一个分片上。
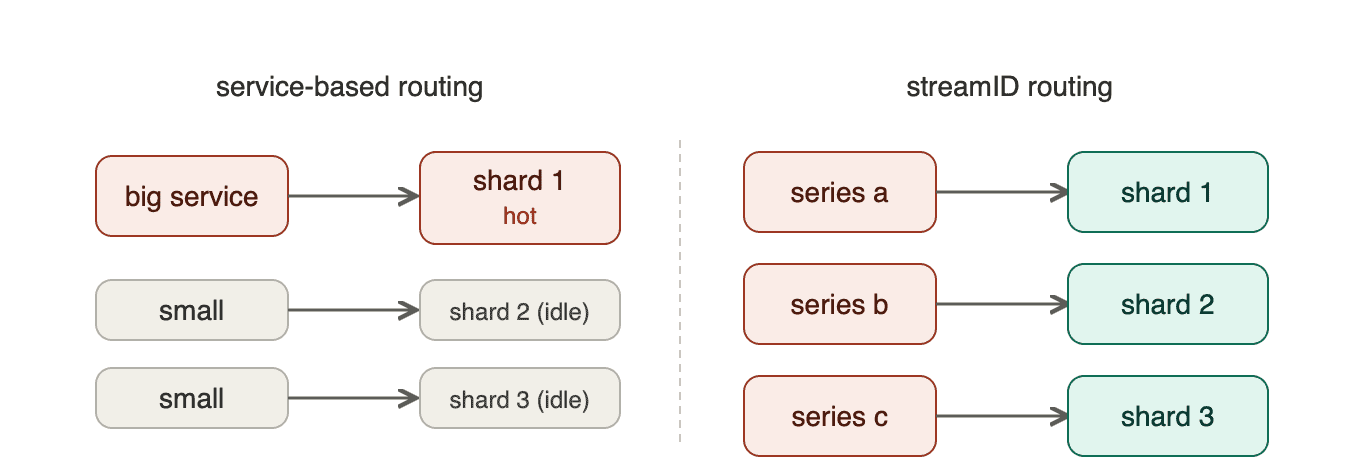
经过这一变更:每个分片的 CPU 从几根高柱和空闲副本变成了平坦、均匀的分布。均匀负载意味着更紧的自动扩缩容区间、真正的低谷缩容,以及不再有热分片告警!
聚合。这是让数字变得可承受的阶段:我们每分钟接收约 48 亿个数据点,最终落地约 2.2 亿个,大约减少了 96%。我们的大部分指标是 delta 时序,上游没有任何东西按照用户期望的方式聚合 delta,所以我们编写了自己的 delta 聚合处理器,并以 atlassian-labs 开源。相同的流量下,聚合层现在运行的 CPU 约为之前的一半(聚合器不再解析 gostatsd,负载均匀,并且我们继承了社区的调优)。
转发。最后一跳:一个定制的内部转发器,变成了基于上游 exporter 构建的无状态 Collector 发行版(metrics-gateway)。扇出到多个后端(SignalFx、S3 等),无需自定义后端集成;默认支持社区提供的重试、队列和背压。添加一个目标只是配置变更,而不是一个项目。这是最简单的一个。
Lambda。Serverless 无法运行 sidecar,因此我们构建了一个 OTel Lambda 扩展来替换 gostatsd 的那个,使用相同的 StatsD 地址、相同的环境变量,无需修改代码。这完成了采集层,将指标从服务转发到我们的管道。
这在更大图景中的位置
将每个阶段都迁移到 OTel Collector 上,让我们拥有了一个代码库和一种运维方式。向管道添加内容意味着编写一个组件,而不再是搭建一个服务。它解锁了基于 OTEL 的插桩,同时我们不必放弃使我们的规模可承受的聚合和成本控制,并且它让我们能够在摄取时丢弃浪费的数据点,这是最便宜的时机。仅从成本来看,最终状态就是值得的:gostatsd 聚合器和 nomad 合计约占我们指标集群中 CPU 请求的 38%,仅 Nomad 就占总资源的约 13%。移除它们是实实在在的节省,也是我们与端到端 OpenTelemetry 管道之间的最后障碍。
开始前我们告诉自己的话
选择正确的早期采用者。找到那些获益最多并愿意与你一起迭代的团队。从开发和预发布工作负载以及感受痛苦最深的服务入手,让我们快速获得了真实信号,来自那些在我们摸索粗糙边缘时给予包容的人。
在生产环境中持续进行性能分析。一个组件(无论是我们的还是上游的)的真实成本和表现只有在生产负载下才会显现。小型测试和基准测试是不够的;生产环境中的持续性能分析才真正告诉我们该在哪里优化。
匹配运维工作流。这种规模的迁移会持续数月甚至数年,其中大部分时间你都在同时运维新旧两套系统。尽可能降低运行两套系统的开销:沿用相同的运维原语并保持一致性,这样没有人需要学习第二种做事方式。
渐进式发布。从较低环境开始,先从不那么关键的服务入手,然后逐步扩大 1% → 10% → 50% → 100%。你要在问题代价低的地方发现问题,而不是在 tier-0 路径上。
下一步
我们现在已经为用户将指标插桩迁移到 OpenTelemetry 扫清了障碍。下一步是左移:将插桩本身迁移到 OpenTelemetry SDK 上,摆脱我们多年来一直维护的供应商和内部客户端(Datadog/DogStatsD、StatsD 库)。
我们还将开始进一步探索 OpenTelemetry 生态系统,以解决我们面临的更多大规模可观测性问题,这些问题社区已经解决,同时随着我们通过使用和规模推动 OpenTelemetry 的发展,我们也将开始回馈社区。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:CNCF Blog
原创地址:https://www.cncf.io/blog/2026/09/17/opentelemetry-everywhere-migrating-a-metrics-platform-at-scale/
原文作者:Iris Grace Endozo, Farzad Vazirnia and Albert Kerr;如有侵权,请联系管理员删除。

