从门户跳转到即时答案:HEMA 使用 MCP 和 Amazon Bedrock 的历程 | Amazon Web Services
本文由 HEMA 的 Mauro Rallo 和 Patrick van der Plas 共同撰写。
当 HEMA 的工程师需要答案时,他们不得不跳转于各个门户之间,在彼此割裂的 wiki、服务目录和 IT 门户中寻找。为了将这种摩擦转化为即时答案,这家拥有百年历史的荷兰零售商在 Amazon Bedrock AgentCore 上构建了一个知识层。HEMA 在多个国家拥有超过 750 家门店,由一支由工程师、产品负责人和业务分析师组成的技术组织推动数字化转型。它需要一个能够跨角色和跨工具运作的解决方案。
多年来,HEMA 悄然构建了一些有价值的东西:一幅关于自身技术版图的庞大而结构化的图景。一个服务目录将人员映射到团队,团队映射到服务,服务映射到我们暴露的 API(应用程序编程接口),以及我们支持的业务能力。问题从来不是知识不存在,而是知识难以获取。随着工程组织的壮大,非正式的“问问旁边的人”模式失效了,团队最终将答案分散在门户、wiki 和文档中,而很少有人知道如何浏览这些内容。
在本文中,我们描述了 HEMA 在内部知识碎片化方面面临的挑战,我们为何选择使用 Model Context Protocol (MCP) 和 Amazon Bedrock AgentCore 来构建 HAL——HEMA 的内部 AI 助手,以及它如何改变了我们团队的工作方式。
这一构想基于两个互补的目标。HAL 将知识集中在一处,而 MCP 将知识传递到人们已经使用的工具中(HAL 聊天、Kiro、Claude 和其他智能体)。安全性锚定在 Microsoft Entra ID 上,客户端不持有 AWS 凭证。最初作为开发者工具的东西,如今已经是一个跨角色的助手。同样的架构将成为下一步的基础:将 HAL 从只读知识层转变为行动层。
挑战:门户跳转与知识碎片化
HEMA 的知识问题有两个不同的层面。
第一个层面,即结构化的基础设施知识,实际上状况良好。多年来,HEMA 一直维护着一个服务目录,记录了技术资产如何组合在一起:哪些团队拥有哪些服务,这些服务暴露了哪些 API,以及它们如何映射到业务能力。来自产品信息管理 (PIM) 引擎和数据网格表等系统的结构化数据已被导入并组织好。对于任何关于存在什么以及谁拥有它的问题,答案通常是可获取的,只要你知道去哪里找。
第二个层面则是缺口所在。知道存在什么,并不等同于知道如何做某事。“我如何申请访问某个 API?我如何获得一个新组的配置?我们对 X 的规则是什么?”这些流程性问题没有单一的归属地。当团队规模小、大家彼此认识时,这没问题。人们直接问就行。随着 HEMA 的发展和新工程师的加入,这种模式不再可扩展,而且几乎没有书面文档可以作为依靠。
这导致了新员工入职缓慢、答案因查找位置不同而不一致、频繁的上下文切换,以及将人们从实际工作中拉走的摩擦。曾经需要浏览三四个门户、有时耗费整个下午才能找到的答案,如今可以在几秒钟内,从集成开发环境 (IDE) 或聊天窗口中获取。
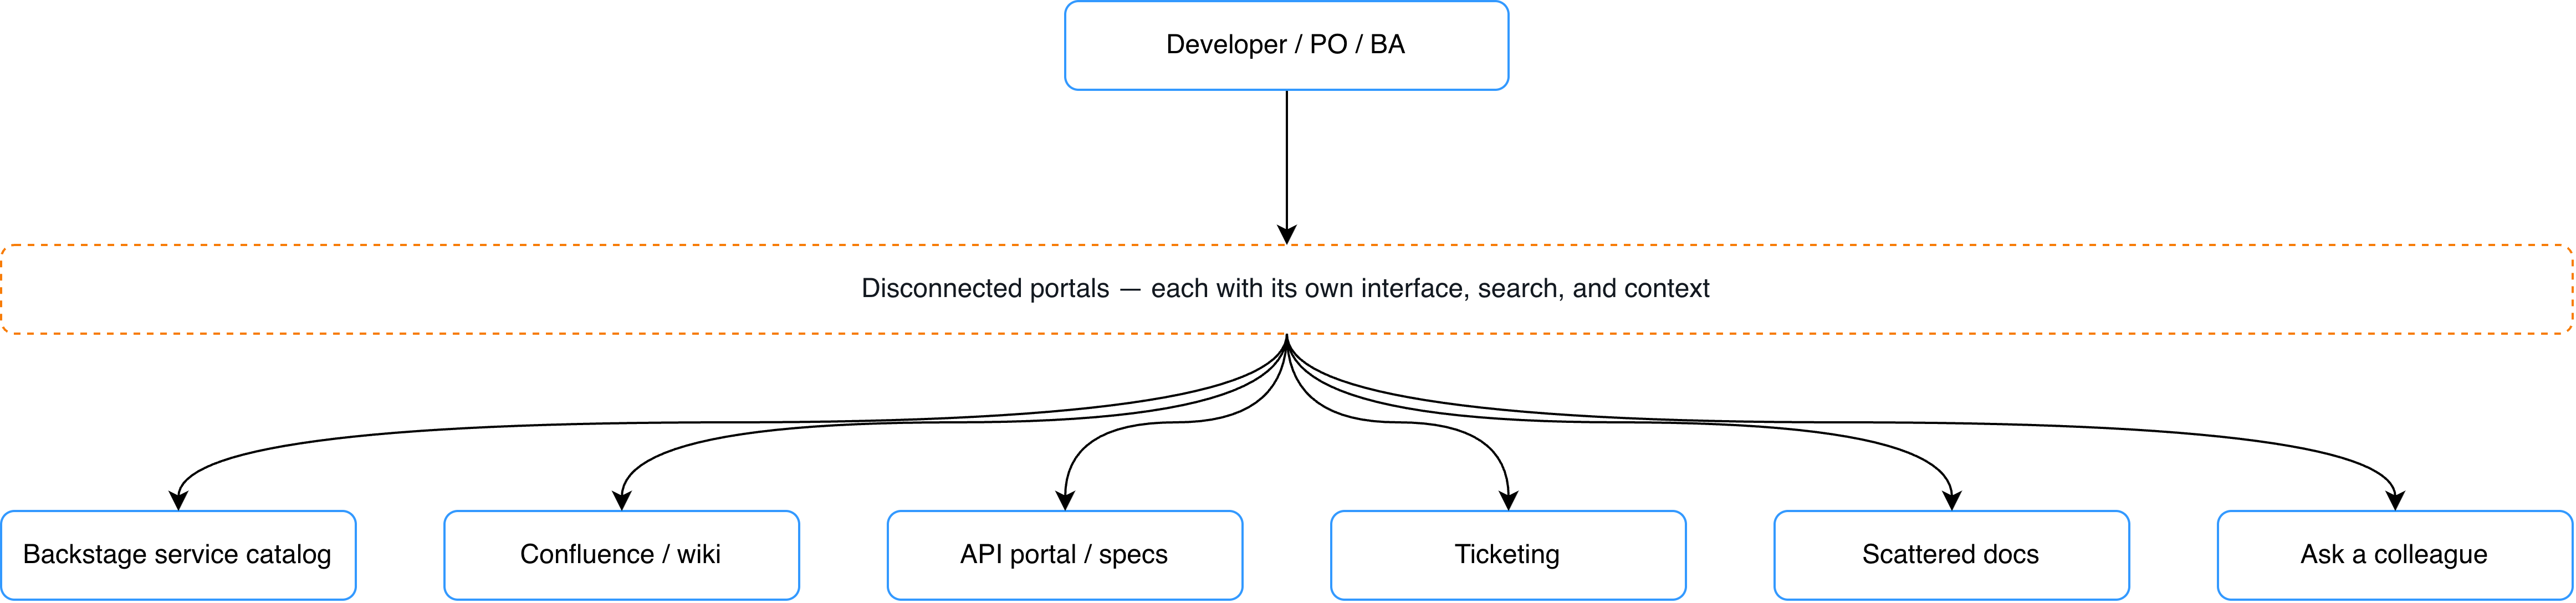
图 1:“之前”状态,展示了用户不得不查阅的各个来源
为什么选择 MCP 和 Amazon Bedrock AgentCore
两个目标塑造了该解决方案,它们与我们选择的两项技术完美对应。
第一个目标属于 HAL:将 HEMA 分散的知识整合为一个受治理的单一事实来源。第二个目标属于 MCP:将知识传递到人们已经工作的地方,而不是迫使他们访问另一个门户。
为什么选择 MCP:Model Context Protocol 为我们提供了 AI 客户端与后端能力之间的标准化接口。我们无需为每个知识源构建定制集成,也无需为每个客户端应用程序重新构建,而是将每个来源一次性暴露为 MCP 工具。
兼容 MCP 的客户端,如 HAL 网页聊天、Kiro、Claude 和其他智能体,随后可以消费相同的工具,无需定制工作。这正是“从日常工具中访问”变得切实可行,而非每个工具单独工程化项目的原因。
为什么选择 Amazon Bedrock AgentCore:Amazon Bedrock AgentCore 是一个平台,可使用任何框架或模型大规模构建、连接和优化智能体。对于 HEMA 而言,这意味着无需搭建和运营自定义 MCP 服务器基础设施即可构建 HAL。最重要的能力包括:
Gateway 将 OpenAPI 规范和 AWS Lambda 函数直接转换为 MCP 工具。无需编写或运行自定义 MCP 服务器代码。
Identity 提供托管的入站 JSON Web Token (JWT) 身份验证和托管的出站 OAuth2(令牌保管库)到我们的内部 API。
Runtime 将内部智能体(使用 Strands 框架构建)作为容器托管。
Memory 和 Amazon Bedrock Guardrails 提供对话记忆和内容过滤,支持欧盟推理区域和荷兰语。
这些共同为我们提供了适合企业的基础:Entra ID OAuth、当前只读访问,以及由现有 Active Directory 组驱动的访问控制,足够安全以暴露真实的内部知识。
逐步构建 HAL
HAL 并非一蹴而就。它通过两个深思熟虑的步骤成长起来。首先,团队构建了一个带有自己聊天 UI 的独立助手。然后,一旦该基础得到验证,我们通过 MCP 将其开放给人们已经使用的工具。
步骤 1:HAL 作为独立助手
HAL 的第一个版本是一个自包含的助手:一个 Web 聊天 UI(使用 Next.js 构建),后端由一个智能体(Agent(智能体))驱动,能够基于 HEMA 的知识回答问题。当时还没有 MCP,也没有外部客户端,只有 HAL UI 与 HAL 智能体进行通信。
HAL 智能体是一个 Strands 智能体,打包为 Linux/ARM64 容器,托管在 AgentCore runtime 上,同时配合 AgentCore memory(短期对话上下文)和 Amazon Bedrock Guardrails(Standard 层级,EU 跨区域推理以支持荷兰语)。AgentCore runtime 和 AgentCore memory 是 Amazon Bedrock AgentCore 的能力。
该智能体通过两条不同的路径获取知识:
本地工具,直接访问知识库。智能体的语义搜索工具是本地 Strands 工具,直接通过知识库调用 Amazon Bedrock Retrieve API,中间没有网关。这是最核心的“从知识库获取答案”路径。
通过 MCP 连接到 AgentCore Gateway,用于实时 API。对于实时数据、完整的 OpenAPI 规范、服务目录查询以及人员/团队查询,智能体通过 MCP 连接到自己的 AgentCore Gateway,这是 Amazon Bedrock AgentCore 的一项能力。该 Gateway 使用 AWS Identity and Access Management (IAM) SigV4 进行身份验证,进而调用我们的内部 API。
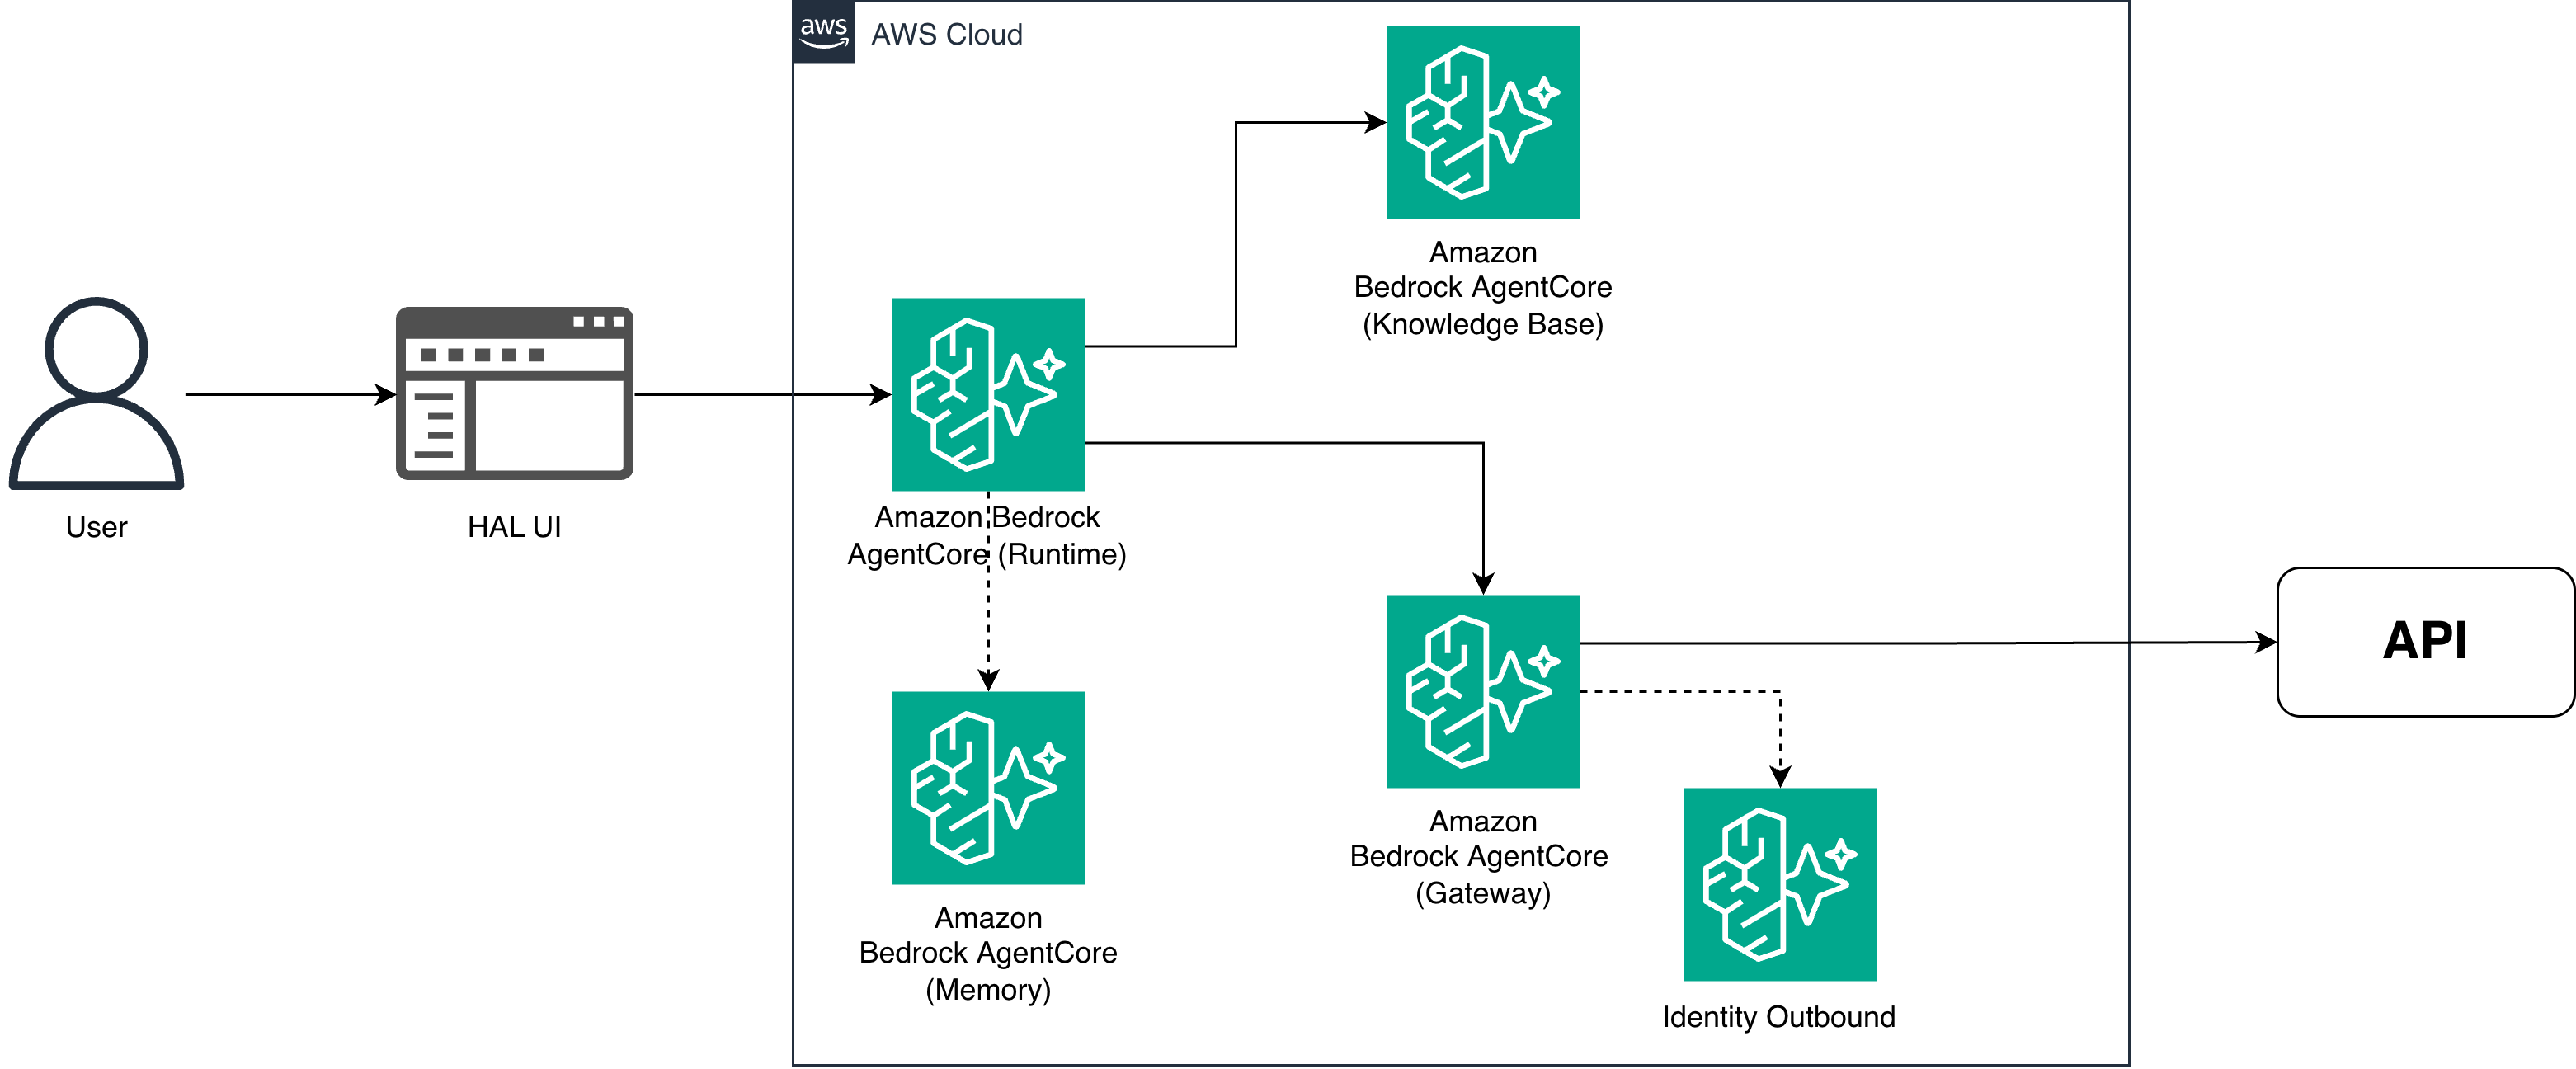
图 2:第 1 步,HAL 作为独立助手
我们从已有的结构化数据(服务目录)出发,并添加了价值最高的文档,按痛点和被询问的频率进行优先级排序。HAL 背后有多个基于 Amazon Bedrock Knowledge Bases 构建的知识库,这是完全托管的检索增强生成(RAG(检索增强生成))能力:IT 和操作指南文档、API/OpenAPI 规范、Kafka 事件流主题及其 Avro schema、数据整合层(DCL)数据交换通道,以及服务目录(人员、团队、服务和 API)。
没有自定义的 MCP 服务器代码。AgentCore Gateway 直接从 OpenAPI 规范为 API 直通目标生成 MCP 工具,并通过 Lambda 函数为知识库上的语义搜索生成工具。将 Gateway 直接指向现有的 API 规范并非理想的最终状态。为系统间使用而设计的 API 并不总能清晰地映射为智能体可以推理的工具,因此我们计划将这些定义重构为更智能体友好的工具。
不过目前,按原样暴露 API 以很小的投入带来了很高的价值。kb-search Lambda 封装了知识库上的 Amazon Bedrock Retrieve API。它通过 AWS Identity and Access Management (IAM) 限定到特定的知识库 Amazon Resource Name (ARN),以及对源文档 Amazon Simple Storage Service (Amazon S3) 存储桶的读取权限。
检索遵循两步模式:初始的知识库搜索回答大多数问题,当单个分块不够时,fetch_full_document 会拉取完整文档。通过 Amazon Bedrock 对语义查询进行重排序以及 team_id 元数据过滤来实现团队范围的查找,从而提升检索质量。
第 2 步:通过 MCP 将 HAL 开放给日常工具
HAL 在自己的聊天 UI 中运行良好,但人们还使用其他工具:他们的 IDE、他们的 AI 助手。第二步是让 Kiro 和 Claude 等外部 MCP 客户端能够访问相同的知识和工具,而无需分发 AWS 凭证。这意味着需要添加第二个 AgentCore Gateway,使用 Microsoft Entra ID 而非 IAM 进行身份验证。
由于一个 AgentCore Gateway 仅支持单一入站身份验证类型,我们无法将第 1 步中智能体的 IAM 身份验证 Gateway 复用于这些外部客户端。因此,我们添加了第二个 Gateway,即 Entra MCP Gateway,通过 Microsoft Entra ID 使用自定义 JWT 进行身份验证,专用于 Kiro 和 Claude 等外部 MCP 客户端。它仅与智能体 Gateway 共享只读知识库。没有共享代码,因此面向外部的接口可以独立演进或出现故障,而不会影响内部智能体。
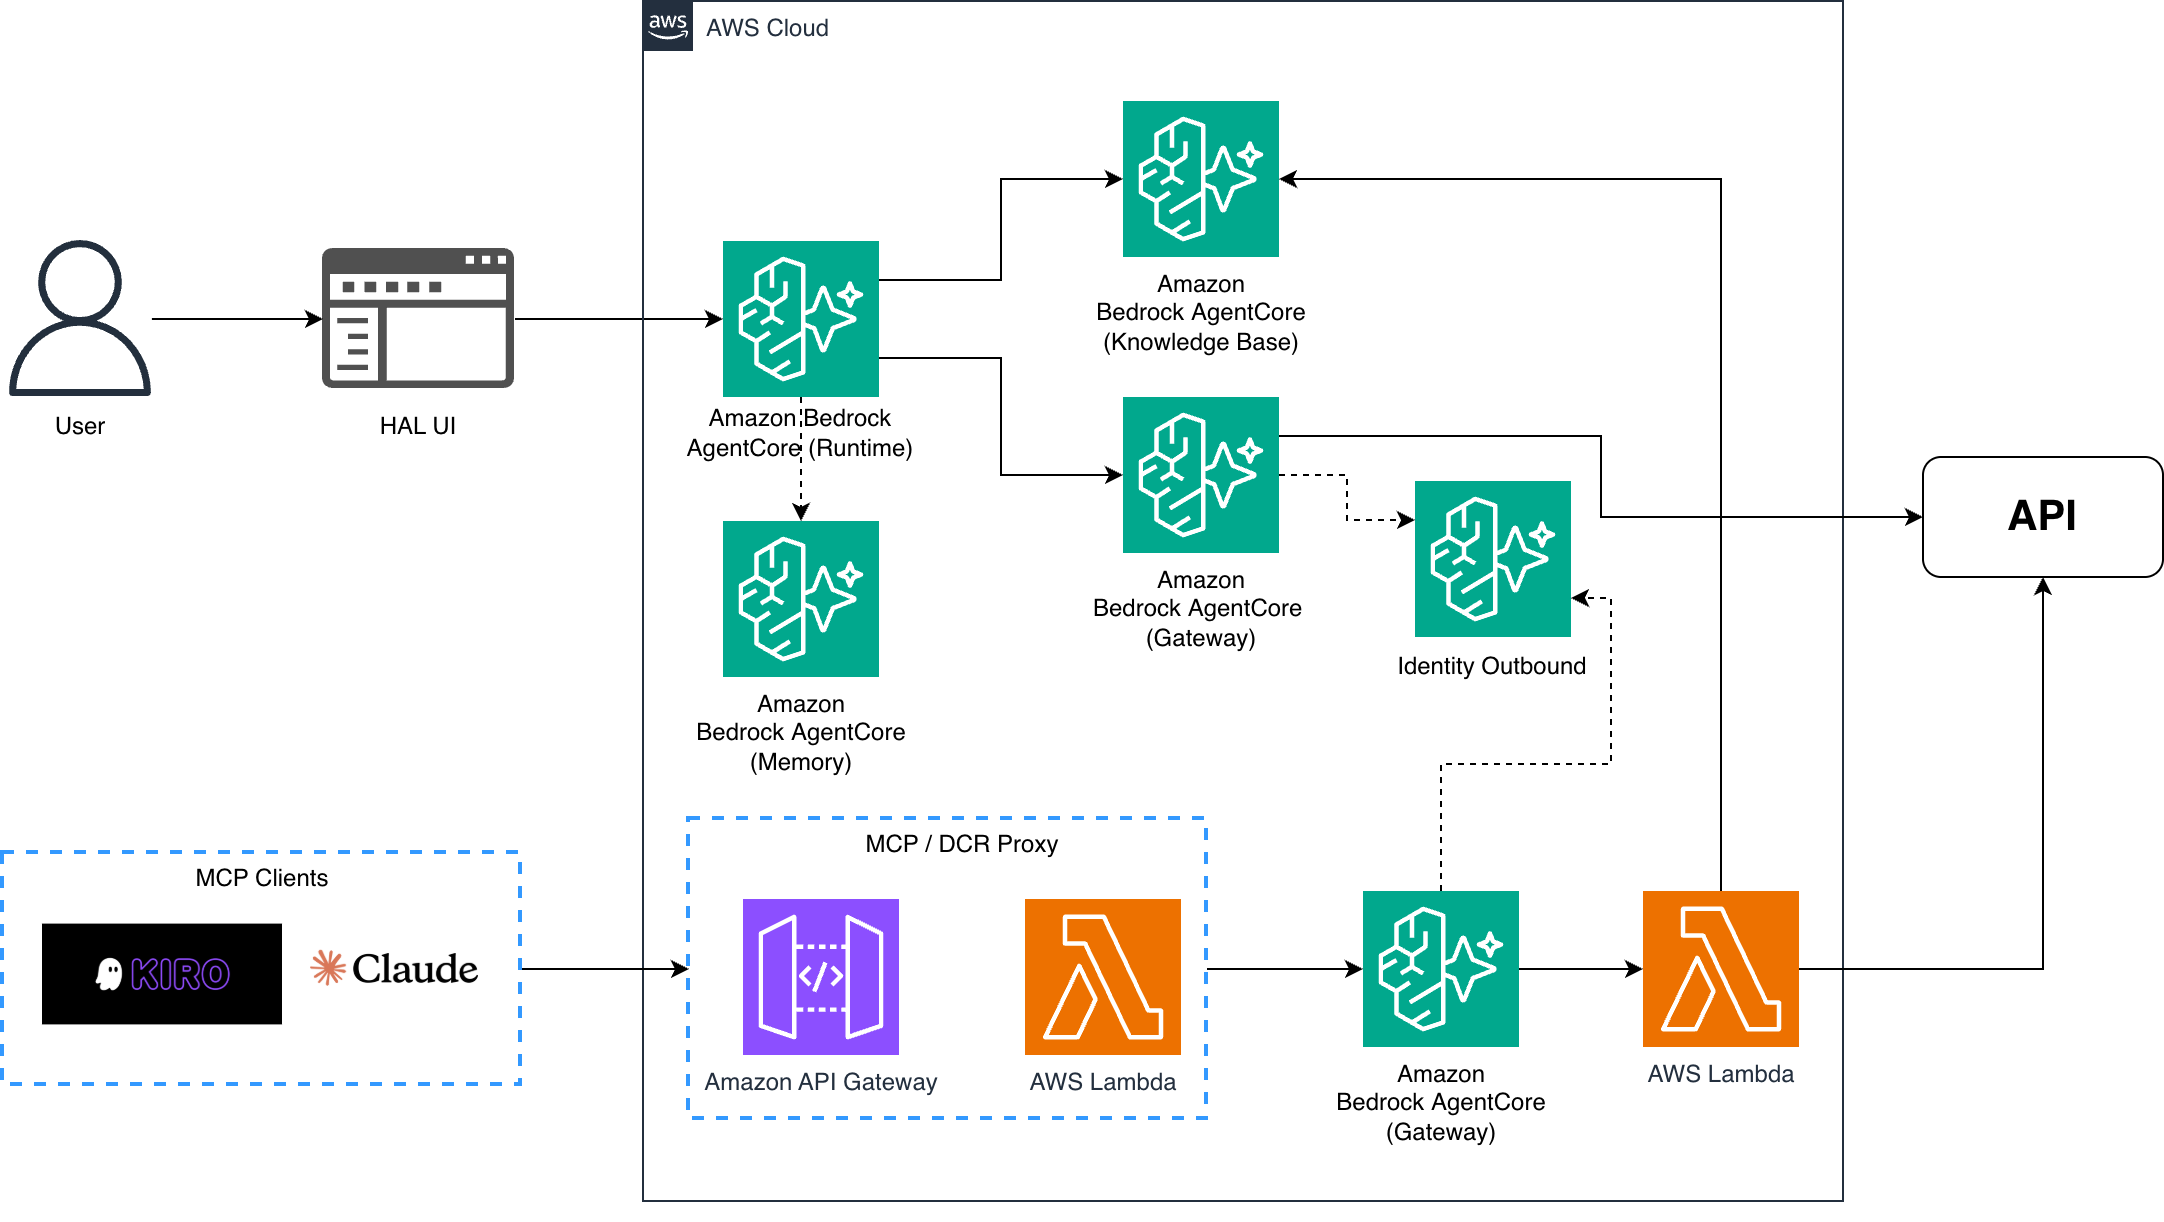
图 3:第 2 步,通过 MCP 将 HAL 开放给日常工具
AgentCore Gateway 从 OpenAPI 规范和 Lambda 函数中暴露工具。为了将知识库作为 Gateway 目标呈现,我们构建了一个小型中间 Lambda 函数,Gateway 将其作为工具调用,该函数代表 Gateway 对知识库执行语义搜索。相比之下,实时内部 API 则直接作为 OpenAPI 目标暴露。
难点:身份验证与动态客户端注册(DCR)
一个有趣的环节是外部客户端如何在没有 AWS 凭证的情况下进行身份验证。在 Entra Gateway 前面有一个 MCP 认证代理,这是一个由单个 Lambda 支持的 Amazon API Gateway v2 HTTP API,它协调 MCP OAuth 规范与 Entra ID 的具体要求。它提供 OAuth 发现文档,并将请求的作用域重写为资源应用的调用作用域。它还会剥离 Entra v2.0 拒绝的旧版 resource 参数,添加 response_mode=query 以便桌面客户端能够捕获授权码,并使用 bearer token 代理 /mcp。
有一个细节值得特别指出,因为这是整个系统中唯一出现 DCR 的地方。MCP 客户端期望 DCR,即一个返回客户端 ID 的 POST /register 调用。代理没有实现真正的动态注册,而是使用一个桩化的 /register,返回一个固定的、预配置的客户端 ID。DCR 是模拟的,不是真实的。
完整的握手过程如下:
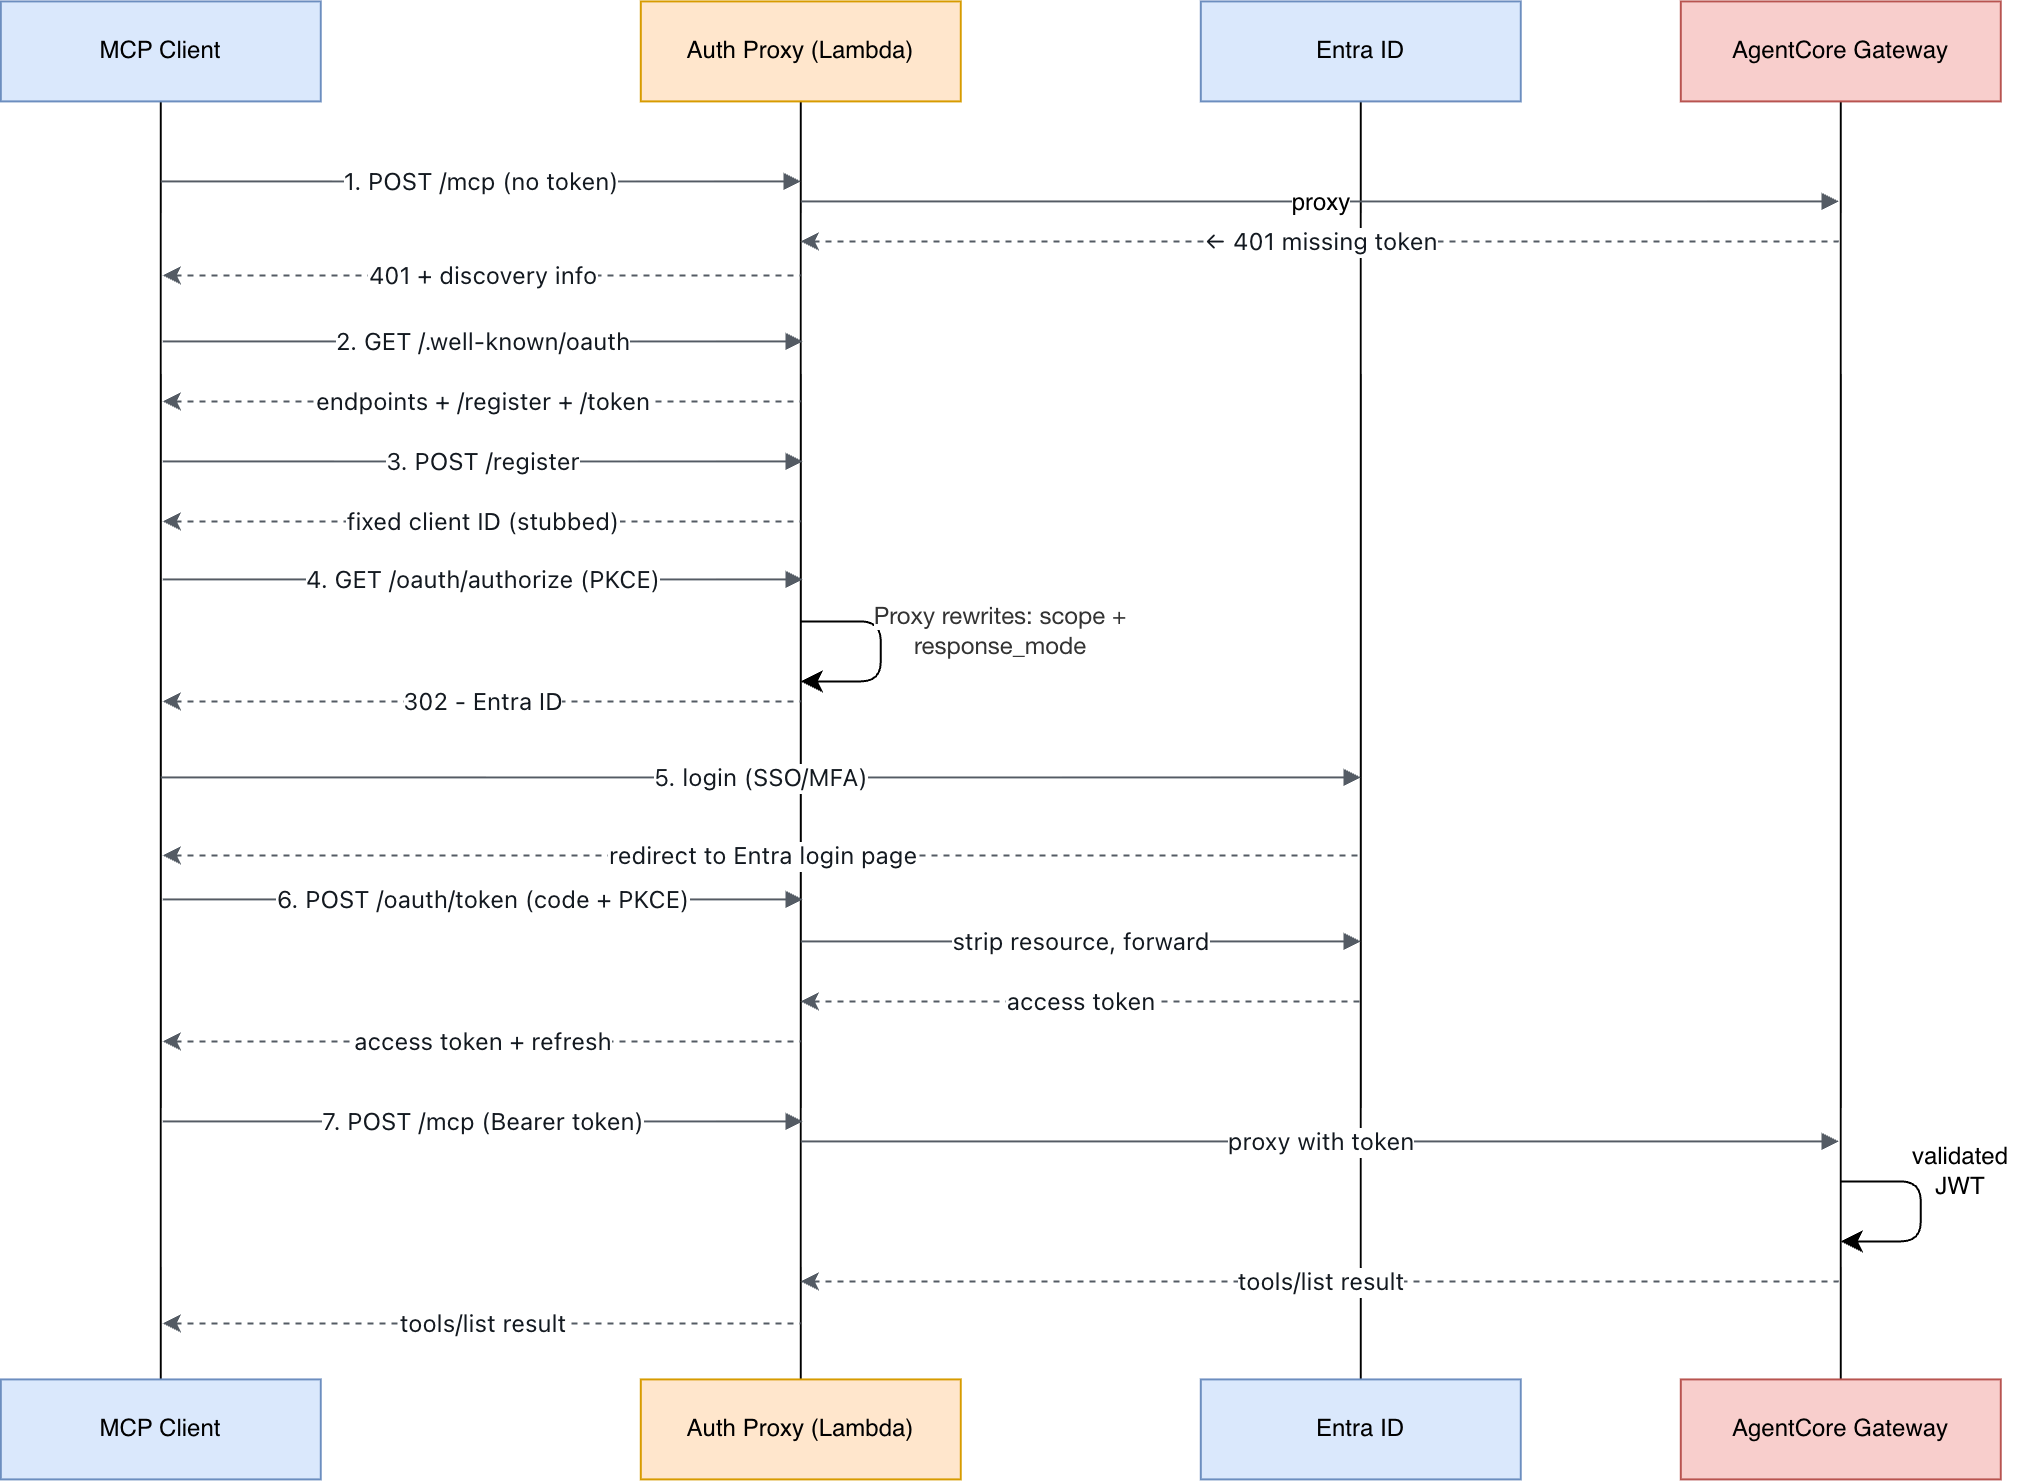
图 4:OAuth 和 DCR 身份验证序列
对最终用户而言,好处是配置仅需代理 URL 和一个空的 oauthScopes 列表,无需 AWS 凭证,首次连接时通过浏览器登录,之后自动刷新令牌。
在 Amazon Bedrock AgentCore 上部署
基础设施使用 AWS Cloud Development Kit(AWS CDK)定义,这是一个使用 npm workspaces 的 TypeScript monorepo。内部智能体作为 Docker 容器在 AgentCore 运行时上运行。特定于环境的配置,例如租户、客户端和资源标识符,通过 AWS Systems Manager(SSM)参数提供。
测试与推广
在上线之前,HEMA 将 HAL 部署到预发布环境,并向工程师和业务用户开放,进行了为期一个月的实操测试。这在解决方案被推广到生产环境以供组织更广泛采用之前,验证了答案质量、覆盖缺口和日常可用性。
如今谁在使用 HAL
HAL 最初是一个开发者工具,但它已经成为一个跨角色的助手,而这种广度正是其意义所在。
开发者在 Kiro 和聊天中使用完整的技术界面:文档、API 规范、Kafka 主题和模式、服务目录以及 DCL 渠道。
产品负责人依赖 HAL 获取文档、操作指南和流程知识:这些过去无处安放的流程层信息。
业务分析师使用 HAL 获取基础设施知识:存在哪些服务、它们暴露哪些 API,以及哪些团队拥有它们,直接利用服务目录。
来自非开发者角色的需求是真实且不断增长的:HEMA 的端到端团队正在梳理和优化产品经理流程,已经作为该工作的一部分与 HAL 进行互动。在内部,HAL 通过“Everyone Skill”及配套的引导文件进行分发,并通过每月一次的 HEMA AI 开发论坛进行共享和维护。
下一步:从回答到行动
目前,HAL 是只读的,提供即时回答。下一步是即时行动,由同一个助手执行。
这在现在之所以可行,正是因为底层门户已经支持 API,并且已经与现有的 Microsoft Entra ID 单点登录集成。这意味着 HAL 可以将这些操作作为 MCP 操作工具暴露出来,使用与保护读取工具完全相同的 Entra ID 身份验证和 Active Directory 组授权模型。不需要新的安全模型,只需要新的、经过仔细限定的工具。
最典型的例子是配置新的 AWS 账户。如今,开发者需要前往专用门户申请一个账户。接下来,他们将直接从聊天、Kiro、Claude 或其他智能体中发出同样的请求,而无需访问门户。而且,由于 HAL 已经服务于产品负责人和业务分析师,同样的操作模式自然可以从开发者运维扩展到这些角色每天进行的更广泛的运维请求。
教训是:读取架构为写入步骤奠定了基础——通过正确处理身份、多客户端访问和治理以提供答案,我们已经为操作铺平了道路。
结论
HAL 将 HEMA 的组织知识集中在一个受治理的地方。MCP 和 Amazon Bedrock AgentCore 使这些知识可访问、多客户端且安全,而无需强制每个消费应用程序从头重建身份验证、授权或路由。结果不是一个开发者聊天机器人,而是一个面向开发者、产品负责人和业务分析师的跨角色助手。知识层已经上线。合乎逻辑的下一步是将其扩展为操作层。在那里,今天回答问题的同一套受治理、经过身份验证的基础设施,明天可以执行请求:配置访问权限、触发工作流,并直接从聊天、Kiro、Claude 或其他兼容 MCP 的智能体中代表用户执行操作。
如果您想探索本文中使用的构建模块,以下资源是一个很好的起点。要了解 MCP 服务器托管、身份验证和网关路由,请参阅 Amazon Bedrock AgentCore 文档。有关 Model Context Protocol 规范和客户端兼容性指南,请访问 MCP 规范网站。要动手使用 Strands Agents——用于构建 HAL 内部智能体的开源智能体框架,请参阅 Strands Agents GitHub 仓库。如果您正在为您的组织构建类似的知识层,Amazon Bedrock 研讨会将在引导式环境中介绍 RAG 模式、知识库和护栏。
如需相关阅读,请参阅使用 Amazon Bedrock AgentCore 和 Mistral AI Studio 构建并连接生产就绪的电商 MCP 服务器以及介绍 Amazon Bedrock AgentCore Identity:大规模保护智能体 AI 安全。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文作者:Mauro Rallo;如有侵权,请联系管理员删除。

