通用唯一标识符(Universally Unique Identifiers,简称 UUID)的设计目标是让开发者能够在无需了解其他系统的情况下生成保证唯一性的 ID。这些标识符在分布式架构中尤为有用,因为在这种架构中,有多个系统和数据库负责创建记录。你可能认为在数据库中使用 UUID 作为主键是个好主意,但如果使用不当,它们可能会严重损害数据库性能。
在本文中,你将了解在 MySQL 数据库中使用 UUID 作为主键的缺点。
UUID 的众多版本
截至本文撰写时,UUID 有五个正式版本和三个提案版本。让我们逐一了解每个版本,以更好地理解它们的工作原理。
UUIDv1
UUID 版本 1 被称为基于时间的 UUID,可以按如下方式分解:
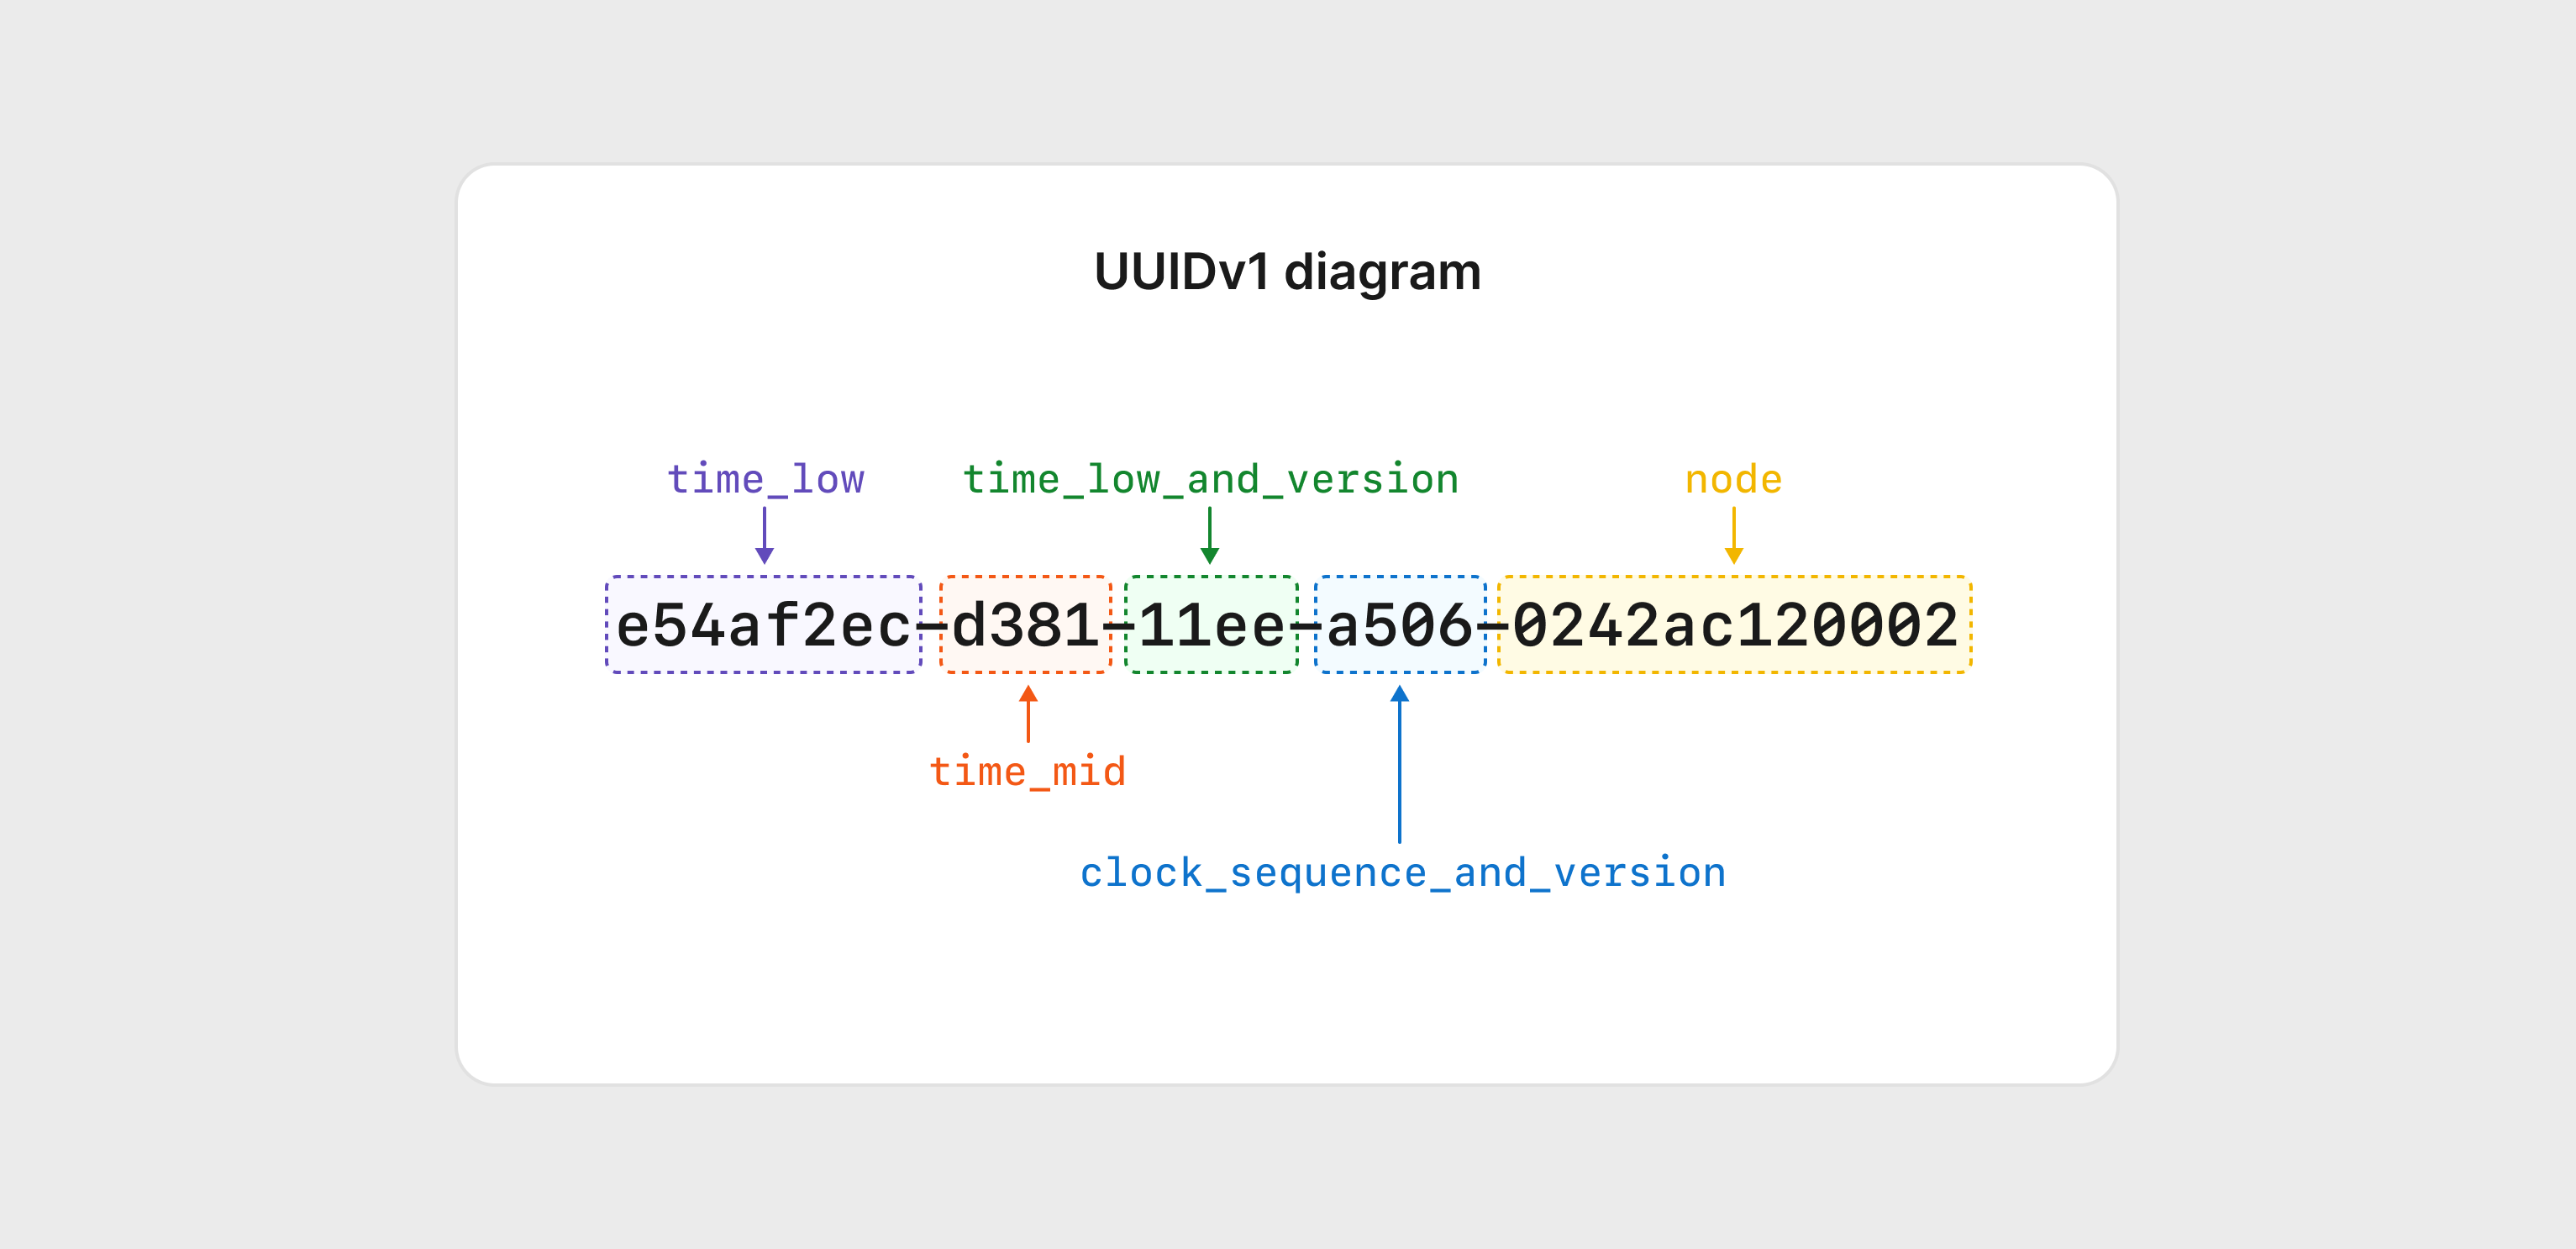
虽然现代计算大多使用 UNIX 纪元时间(1970年1月1日)作为基准,但 UUID 实际上使用的是 1568 年 10 月 10 日这个日期,即公历开始被更广泛使用的日期。UUID 中嵌入的时间戳从该日期起以 100 纳秒为增量增长,然后用于设置 UUID 的 time_low、time_mid 和 time_hi 段。
UUID 的第三段包含版本号以及 time_hi,并占据该段的第一个字符。对于所有版本的 UUID 都是如此,如后续示例所示。保留部分也称为 UUID 的变体(variant),它决定了 UUID 内部比特位的使用方式。最后,UUID 的最后一段是 node,即生成 UUID 的系统的唯一地址。
UUIDv2
UUID 版本 2 相比版本 1 做了一项改变,将结构中的 low_time 段替换为 POSIX 用户 ID。其理论是这些 UUID 可以追溯到生成它们的用户账户。由于 low_time 段是 UUID 大部分可变性所在之处,替换该段会增加碰撞的概率。因此,这个版本的 UUID 很少被使用。
UUIDv3 和 v5
UUID 的版本 3 和版本 5 非常相似。这些版本的目标是允许以确定性方式生成 UUID,以便在给定相同信息的情况下,可以生成相同的 UUID。这些实现使用两部分信息:一个命名空间(其本身就是一个 UUID)和一个名称。这些值通过哈希算法运行,生成一个 128 位的值,可以表示为 UUID。
这些版本之间的关键区别在于,版本 3 使用 MD5 哈希算法,而版本 5 使用 SHA1。
UUIDv4
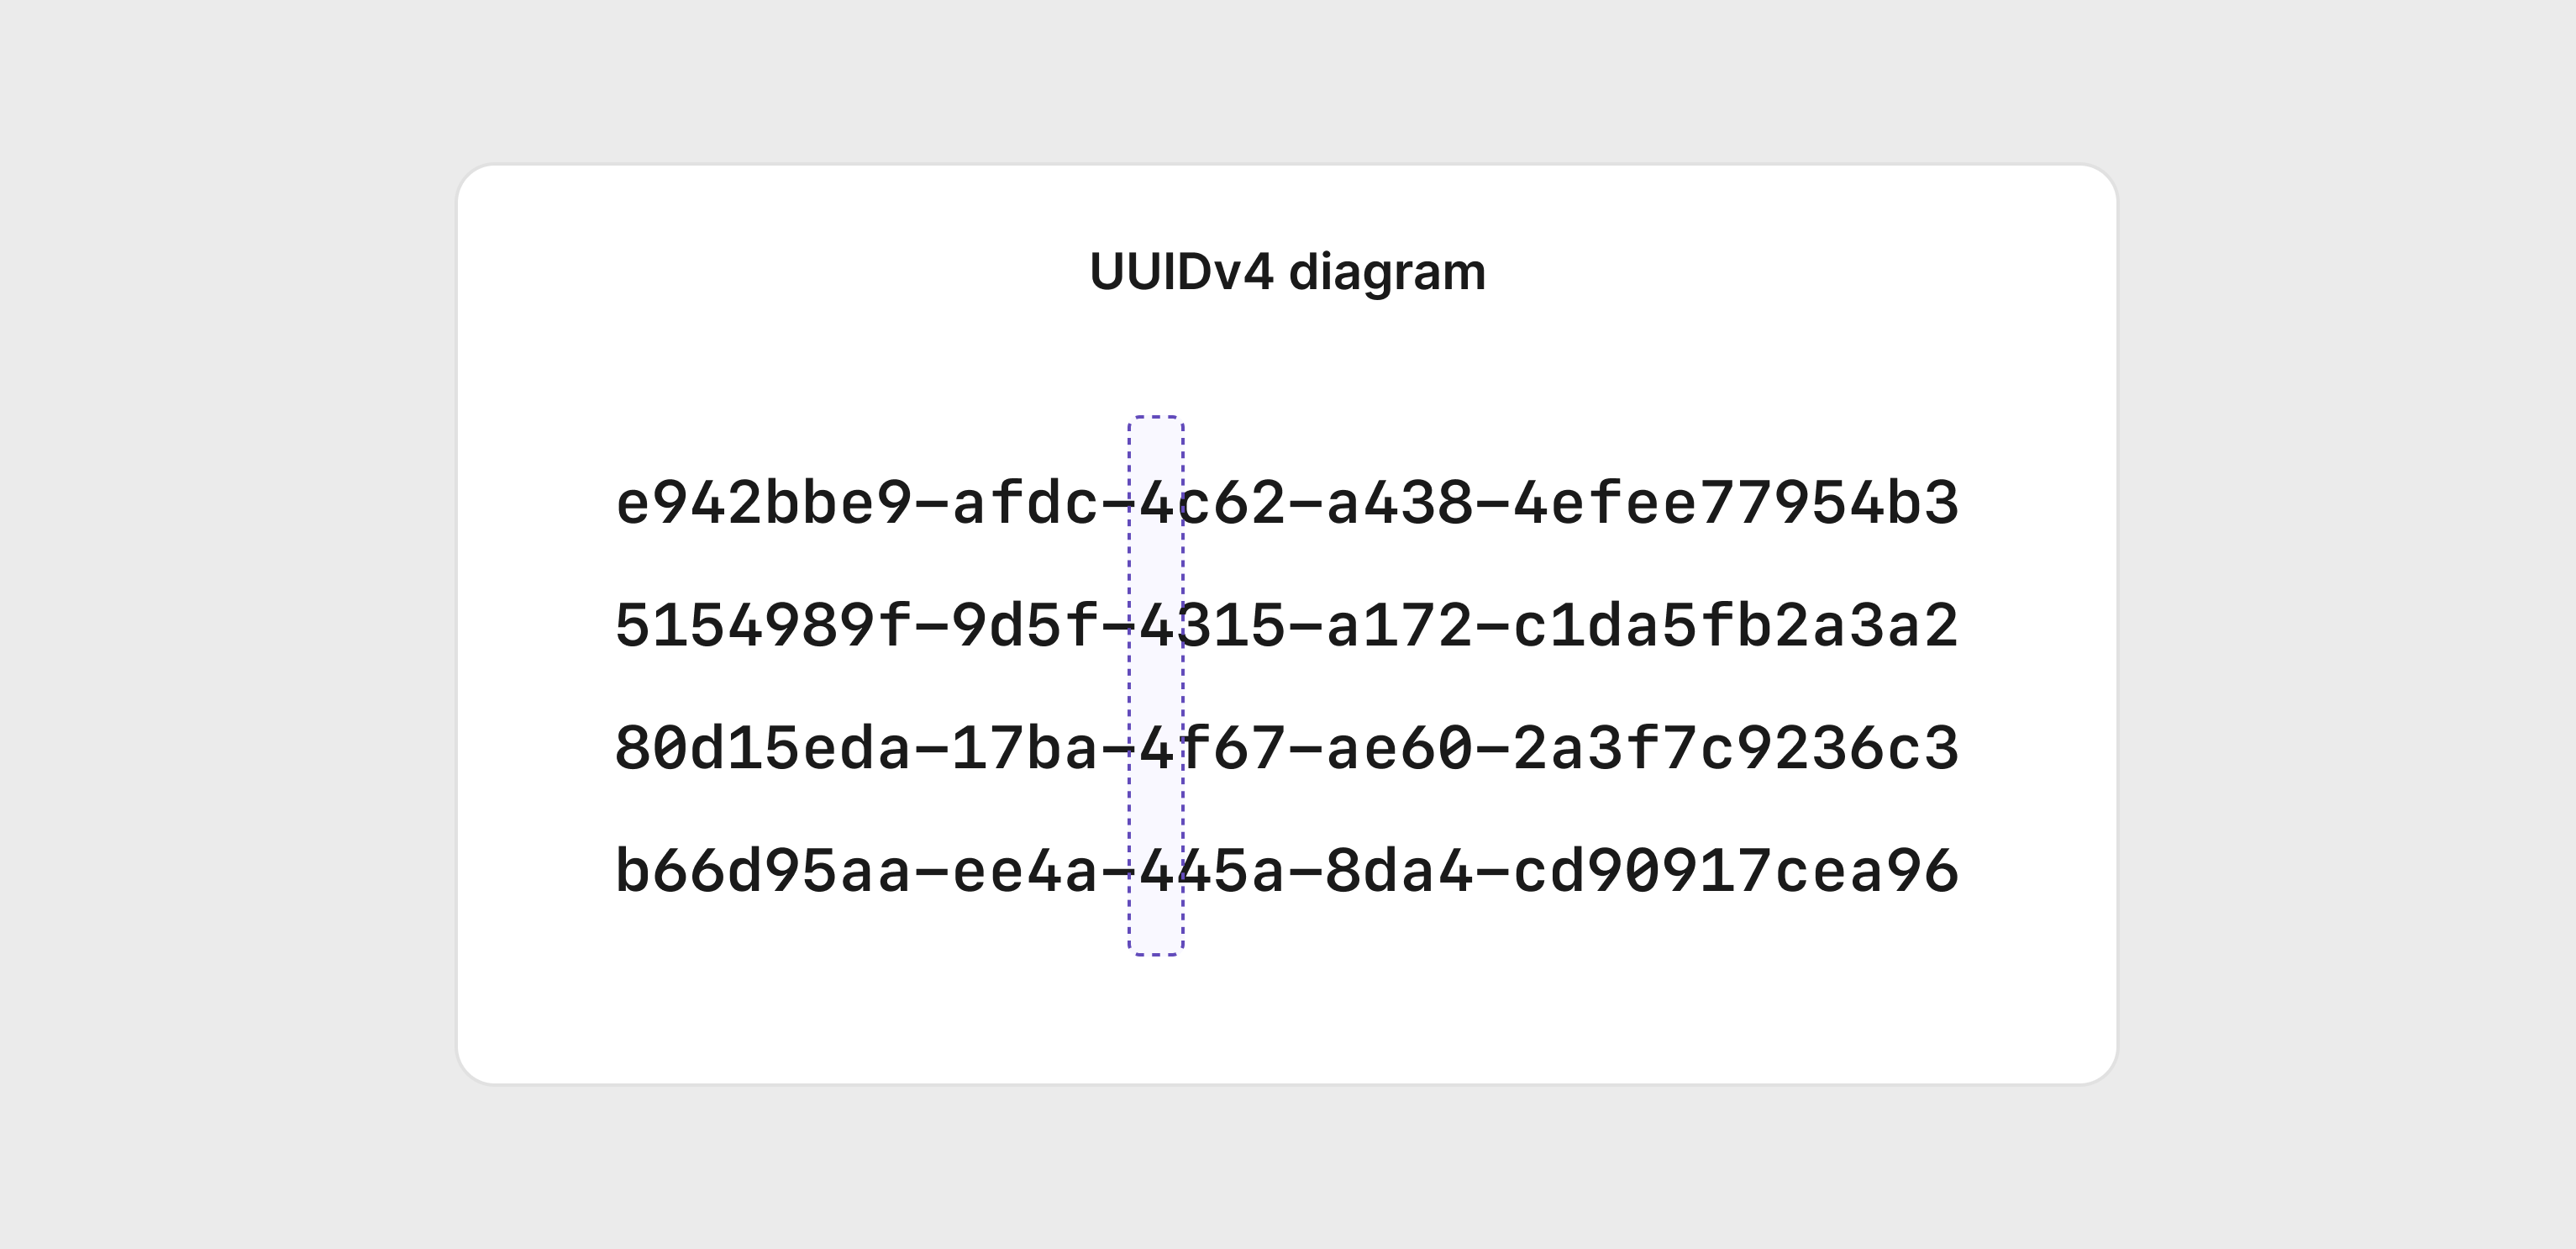
版本 4 被称为随机变体,因为顾名思义,UUID 的值几乎完全是随机的。例外情况是 UUID 第三段的第一位,该位始终为 4,以表示所使用的版本。
UUIDv6
版本 6 与版本 1 几乎相同。唯一的区别是用于捕获时间戳的位被翻转,这意味着时间戳的最高有效部分被存储在前面。下图展示了这些差异。
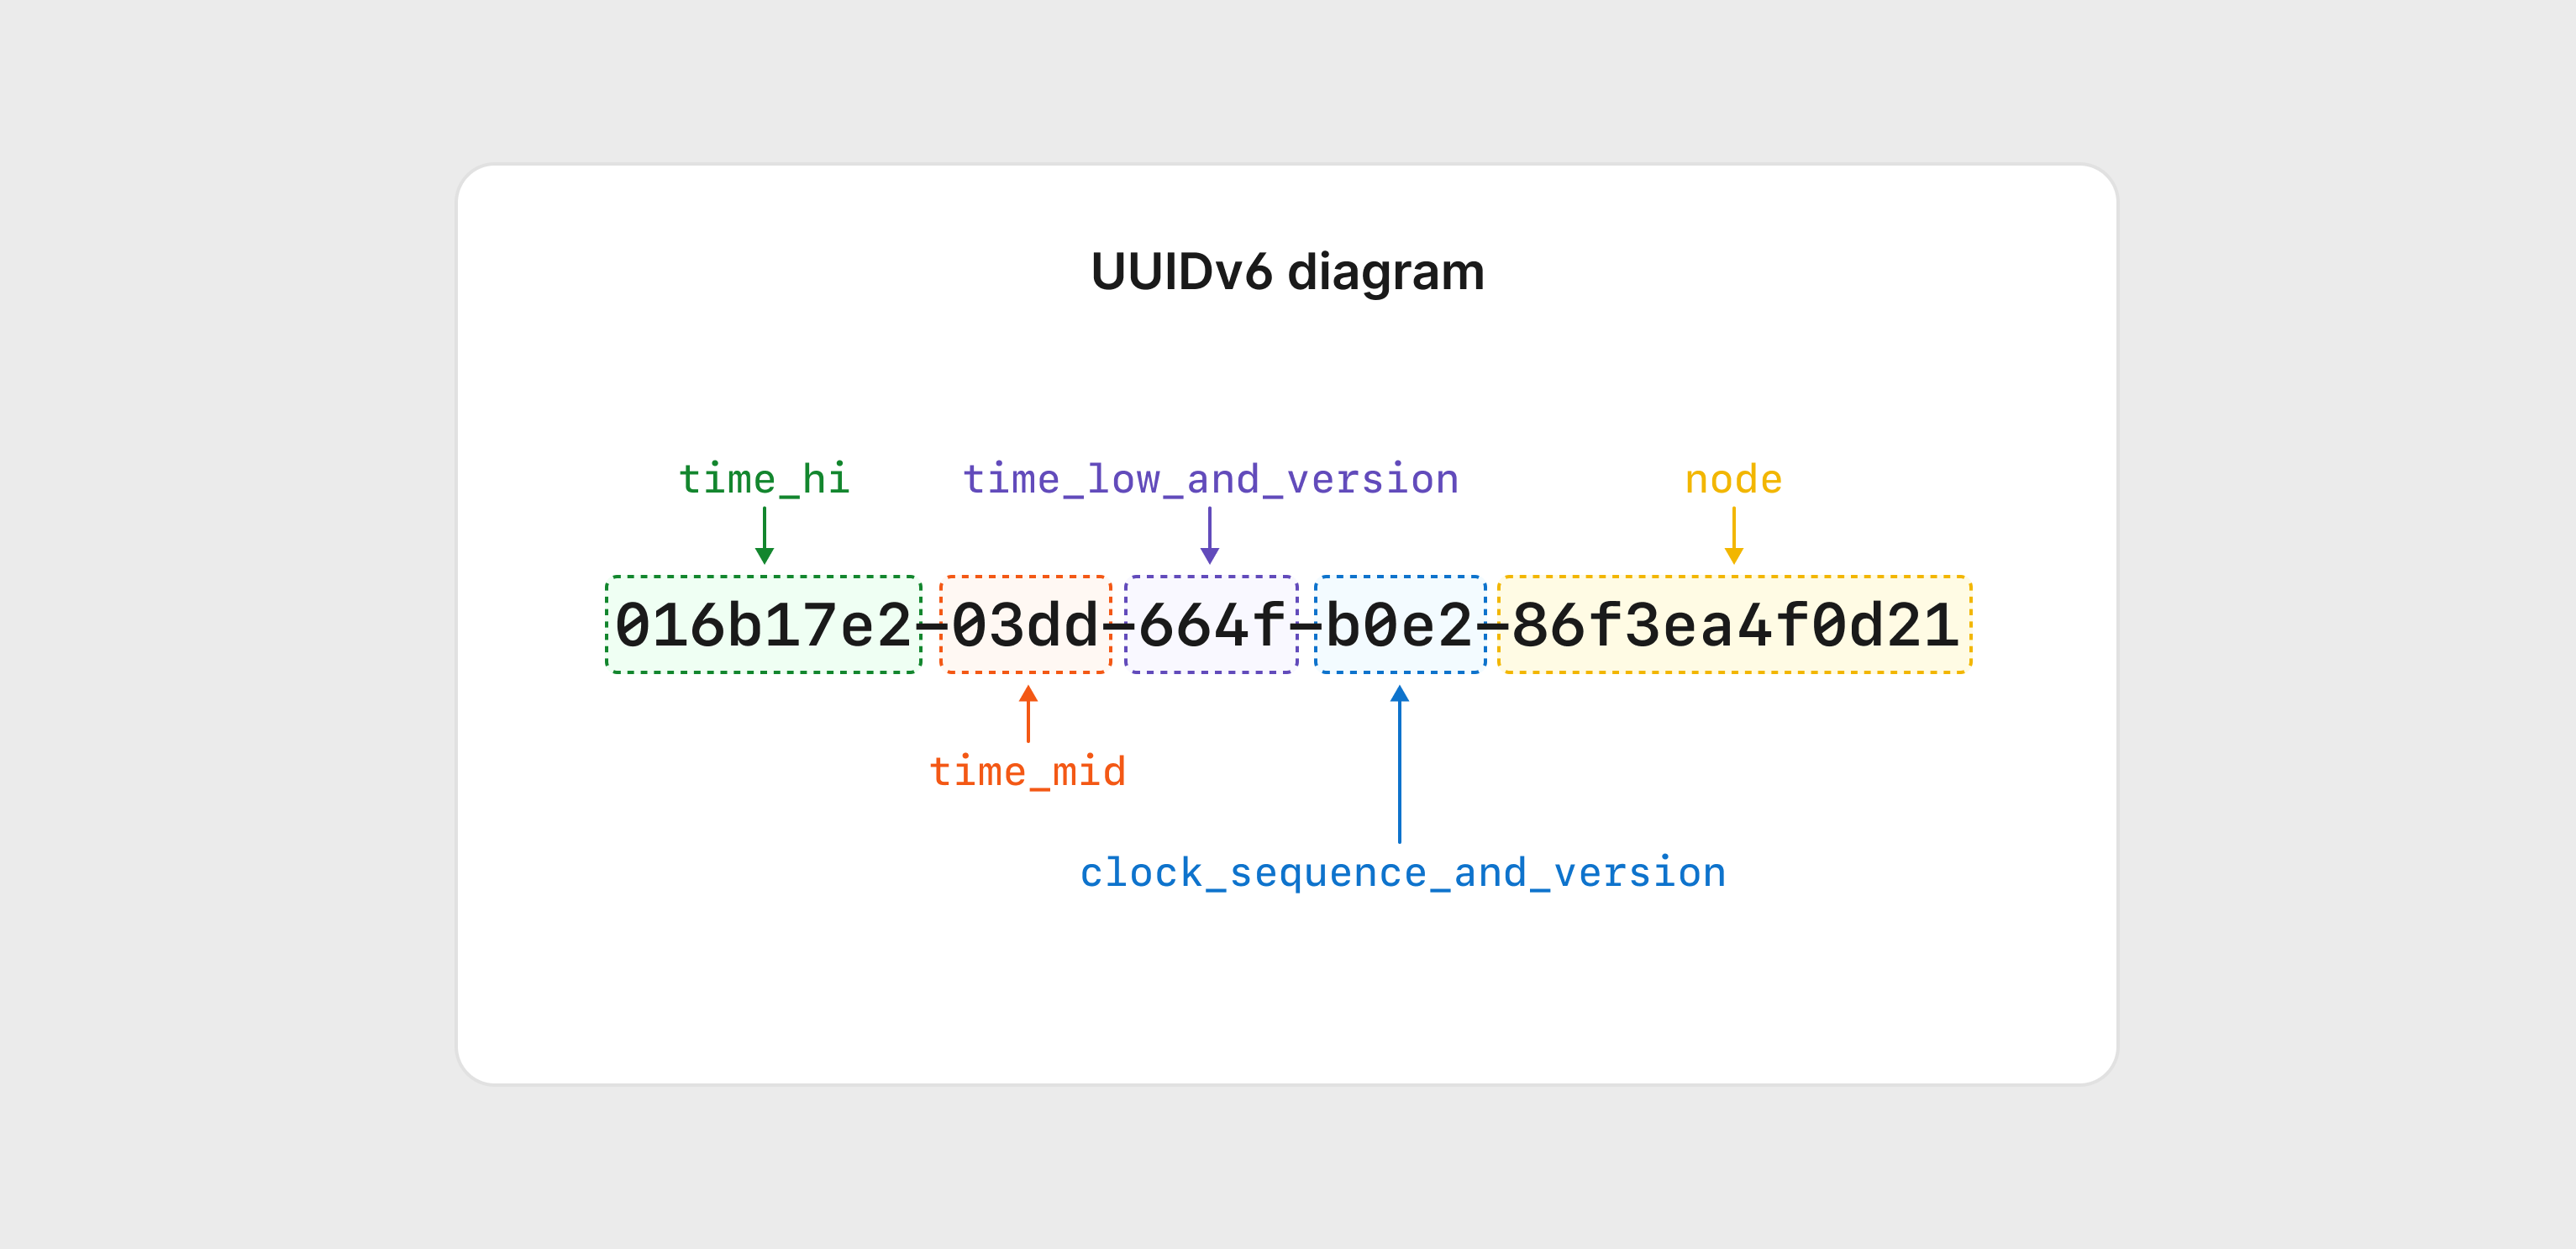
这样做的主要原因是创建一个与版本 1 兼容的值,同时允许这些值更具可排序性,因为时间戳的最高有效部分位于前面。
UUIDv7
版本 7 也是一种基于时间的 UUID 变体,但它集成了更常用的 Unix Epoch 时间戳,而不是版本 1 使用的公历日期。另一个关键区别是节点(基于生成 UUID 系统的值)被随机性取代,使得这些 UUID 更难以追踪回其来源。
UUIDv8
版本 8 是最新版本,允许供应商特定的实现,同时遵循 RFC 标准。UUIDv8 的唯一要求是版本号必须像所有其他版本一样,在第三段的第一位指定。
UUID 与 MySQL
使用 UUID(在大多数情况下)可以保证架构中所有系统的唯一性,因此你可能会倾向于将其用作记录的主键。但请注意,与自增整数相比,这样做存在若干权衡。
插入性能
每当向 MySQL 表中插入新记录时,与主键关联的索引都需要更新,以便对表的查询保持高性能。MySQL 中的索引采用 B+ 树的形式,这是一种多层数据结构,允许查询快速找到所需的数据。
下图展示了该结构的一个相对简单的版本,包含六个值从 1 到 6 的条目。如果有一个查询请求 5,MySQL 将从根节点开始,并由此知道它必须沿着树的右侧向下遍历才能找到所需的内容。
为简单起见,这些图展示的是 B 树而非 B+ 树。关键区别在于,在 B+ 树中,叶子节点包含对实际数据的引用,而在 B 树中,叶子节点则不包含。
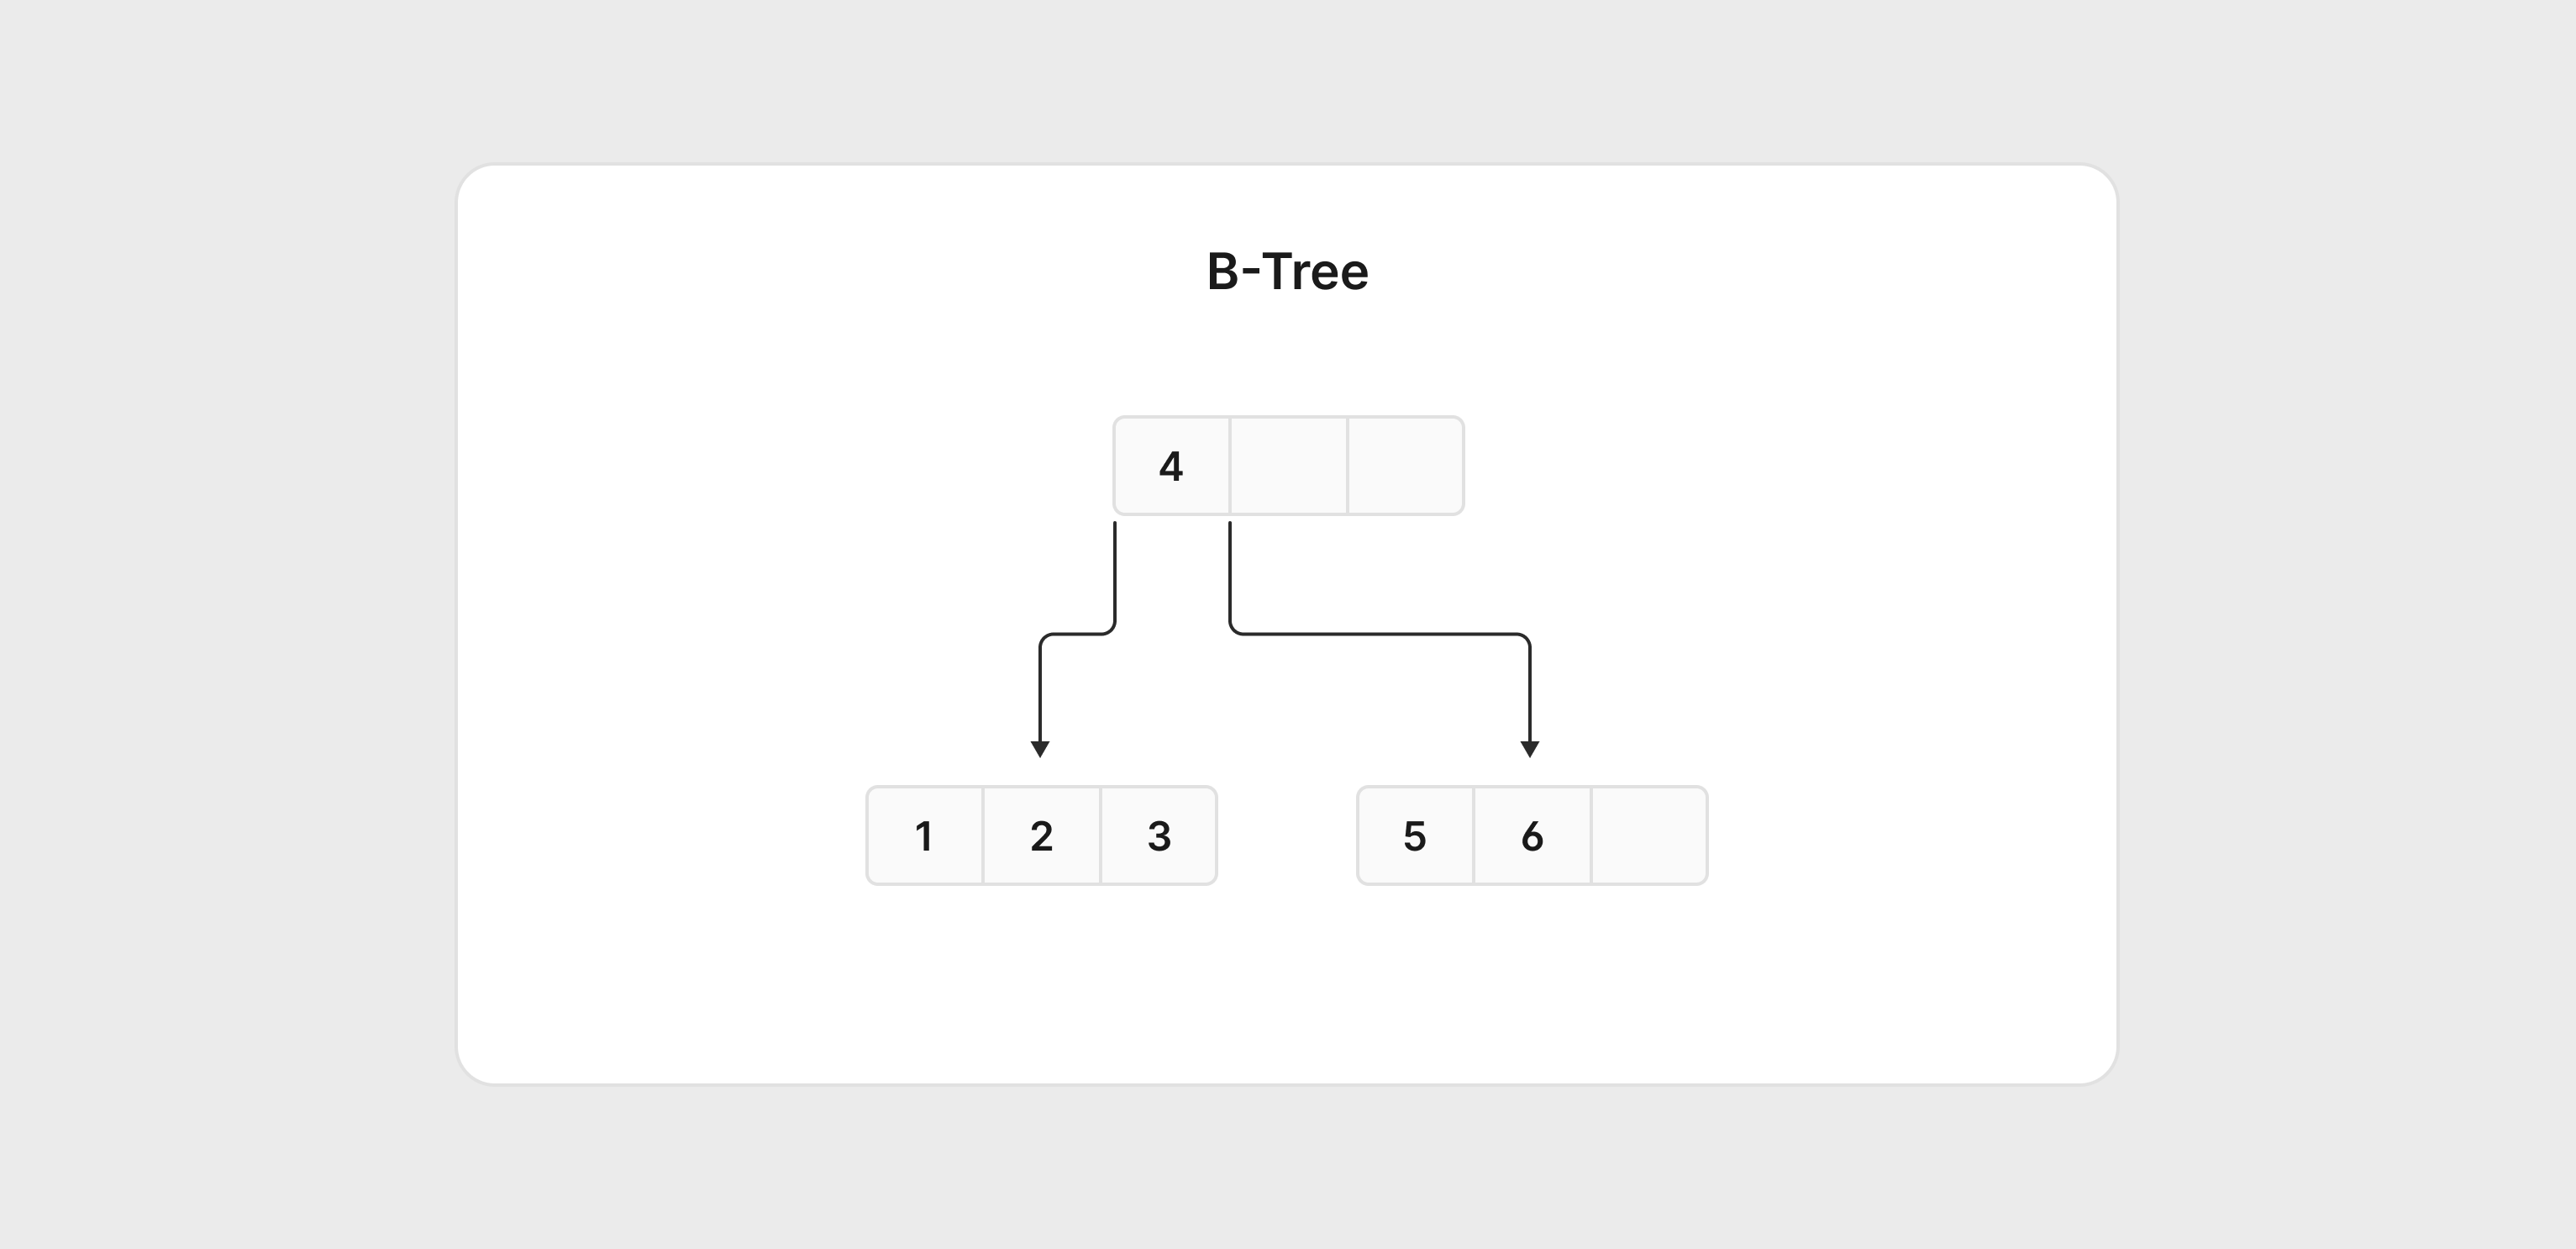
如果添加值 7-9,MySQL 将拆分右侧节点并重新平衡树。
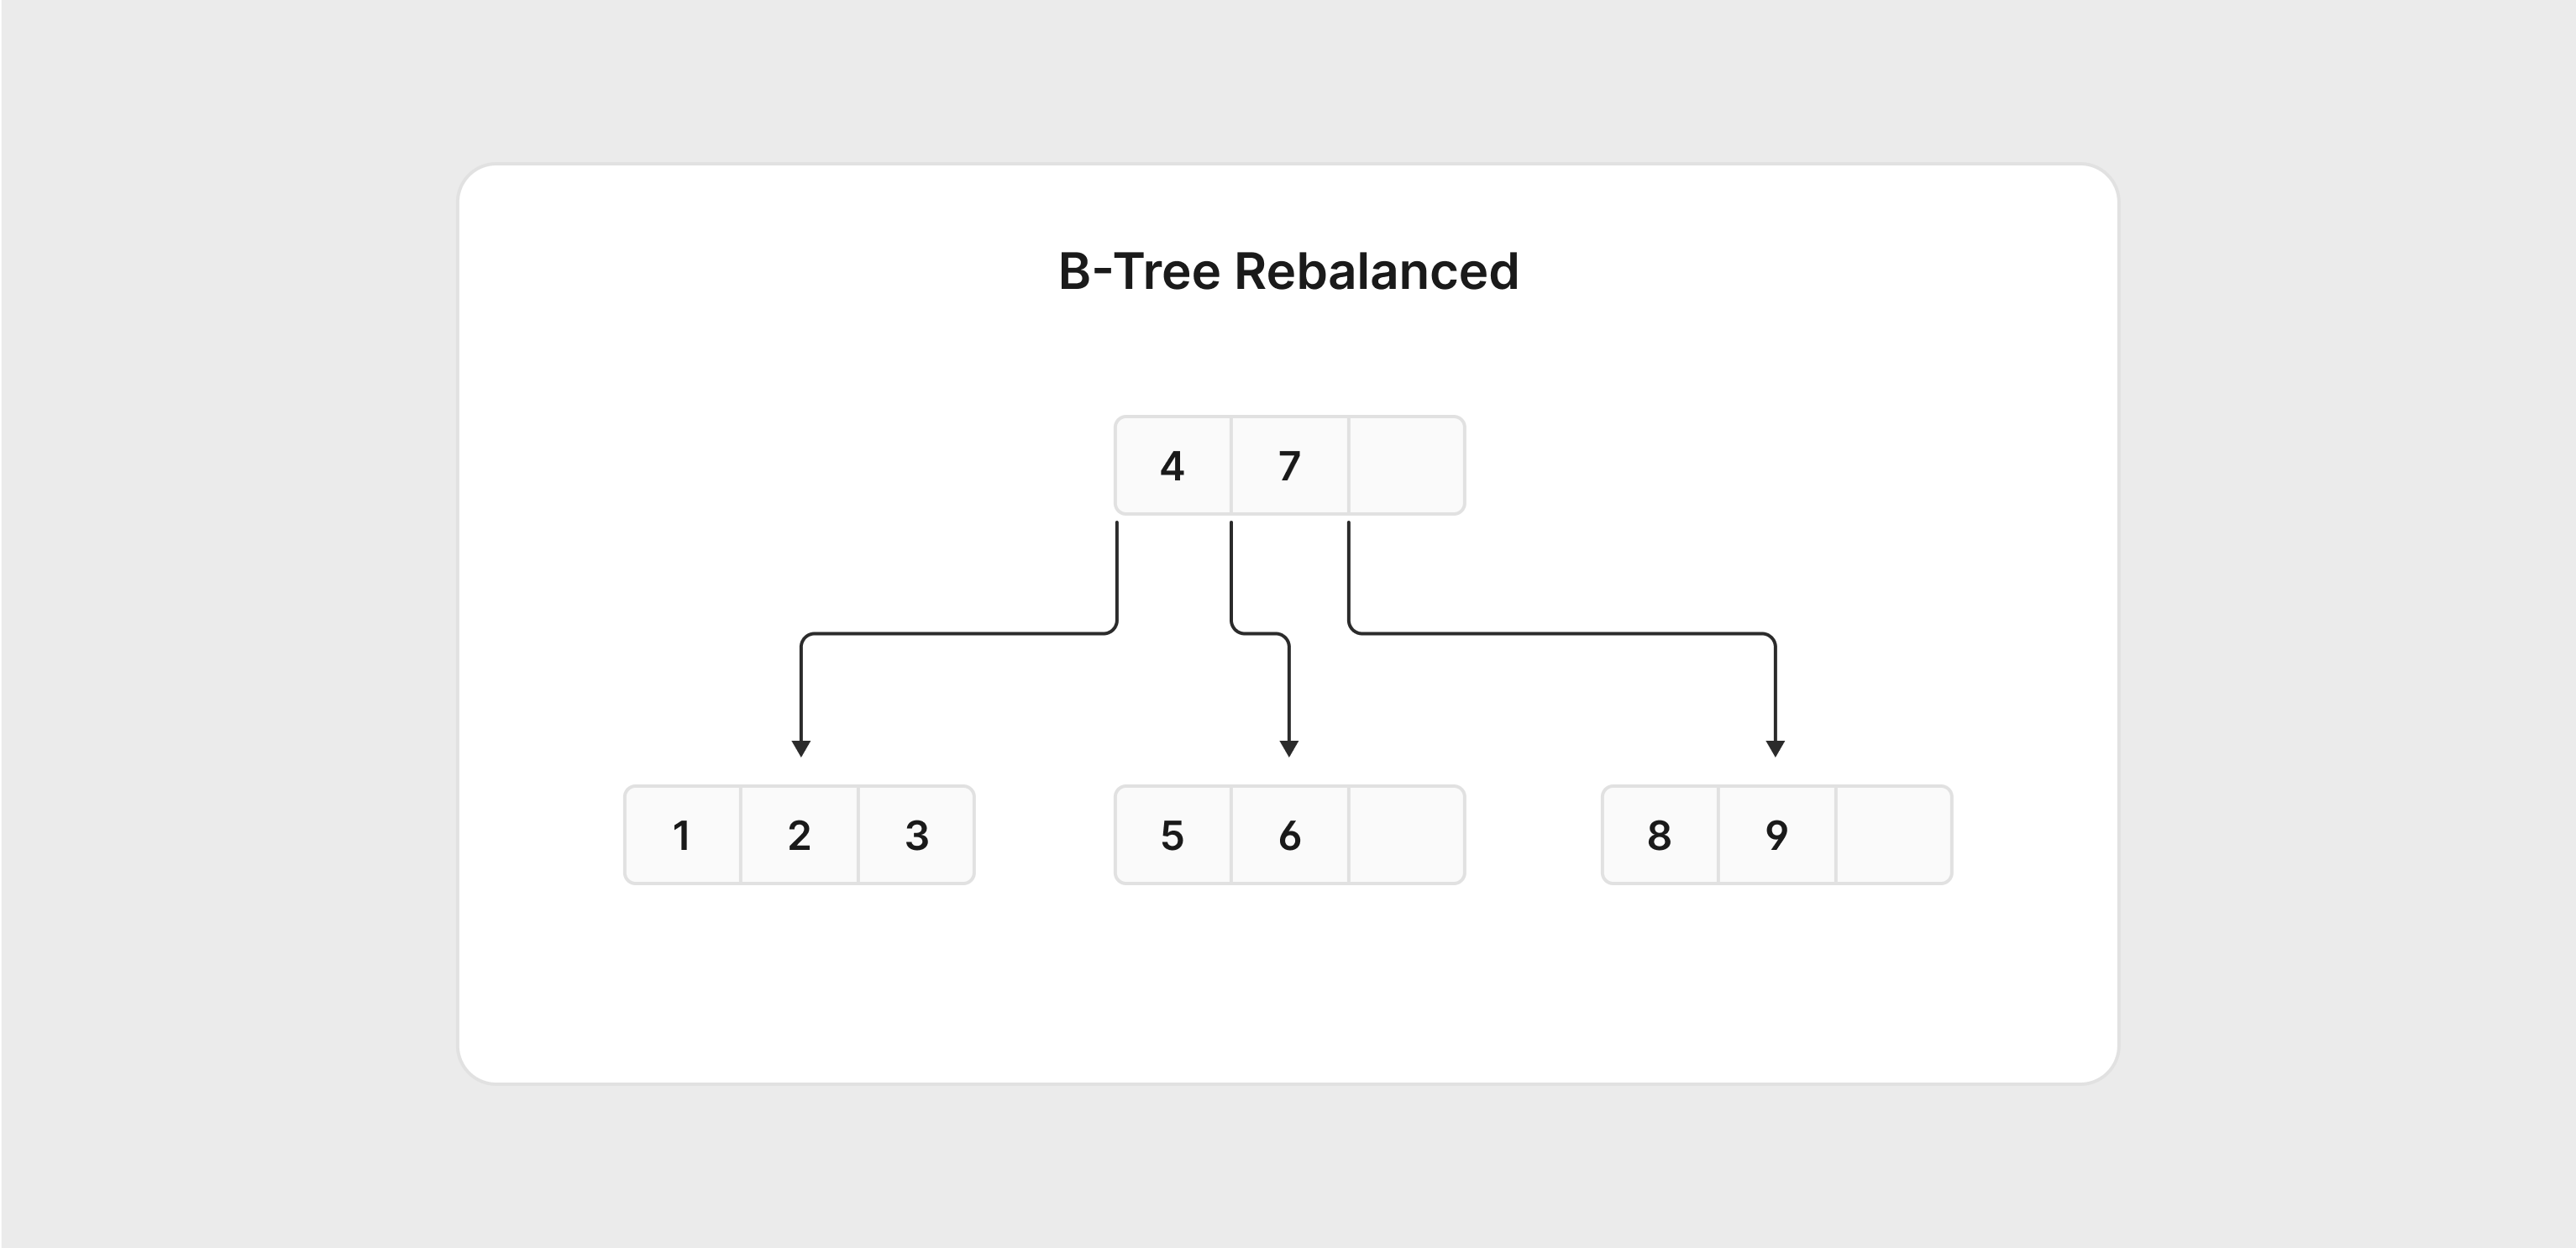
这个过程称为页分裂,其目标是保持 B+ 树结构平衡,以便 MySQL 能够快速找到所需的数据。对于顺序值,这个过程相对简单;然而,当算法中引入随机性时,MySQL 重新平衡树所需的时间会显著增加。在高负载数据库上,当 MySQL 试图保持树平衡时,这可能会损害用户体验。
有关 B+ 树工作原理的更多信息,我们在 MySQL for Developers 课程中有一个专门的视频。
更高的存储利用率
MySQL 中的所有主键都会被索引。默认情况下,自增整数每个值消耗 32 位存储空间。将其与 UUID 进行比较。如果以紧凑的二进制形式存储,单个 UUID 在磁盘上将消耗 128 位。这已经是 32 位整数消耗量的 4 倍。如果你选择使用更易读的基于字符串的表示形式,每个 UUID 可以存储为 CHAR(36),每个 UUID 消耗高达 288 位。这意味着每条记录存储的数据量将是 32 位整数的 9 倍。
除了在主键上创建的默认索引外,二级索引也会消耗更多空间。这是因为二级索引使用主键作为指向实际行的指针,这意味着它们需要与索引一起存储。根据使用 UUID 作为主键的表上创建的索引数量,这可能导致数据库存储需求显著增加。
最后,页分裂(如前一节所述)也会对存储利用率和性能产生负面影响。InnoDB 假设主键会以可预测的方式递增,无论是数值上还是字典序上。如果确实如此,InnoDB 会在创建新页之前将页面填充到大约页面大小的 94%。当主键是随机的时候,每个页面利用的空间可能低至 50%。因此,使用包含随机性的 UUID 可能导致过度使用页面来存储索引。
在 MySQL 中使用 UUID 主键的最佳方式
如果你绝对需要使用 UUID 作为表中记录的唯一标识符,可以遵循一些最佳实践来尽量减少这样做带来的负面影响。
使用二进制数据类型
虽然 UUID 通常以 36 个字符的字符串形式出现,但它们也可以以其原生二进制格式表示。如果转换为二进制值,你可以将其存储在 BINARY(16) 列中,这将每个值的存储需求减少到 16 字节。这仍然比 32 位整数大不少,但肯定比将 UUID 存储为 CHAR(36) 要好。
create
table
uuids
(
UUIDAsChar
char
(
36
)
not null
,
UUIDAsBinary
binary
(
16
)
not null
);
insert into
uuids
set
UUIDAsChar
=
'd211ca18-d389-11ee-a506-0242ac120002'
,
UUIDAsBinary
=
UUID_TO_BIN(
'd211ca18-d389-11ee-a506-0242ac120002'
);
select
*
from
uuids;
-- +--------------------------------------+------------------------------------+
-- | UUIDAsChar                           | UUIDAsBinary                       |
-- +--------------------------------------+------------------------------------+
-- | d211ca18-d389-11ee-a506-0242ac120002 | 0xD211CA18D38911EEA5060242AC120002 |
-- +--------------------------------------+------------------------------------+
使用有序 UUID 变体
使用支持排序的 UUID 版本可以通过使生成的值更具顺序性来缓解使用 UUID 带来的一些性能和存储影响,从而避免前面描述的一些页分裂问题。即使在多个系统上生成,基于时间的 UUID(如版本 6 或 7)也可以保证唯一性,同时使值尽可能接近顺序。例外是 UUIDv1,它将时间戳的最低有效部分放在最前面。
使用 MySQL 内置的 UUID 函数
MySQL 支持直接在 SQL 中生成 UUID;然而,它只支持 UUIDv1 值。虽然单独使用它们并不是一个好做法,但 MySQL 中有一个名为 uuid_to_bin 的辅助函数。这个函数不仅将字符串值转换为二进制,还可以使用 'swap flag' 选项,该选项会重新排序时间戳部分,使生成的二进制值更具顺序性。
set
@uuidvar
=
'd211ca18-d389-11ee-a506-0242ac120002'
;
-- Without swap flag
SELECT
HEX(UUID_TO_BIN(@uuidvar))
as
UUIDAsHex;
-- +----------------------------------+
-- | UUIDAsHex                        |
-- +----------------------------------+
-- | D211CA18D38911EEA5060242AC120002 |
-- +----------------------------------+
-- With swap flag
SELECT
HEX(UUID_TO_BIN(@uuidvar,
1
))
as
UUIDAsHex;
-- +----------------------------------+
-- | UUIDAsHex                        |
-- +----------------------------------+
-- | 11EED389D211CA18A5060242AC120002 |
-- +----------------------------------+
使用替代 ID 类型
UUID 并不是在分布式架构中提供唯一性的唯一标识符类型。考虑到它们最初创建于 1987 年,其他专业人士有充足的时间提出不同的格式,如 Snowflake ID、ULID,甚至 NanoID(我们在 PlanetScale 使用的)。
# Snowflake ID
7167350074945572864
# ULID
01HQF2QXSW5EFKRC2YYCEXZK0N
# NanoID
kw2c0khavhql
结论
在 MySQL 中使用 UUID 主键可以(几乎)保证分布式系统中的唯一性;然而,它也带来了若干权衡。幸运的是,由于存在多种可用版本以及若干替代方案,你可以选择能更好地解决其中一些权衡的方案。阅读本文后,你应当能更好地为下一个数据库架构中的 ID 类型选择做出明智决策。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:PlanetScale Blog
原创地址:https://planetscale.com/blog/the-problem-with-using-a-uuid-primary-key-in-mysql
原文作者:PlanetScale Blog;如有侵权,请联系管理员删除。

