在为数据库规划资源时,我们通常关注 vCPU、RAM 和存储容量等规格。然而,对于数据库这类 I/O 密集型工作负载来说,IOPS 和吞吐量是至关重要的考量因素。
在本文中,我们将探讨数据库的 IOPS 和吞吐量需求如何影响成本,以及分片如何帮助降低大规模工作负载的成本。
在深入这些细节之前,让我们先定义一下 IOPS 和吞吐量的含义。
自本文撰写以来,我们已发布了 PlanetScale Metal。Metal 数据库为您提供无限的 IOPS 以及超低延迟的读写能力。如果您需要具有出色 IO 性能的数据库,请了解 Metal。
什么是 IOPS?
IOPS 是 Input/Output Operations Per Second(每秒输入/输出操作次数)的缩写。换句话说,就是系统每秒对底层存储卷执行读或写操作的次数。
但什么算作一次操作呢?这取决于所使用的云服务商和存储系统。
AWS EBS IOPS
在 AWS 中,EC2 实例和 RDS 数据库通常挂载 EBS(Elastic Block Storage,弹性块存储)卷。即使在 EBS 内部,单次 IOP 的定义也因存储类别而异,其中有多种选项(gp2、gp3、io1、io2、st1、sc1)。如果我们选择使用 gp3,单次操作被衡量为一次 64 KiB 的磁盘读取或写入。如果您有一个配置了默认 3000 IOPS 的 gp3 卷,这意味着它最多可以处理 64 * 3000 = 192000 = 192 MiB/s 的 I/O。
关于 EBS IOPS,还有几点需要考虑:
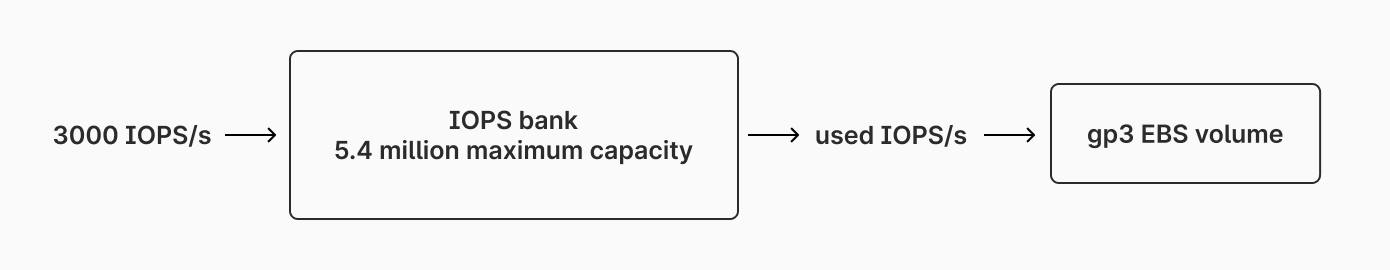
EBS 卷还允许你存储未使用的 IOPS,上限为固定值。这些存储的 IOPS 可以在未来兑换使用,使卷能够在某段时间内突发超过设定的 IOPS 限制。一旦存储额度耗尽,在积累更多 IOPS 之前将无法再突发。
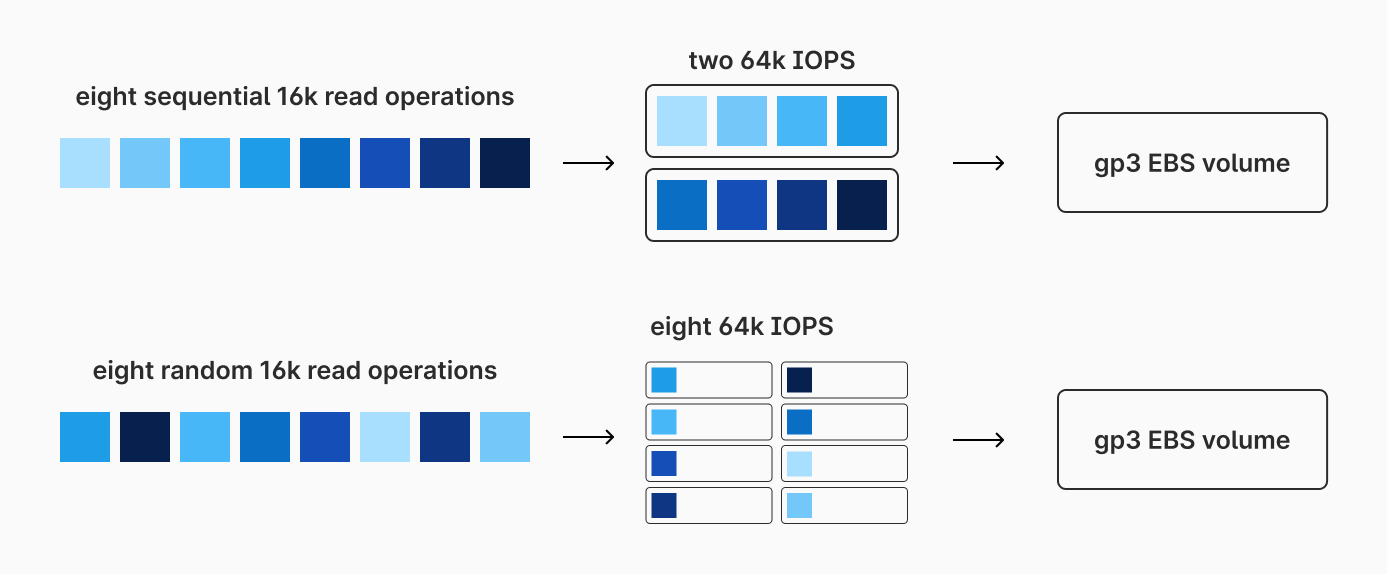
计算每秒可向磁盘读写的数据总量并不只是简单地计算 number_of_iops * 64 KiB。这是因为 EBS 处理顺序读取和随机读取的方式不同。对于顺序读取,EBS 会将请求打包在一起,从而最大化 IOPS。对于随机读取,每次读取都计为一个完整的 IOP,即使读取量小于 64k。例如,从磁盘随机读取一个 4k 块将计为一个完整的 64k IOP。有些人认为一旦迁移到 SSD,顺序读取与随机读取模式就不再重要。然而,这适用于 EBS 上的 HDD 和 SSD 工作负载。
随机读取越多,IOPS 的利用效率就越低。顺序读取越多,效率就越高。
吞吐量与 IOPS
吞吐量是指在定义的时间跨度内可以通过系统的数据或请求总量。尽管吞吐量与 IOPS 相关,但卷的 IOPS 并不直接等同于该卷在任何给定时间的吞吐量交付能力。
每个 EBS 卷都会被分配一定量的 IOPS。gp3 卷默认每个卷提供 3000 IOPS。可以按每 IOP 每月的额外费用购买更多 IOPS,上限为 16,000。每个 gp3 卷还默认提供 125 MiB/s 的吞吐量限制(同样可以付费提升至最高 1000 MiB/s)。根据之前的计算,如果我们以完全顺序的 IO 模式利用 3000 IOPS,理论上可以达到 192 MiB/s。然而,由于默认吞吐量限制为 125 MiB/s,除非我们购买更多吞吐量,否则实际上无法达到这一数值。
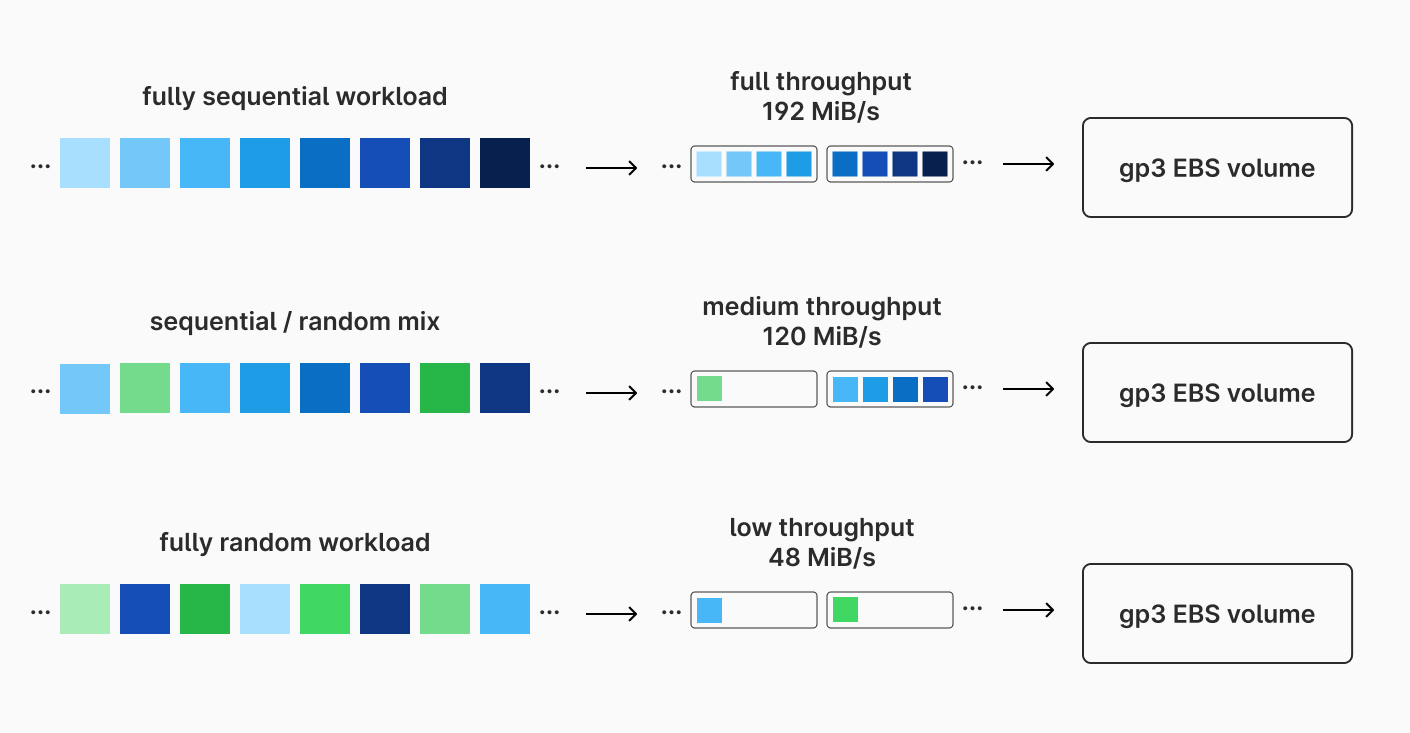
在实践中,数据库工作负载通常混合了顺序和随机磁盘 IO 操作。我们很少能以最大 IOPS 效率运行,因此在许多情况下,3000 IOPS 与 125 MiB/s 的搭配是可以接受的。
数据库工作负载
数据库是我们在云中运行的最 I/O 密集型工作负载之一。对于大型数据库,我们可能需要为额外的吞吐量和 IOPS 付费以获得所需的性能。有以下几种选择:
使用通用型 EBS 类型(如 gp3),然后为额外的 IOPS 和吞吐量付费。
升级到 AWS 的预置 IOPS SSD 卷类型,如 io1 或 io2。这些卷价格显著更高,但也具有更高的最大 IOPS 和吞吐量。gp3 的最大值为 16000 IOPS 和 1000 MiB/s,而 io2 的最大值为 256,000 IOPS 和 4000 MiB/s。
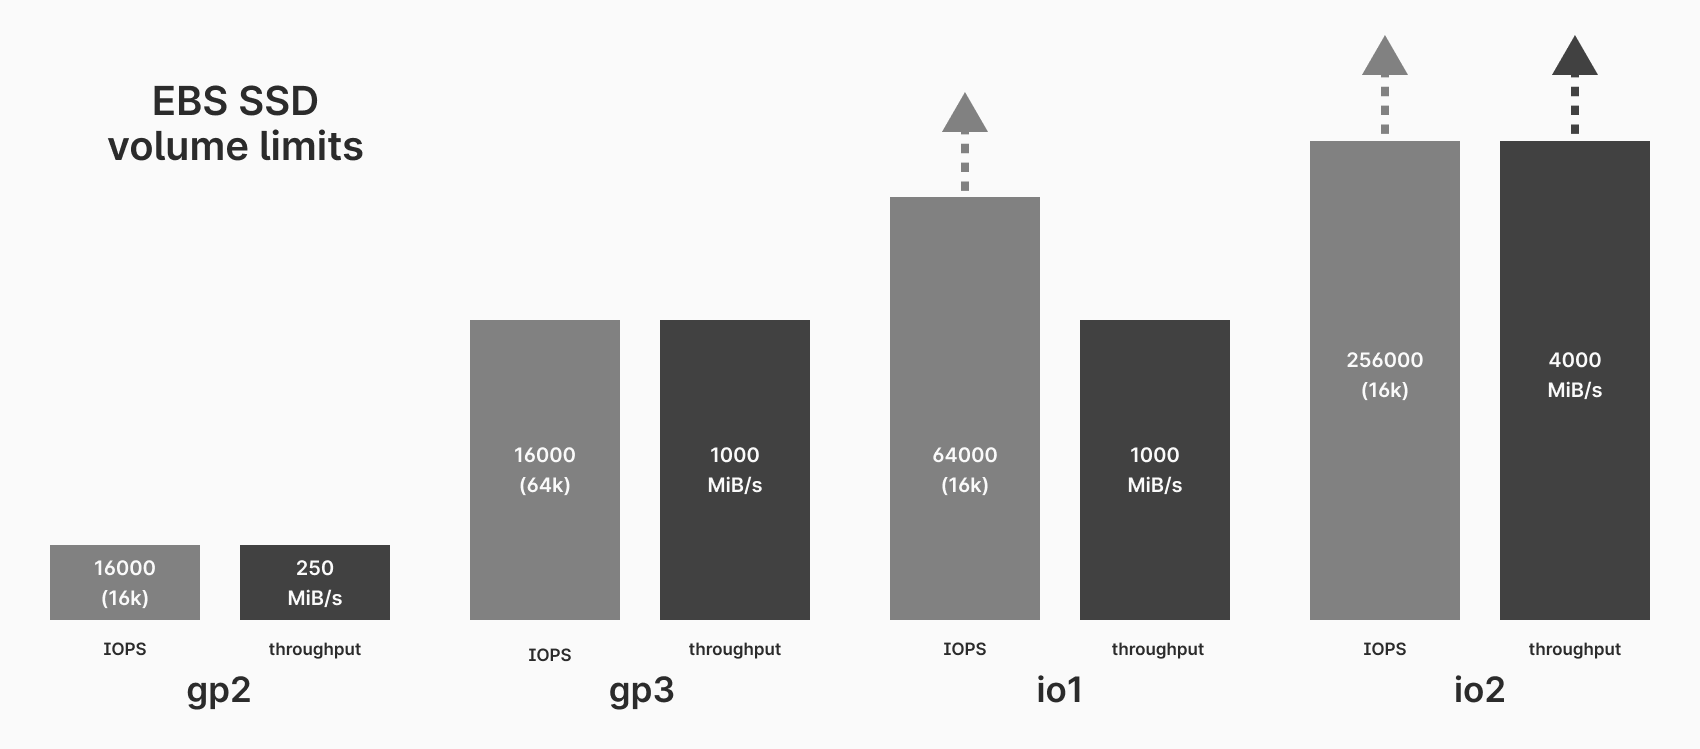
如果你运行的是带有单个主服务器的大型数据库,预置 IOPS 卷可能是你唯一的选择。
通过分片提升 IOPS 和吞吐量
数据库分片是一种高效运行大型数据库的优秀技术,无需支付 EBS 溢价。在分片数据库中,我们将数据分散到多个主节点上。这也意味着我们的 IO 和吞吐量需求被分散到这些实例上,使每个实例都能使用更经济的 gp2 或 gp3 EBS 卷。
基线对比
让我们看一些具体数字,以便更清楚地说明这一点。我们将首先看一个小型未分片数据库,然后将其与一个更大的数据库进行比较。所有价格均基于 2024 年 8 月的 us-east-1 数据库。警告——接下来有数学计算!
假设我们处于这样一种情况:需要一个包含一个主节点和两个副本节点的集群,每个节点大约有 8 个 vCPU、32 GB RAM 和 500 GB 存储。我们将比较三种不同的配置——两种来自 RDS MySQL,两种 Aurora MySQL,以及一种来自 PlanetScale(由 Vitess 和 MySQL 提供支持)。
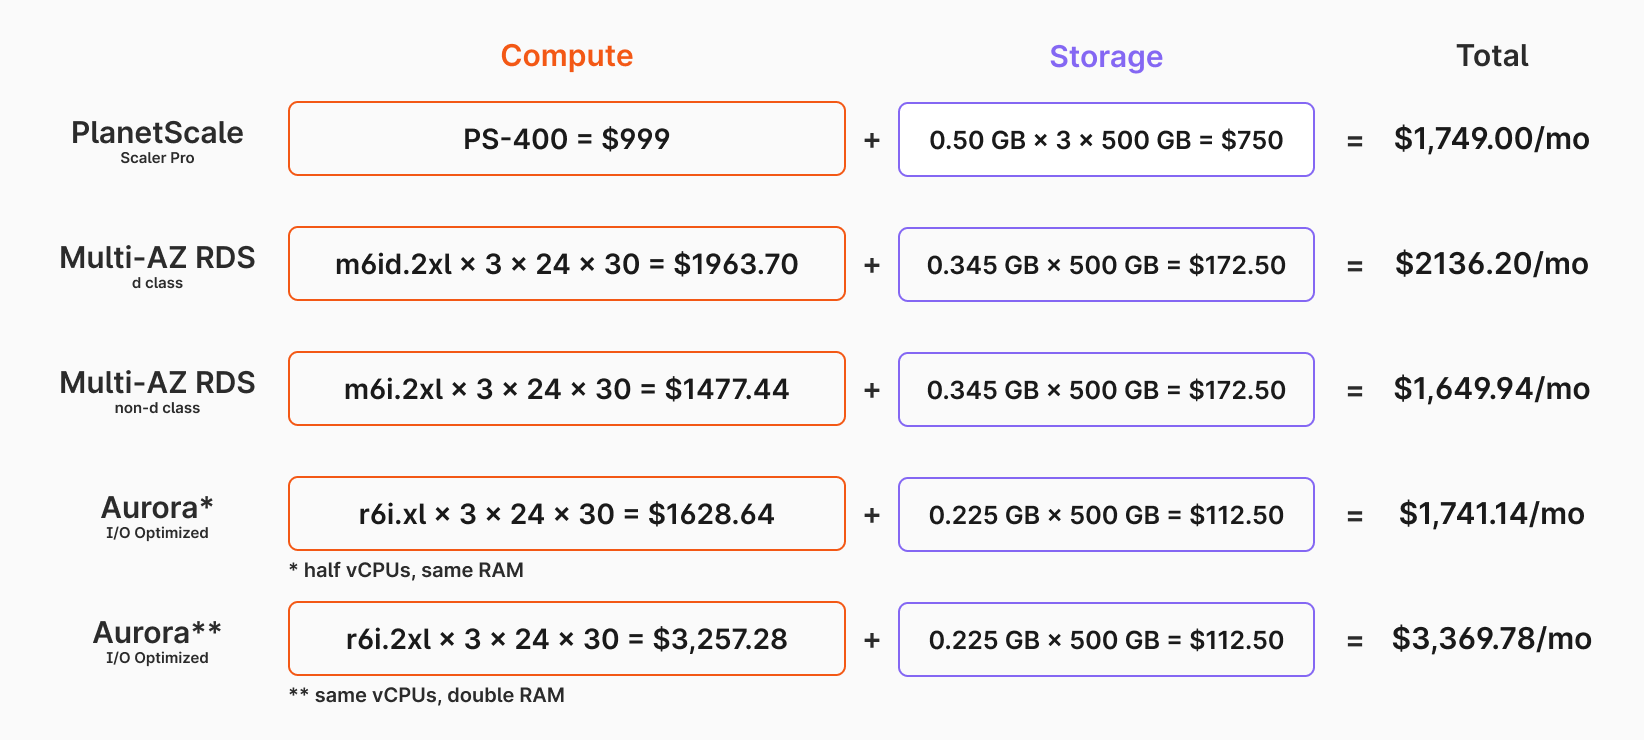
如上图所示,PlanetScale、RDS d 类、RDS 非 d 类以及两种 Aurora I/O 优化变体的月度成本分别为:$1749.00、$2136.20、$1649.94、$1741.14 和 $3369.78。Aurora 明显更贵,而其他几项则大致处于同一区间。
所有 PlanetScale Base 计划数据库都配置为多可用区集群,包含一个主节点和两个只读副本。在 PlanetScale 上,我们需要启动一个带有 500 GB 存储的 PS-400 数据库,才能达到我们的计算需求。
对于来自 RDS 的可比 3 节点、多可用区数据库,我们需要选择一个 db.m6id.2xlarge(或类似规格),并配置一个主节点和两个副本,以达到与 PS-400 相当的 vCPU 和 RAM 能力。其定价信息可在 Amazon 的定价页面上找到。
需要注意的是,对于 3 节点多可用区 RDS 集群,RDS 仅支持 d 类变体。这些变体除了 vCPU 和 RAM 外,还附带 NVMe SSD 存储。附带的 SSD 用于快速 I/O,但也会使用适当大小的 EBS 卷进行异步数据写入。
尽管从技术上讲它们不支持,但这里也包含了使用 db.m6i.2xlarge 实例(非 d 类)的假设 3 节点集群定价,以使比较更加对等。PlanetScale 比使用 db.m6id.2xlarge 实例的多可用区 RDS 实例更便宜,但比使用 db.m6i.2xlarge 实例的理论方案略高。
这里也包含了两种 Aurora I/O 优化配置,均包含一个主节点和两个只读节点。由于实例类限制,我们无法完全匹配相同的规格。其中一种显示为一半的 vCPU 和相同的 RAM,另一种显示为相同的 vCPU 和双倍的 RAM。
这些价格假设默认 IOPS 值足以运行我们的数据库。对于 RDS 选项,存储价格基于使用通用型 SSD 存储(gp3),且不支付额外 IOPS 或吞吐量费用。PlanetScale 也使用 EBS 卷。
更高的计算、IOPS 和吞吐量需求
随着时间推移,数据库上的需求可能会显著增长。假设一年后,我们现在需要 8 倍的计算、存储、IOPS 和吞吐量能力。我们对主节点和副本节点的新需求如下:
vCPUs
GB RAM
TB 存储
IOPS
MiB/s 峰值吞吐量
让我们再次考虑四种数据库配置。两种使用 RDS MySQL,两种使用 Aurora MySQL,一种使用 PlanetScale。
使用 d 类实例,我们需要 3 个 db.m6id.16xlarge 实例。我们可以通过 io1 / io2 实现,或者通过 4 卷条带化的 gp3 实现。本示例中我们将使用 io1,它同时具有每 GB/月价格和每 IOPS/月价格。只要我们有足够的 IOPS 来支持,就不需要额外付费来实现 1000 MiB 带宽。此配置的总费用为 $24,196.56/月(详细明细见下文)。
如果我们能够使用更实惠的 db.m6i.16xlarge 实例,这将使成本降低几千美元至 $20,519.52/月。
对于 Aurora I/O 优化版,我们为实例和存储付费。所有必要的 IOPS 均已包含在内。
通过分片降低成本
使用像 PlanetScale 这样的平台,我们不需要依赖单个巨大的实例来处理如此高的工作负载。如果数据库增长了 8 倍,我们可以改用分片,将数据和计算分散到 8 个分片上。
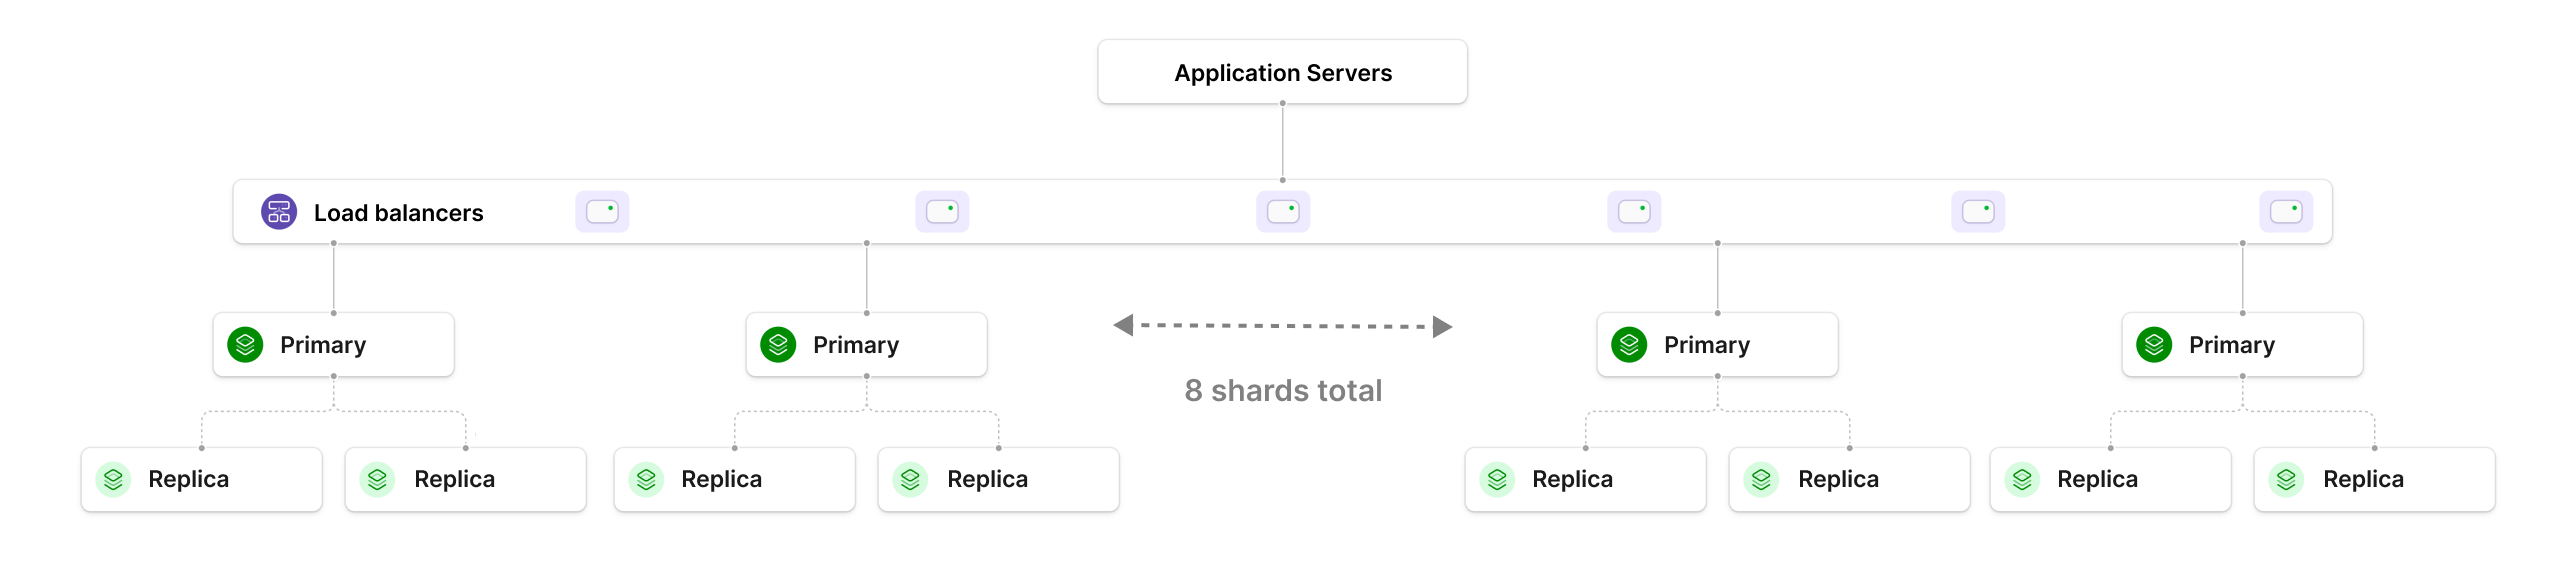
要进行分片,我们需要选择一个良好的分片策略,将数据和查询负载均匀地分散到各个分片上。每个分片本质上是一个多可用区 PS-400 集群,具有 8 个 vCPU、32 GB RAM 和约 500 GB 的存储数据。要计算其成本,我们将单节点成本乘以 8,总计为 $13,992/月。在这种情况下,我们不需要为额外的 IOPS 或专用的 io1 基础设施支付额外费用。IOPS 和吞吐量需求均匀地分散在 8 个分片上,使我们能够使用更实惠的 EBS 卷类型。在定价图中,包含一个额外的 PS-400 数据库用于存储较小的、未分片的表。
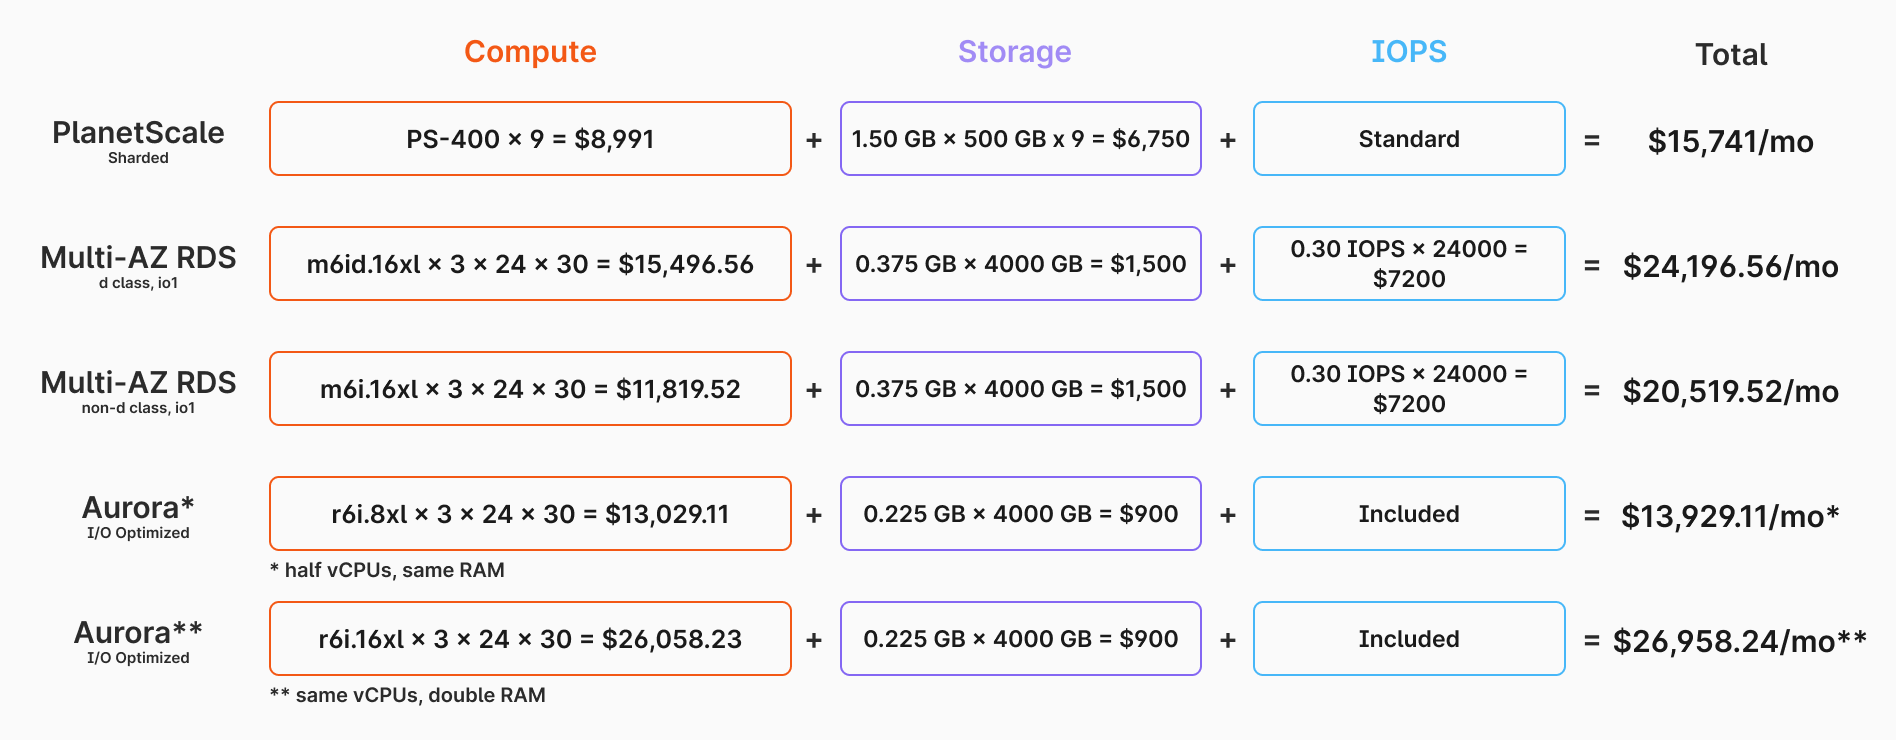
请注意,对于 RDS 实例,定价并未线性增长。成本跃升了 11-13 倍。对于 Aurora,成本线性增长,但基础成本一开始就很高。通过分片,我们获得了线性增长率和可接受的成本。这对于长期可扩展性来说是更好的选择。
此处不包含性能基准测试。这四种配置在生产工作负载中可能都具有独特的性能特征。然而,此比较的目的不是提供详细的性能分析,而是展示随着 I/O 和其他需求增加,定价如何扩展。
工作负载适用性
每种数据库都有不同的特性。有些具有大量的热数据,而另一些则较少。有些工作负载是突发的,而另一些则是平稳的。有些具有较大的存储与计算比率,而另一些则较小。所有这些因素都会影响数据库服务器的 IOPS 和吞吐量需求。如果您运行的数据库有如此高的需求,您可能会发现自己需要为这种性能支付显著更高的成本。
分片是这类工作负载的绝佳替代方案。分散数据也意味着分散 IOPS 和吞吐量需求,让你可以使用更经济的卷类型。分片还带来许多其他好处,包括改进的故障隔离、更快的备份以及巨大的可扩展性。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:PlanetScale Blog
原创地址:https://planetscale.com/blog/increase-iops-and-throughput-with-sharding
原文作者:PlanetScale Blog;如有侵权,请联系管理员删除。

