首先写下微调模型应学习的行为。用于总结科学文章的数据集,其提示和答案与客户支持或代码生成的数据集不同。这一范围决定了哪些任务应纳入数据集,以及什么样的回答才算好。
接下来,选择一种记录格式并一致使用。仓库中第 7 章的示例使用诸如 instruction、input 和 output 等字段。当 instruction 包含所有所需上下文时,input 字段可以为空。在预处理期间,每条记录都应映射到相同的聊天模板,以便模型能够可靠地区分请求和期望的响应。
我会构建一个仍然可以逐行实际检查的小型种子集。示例应来自模型预期处理的真实任务。在这一范围内,变化提示措辞、响应长度和难度会有所帮助。这些变化应反映实际使用情况,而不是为了多样性而人为制造多样性。
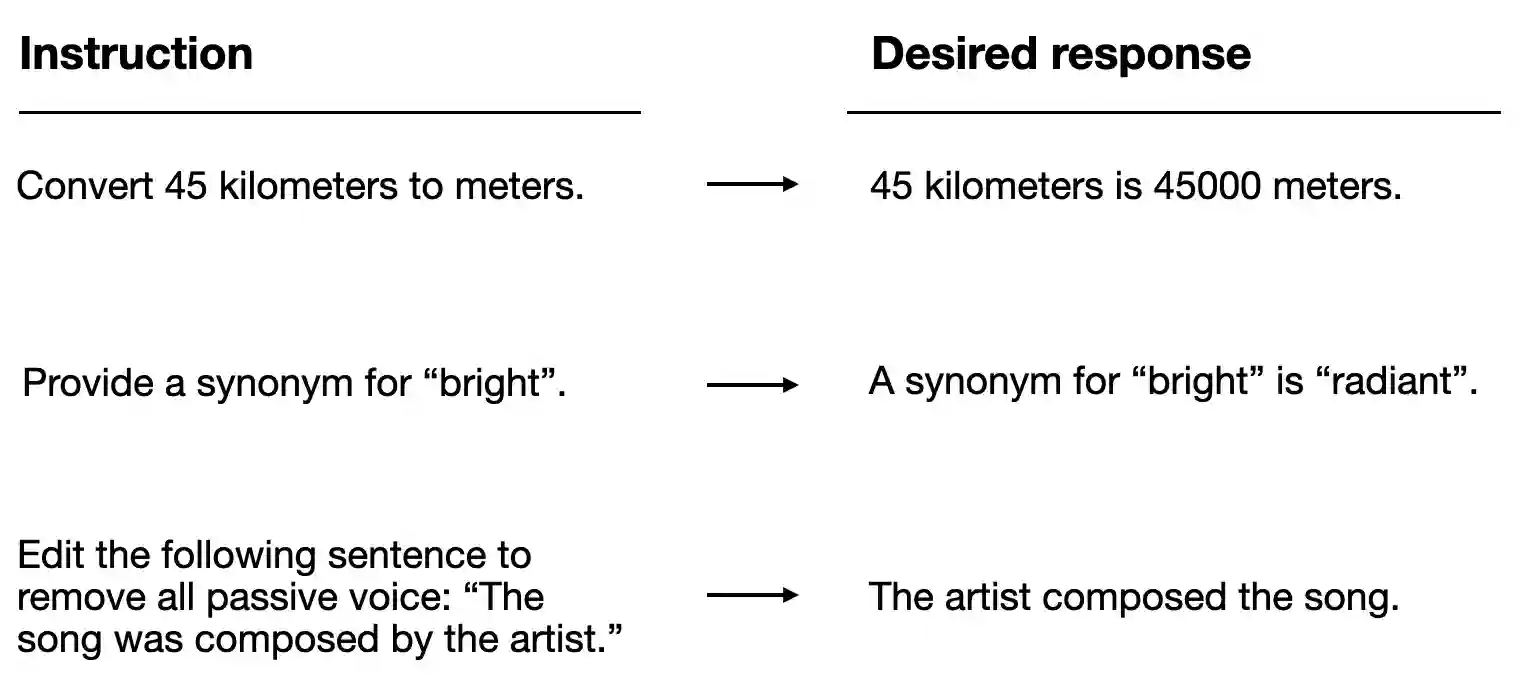
尽早创建训练集和评估集划分。来自同一来源或提示模板的示例应保留在同一划分中。否则,训练提示的合成改写可能会泄漏到评估集中,使结果看起来比实际更好。
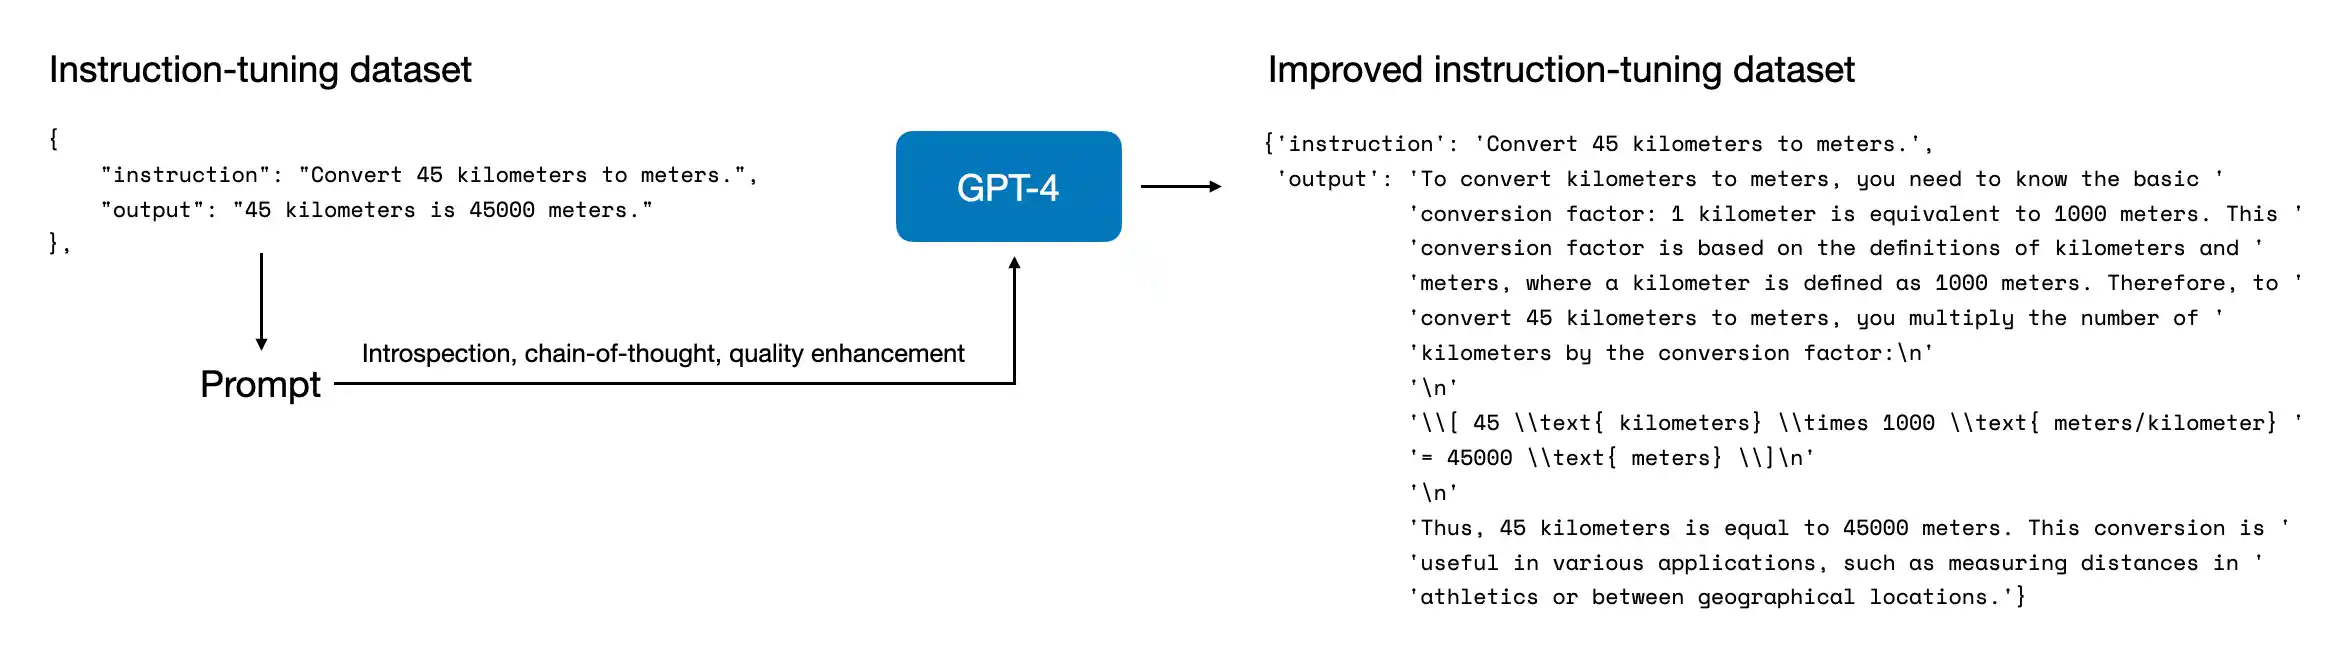
一旦种子数据状态良好,LLM(大语言模型) 可以帮助扩展它。仓库第 7 章的实用工具包括使用 Llama 3 和 Ollama 生成指令数据、创建变体,以及通过反思调优来改进响应的示例。合成输出仍然需要质量控制。我会检查事实错误、被忽略的约束、格式损坏,以及仅仅复述提示的答案。
去重应在训练前进行。精确字符串匹配可以捕获重复记录,而基于相似度的检查对于改写和轻微编辑的副本很有用。重复提示会使某一行为权重过高,而跨划分的重复项会污染评估。
在开始长时间微调运行之前,我会再进行一次人工检查。随机样本有助于发现系统性格式问题。困难示例有助于检查预期答案是否实际正确。还值得验证数据不包含私人材料,并且其来源允许预期用途。
一组经过审查的适度示例是合理的第一版。训练后,错误分析可以显示缺少哪些任务类型或响应模式。这为下一轮数据收集提供了具体目标,而不是盲目增加行数。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原创地址:https://sebastianraschka.com/faq/docs/build-instruction-dataset.html
原文作者:Sebastian Raschka;如有侵权,请联系管理员删除。

