若干现代大语言模型(LLM(大语言模型)),包括 Llama 风格的模型,在其注意力层和前馈线性层中省略了偏置向量。实际原因是,这些大型投影在没有学习到的偏移量的情况下已经表现良好。一旦某种架构和训练方案证明偏置是不必要的,省略它们就能在每个 Transformer(深度学习中的注意力模型架构) 块中节省一点工作量。
通常的线性层计算 xW + b,其中 W 是权重矩阵,b 是偏置向量。设置 bias=False 会移除 b 的加法。相对于矩阵而言,参数节省很小。例如,对于一个宽度为 4,096 的方阵层,矩阵包含约 1,680 万个权重,而偏置包含 4,096 个值。
同样的比较也适用于计算。矩阵乘法在该层的开销中占主导地位。添加偏置成本很低,尽管它仍然需要一次额外的向量加法,并且可能使融合实现变得复杂。在许多投影和 Transformer 块中,模型设计者可能更倾向于省略一个在其设置中未带来明显收益的组件。
人们很容易用 RMSNorm 或残差连接取代了偏置来解释这一选择。这种说法过于绝对。偏置可以移动某一层的预激活值,包括 SwiGLU 门的输入,而归一化或残差路径通常并不能使这种效应消失。无偏置投影是一种经验性的架构选择,而非数学上的必然要求。
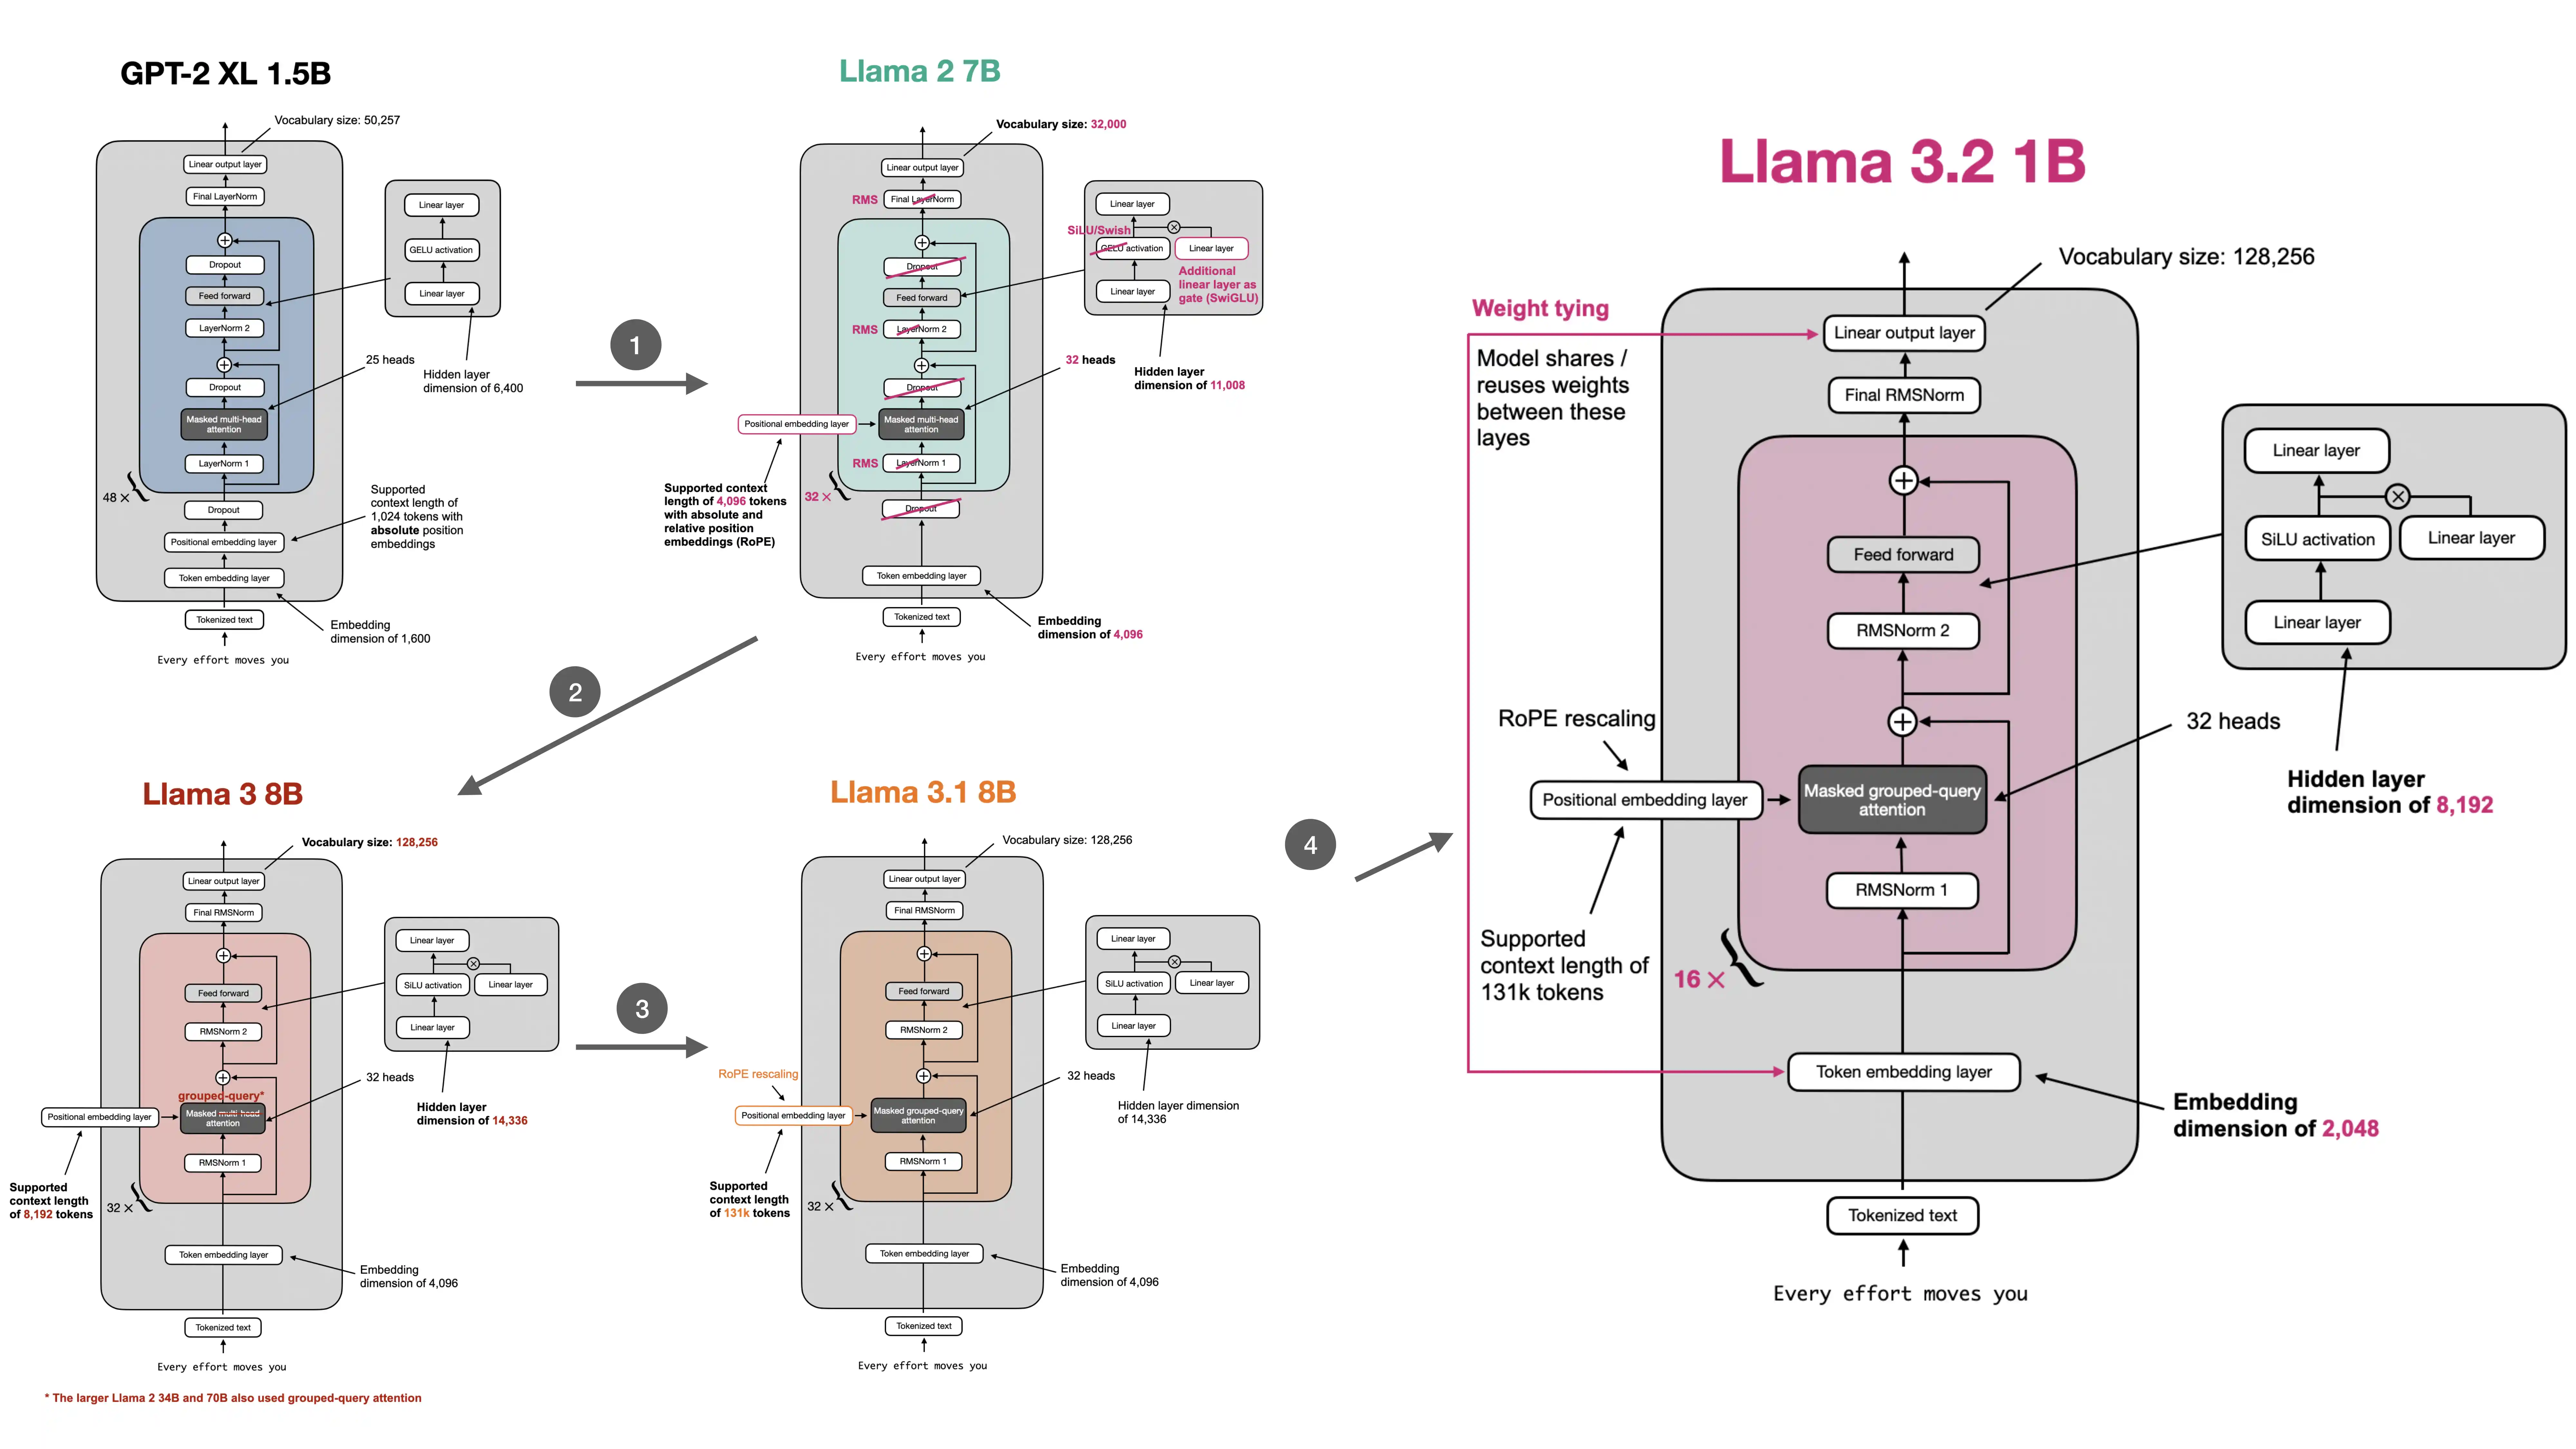
上图将无偏置层置于更广泛的 GPT 到 Llama 的过渡之中。它们通常与 RMSNorm、旋转位置嵌入和 SwiGLU 一同出现。这些是各自独立的设计决策,尽管现代模型系列常常将它们作为一个整体来采用。
模型是否使用偏置也取决于具体实现。某个模型系列可能从大型注意力和 MLP 投影中省略偏置,同时在其他地方保留其他学习到的偏移量。同样,带有偏置项的模型并不自动意味着效率更低或过时。
因此,我会将 bias=False 视为一种小型的、基于证据的简化。它移除了特定架构已证明可以不需要的学习到的偏移量。对于任何单层而言,节省是适度的,但这种改动很容易在大型 Transformer 中一致地应用。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原创地址:https://sebastianraschka.com/faq/docs/bias-terms-modern-llms.html
原文作者:Sebastian Raschka;如有侵权,请联系管理员删除。

