因果注意力(Causal attention)是一种自注意力机制,其规则是阻止来自后续 token 位置的信息。在位置 t 处,模型可以关注到包括 t 在内的位置。然后,生成的表示被用于预测位置 t+1 处的 token。
举一个小例子,考虑 token 序列“the cat sat”。当模型计算“cat”的表示时,它可以使用“the”和“cat”。它不能使用“sat”,因为“sat”在此时是下一个 token 的预测目标。

这种限制使得 GPT 风格的模型能够在完整序列上训练,而不会看到自身预测任务的答案。整个训练序列都存在于内存中,这使得并行处理多个位置成为可能。注意力掩码仍然限制了每个位置可以读取的内容。
如果没有掩码,“cat”的表示可能会包含来自“sat”的信息,然后用这些信息来预测“sat”。训练损失会因为错误的原因而变得很低。在生成时,未来的 token 并不存在,因此同样的捷径无法使用。
实现方式是在注意力分数矩阵上使用三角掩码。在 softmax 之前,指向后续位置的条目会被赋予负无穷大之类的值。因此它们的概率变为零,而对角线及其下方的条目仍然可用。
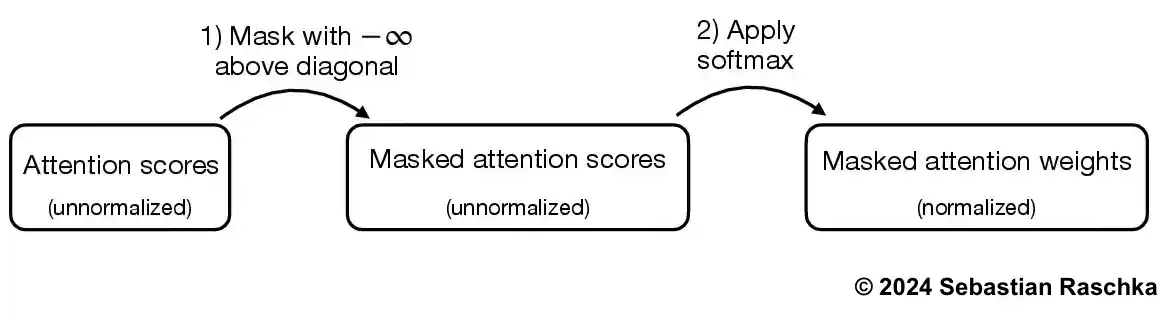
一个有用的结果是,所有位置仍然在同一次前向传播中贡献训练信号。位置 5 可以学习预测位置 6,而位置 20 学习预测位置 21。这些计算一起运行,并且由于掩码,每个计算观察到不同长度的前缀。
在推理时,生成使用相同的依赖模式。最终位置的表示可以使用提示词以及到目前为止生成的所有 token。它的 logits 选择下一个 token,该 token 在模型再次运行之前被追加。较早的位置只能访问较短的前缀,因此它们不能包含序列中稍后引入的信息。
像 BERT 这样的 Transformer(深度学习中的注意力模型架构) 编码器使用双向注意力。BERT 接收完整输入,并允许一个 token 关注两侧的位置。这适用于全文已知的任务,例如为分类构建表示。而仅解码器的 GPT 模型则需要文本生成所需的从左到右的依赖关系。
“不能看到未来”这个说法指的是当前序列内的位置。它并不意味着注意力跨度短。一个 token 仍然可以关注到可用前缀中很远的位置,直到模型的上下文窗口限制。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原创地址:https://sebastianraschka.com/faq/docs/causal-attention.html
原文作者:Sebastian Raschka;如有侵权,请联系管理员删除。

