多智能体编码系统失败,未必是因为智能体之间无法沟通。它们可能失败,是因为对话中做出的重要承诺之后无处安放。
TL;DR
当多个 AI 编码智能体相互交流时,它们仍然可能重复工作、搞错任务顺序并浪费时间。仅靠文本聊天不足以让它们保持一致。
为了解决这个问题,我围绕一个简单的想法构建了 ledger。如果某个智能体说“我来构建 items 文件”,我会把它记录为一项承诺,而不是让它淹没在聊天中。实现只用了 Python 标准库。不涉及数据库、API(应用程序编程接口) 或外部包。
在我的测试用例中,使用 ledger 避免了重复工作和依赖通知失败。它没有解决智能体未能完成任务或未经核实就报告工作的情况。
这就是关键结论:ledger 可以改善协调状态,但无法强制 AI 智能体完成其工作。
为什么即使沟通没问题,协调仍会失败
来自斯坦福和 SAP Labs 的团队最近发布了 CooperBench,这是一个用于测试编码智能体能否作为队友而非各自为战的独立工作者协同工作的基准 [1]。在设置中,两个智能体在同一个代码库上工作,各自获得一个功能,这些功能可能冲突,并且智能体可以在工作时进行沟通。
结果引起了我的注意。协作的智能体并没有始终表现得更好。在该基准中,协作配对的得分低于单个智能体处理相同总工作量的情况 [1]。
沟通分析也很重要。论文报告了含糊或时机不当的消息、对另一个智能体正在做什么的错误假设,以及智能体偏离已经做出的承诺的情况 [1]。
最后这一点促使我开展了这个项目。
我并不是说智能体会像人类那样“忘记”。问题更简单。一个智能体可以说“我将实现 repository/items.py”,几条消息之后,对话之外可能没有任何东西记录这一决定。另一个智能体可以做出同样的声明。依赖可能被遗漏。完成的任务可能被报告,却没有任何单独记录表明它是否真的经过验证。
该论文还发现了智能体成功协调的案例。在少数运行中,智能体在没有被明确指示的情况下划分了角色、分配了资源或协商了范围 [1]。所以协调是可能的。问题在于它并不可靠。
这让我有了一个更窄的问题来测试:
如果我把智能体的承诺从对话中拿出来,给它们一个存放的地方,会发生什么?
这就是我用 Commitment Ledger 构建的东西。它是一个小型确定性系统,将多智能体编码承诺记录为显式状态,并检查该状态是否存在冲突、依赖、遗漏的工作和返工。
完整代码、测试和日志如下。https://github.com/Emmimal/commitment-ledger/
我希望 Ledger 解决什么问题
我并不是试图解决所有多智能体失败。我想隔离一个具体问题:承诺存在于对话中,但另一个智能体在接手相同工作之前没有持久状态可供检查。
我见过这种情况如何在多个 AI 智能体针对同一代码库工作时发生,即使这些智能体在单独的终端会话中运行并通过共享文档进行协调。这种失败不会以协调 bug 的形式宣告自己。它表现为,在重复工作发生三轮之后,有人说:“等等,你不是已经做过这个了吗?”或者你发现一次合并悄悄覆盖了另一个智能体一小时前完成的东西。等你注意到时,浪费的工作已经发生了。
这不适用于单个智能体。没有需要跟踪的协调状态。当智能体已经拥有严格划分、互不重叠的文件所有权时也不需要,因为这在冲突问题开始之前就解决了它。
而且它不会告诉我工作是否正确。下面的结果让这一局限性非常清楚。
架构
这个流水线中没有模型调用。我将检测器、账本和检查构建为一组基于显式状态运行的 Python 规则。相同的输入每次都会产生相同的结果。
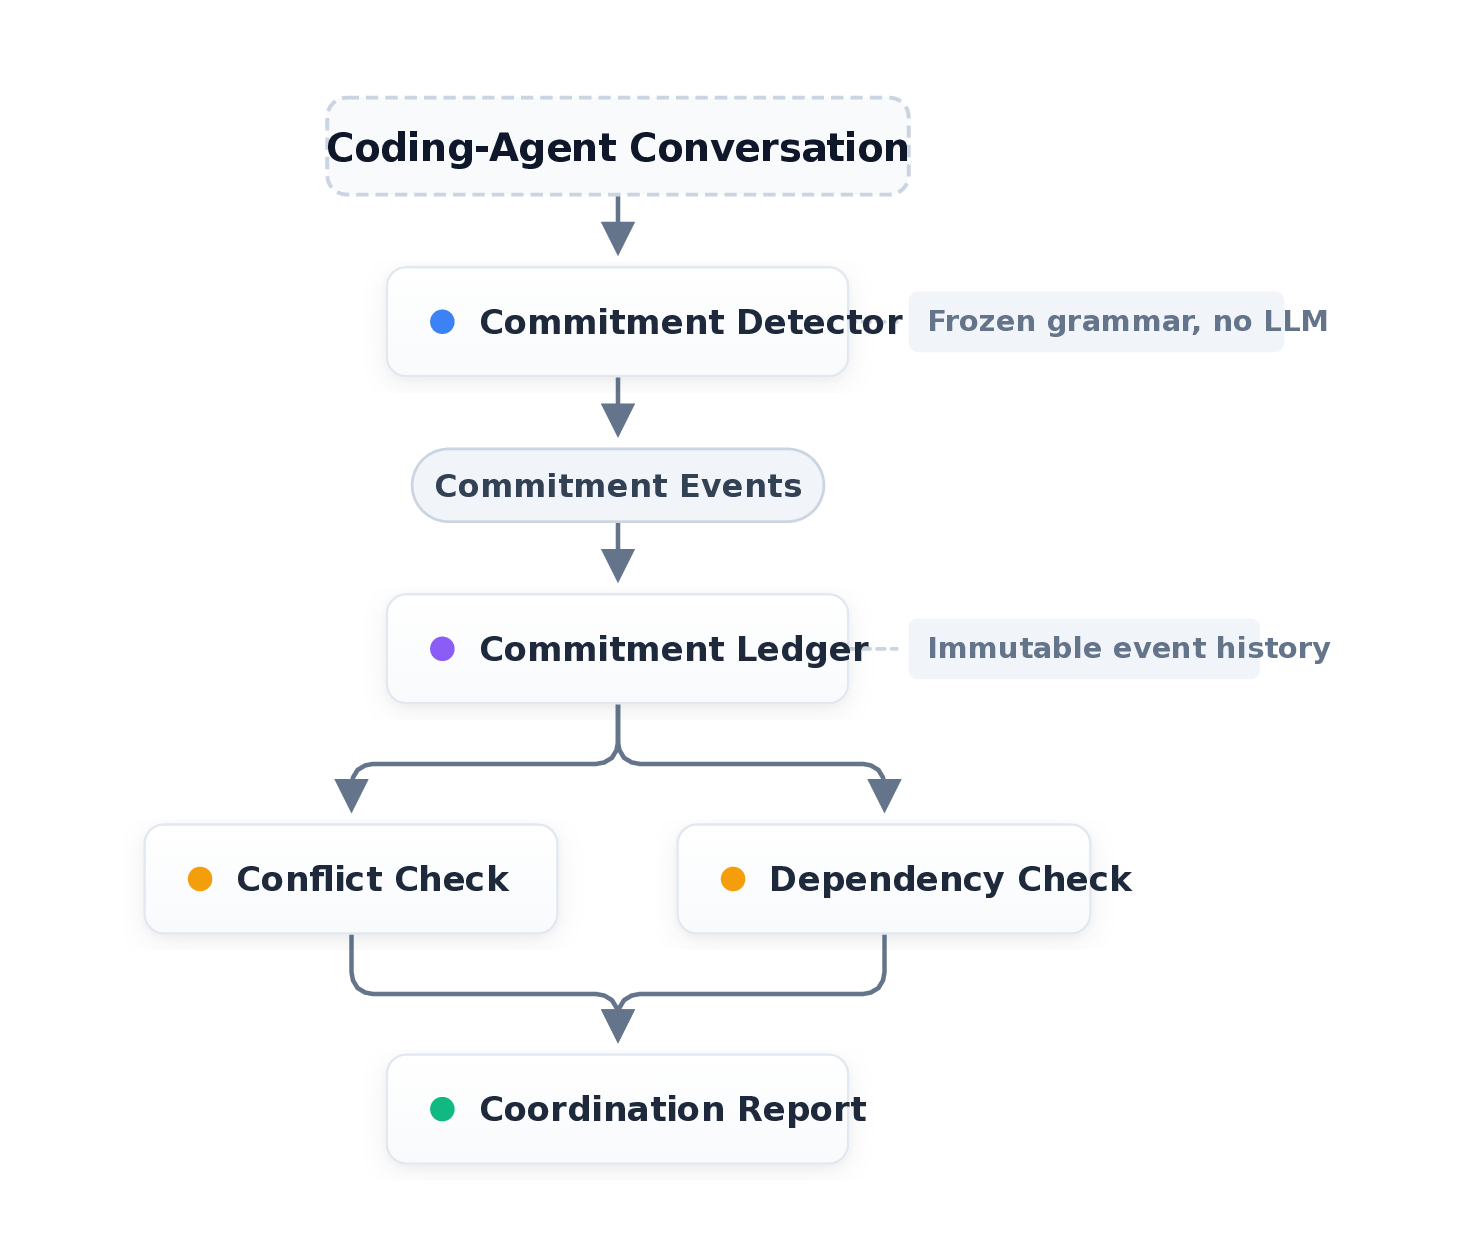
账本检查五种失败模式。每一种都源自账本中已存储的记录。没有任何内容来自智能体自己的报告,也不涉及人工判断。
组件 1:承诺检测器
我本可以使用 LLM(大语言模型) 来提取承诺,但那会给实验增加另一个变动因素。检测器将依赖于模型调用,结果也更难复现。我想测试的是账本本身,所以我有意将承诺检测保持得很小。
检测器识别四种形式:
I will <verb> <object>
I'll <verb> <object>
I am going to <verb> <object>
I'm going to <verb> <object>
动词必须来自一个固定的 13 词列表:
add, create, delete, implement, modify, remove, rename, refactor, update, fix, test, document, review
宾语还必须匹配一小组具体模式之一:
| 宾语类型 | 示例 | 合格条件 |
| --- | --- | --- |
| 文件路径 | repository/items.py | 可识别的扩展名,带可选目录段 |
| snake_case | stock_tracker | 由下划线分隔的小写单词 |
| camelCase / PascalCase | ItemRepository | 包含小写到大写的转换 |
| 点分路径 | pricing.rules | 以点分隔的段 |
| 引号字符串 | "item listing" | 完整的引号范围 |
| 端点路径 | /items | 以 / 开头 |
其他任何内容都是 NOT_A_COMMITMENT 。
没有语义回退。检测器不会试图推断这个人可能想表达什么。
CANDIDATE_PATTERN = re.compile(
r"^\s*i(?:'ll| will| am going to|'m going to)\s+"
r"(?P<verb>[a-z]+)\s+"
r"(?P<object>.+?)\s*[.!]?\s*$",
re.IGNORECASE,
)
这种严格性是有代价的。"I'll handle the pricing stuff" 对人类读者来说是一个真实的承诺,但检测器会拒绝它。我不希望检测器去猜测 "handle" 是什么意思,或者判断 "the pricing stuff" 是否足够具体。
所以我把这部分保持得很严格。如果句子不匹配规则,它就会被拒绝。这使检测器不那么灵活,但我可以准确测试它接受什么以及为什么。
在信任检测器之前对其进行测试
在将检测器用于协调测试之前,我想检查它在答案不明显的情况下的表现。我制作了一个包含150行手工标注的测试集:60个承诺,涵盖所有四种句子形式和所有六种对象类型,外加90个负例,分为六个类别。
| 负例类别 | 示例 | 为什么应被拒绝 |
| --- | --- | --- |
| 第三人称 | "Agent(智能体) B will update repository.py ." | 该句子是关于另一个智能体的 |
| 模糊限定 | "I think we should update the repository." | 这是一个建议,不是承诺 |
| 疑问句 | "Did you update repository.py ?" | 它包含一个有效对象,但不是承诺 |
| 不确定性 | "I'll probably update repository.py ." | 额外的词改变了句子 |
| 模糊对象 | "I'll update the pricing rules." | 没有具体目标 |
| 无关 | "The tests are flaky today." | 完全不是承诺 |
我还特意加入了这一对:
"I'll update pricing.rules."          ->  COMMITMENT
"I'll update the pricing rules."      ->  NOT_A_COMMITMENT
它们几乎完全相同。唯一真正的区别在于对象。第一个匹配点分路径规则。第二个不匹配。
检测器把全部150行都判断正确了:
- 真阳性:60
- 假阳性:0
- 假阴性:0
- 真阴性:90
- 精确率:100%
- 召回率:100%
- 假阳性率:0%
这些数字仅适用于这个测试集。这些案例是我自己创建并标注的,因此它们表明检测器遵循了我给出的规则。它们并不能说明它在任意编码智能体对话中的表现。我没有那个数据集,所以我不会做出那样的断言。
对抗性测试发现的 bug
150行的测试集很干净,所以我尝试了不在其中的案例。这暴露了点分路径规则中的一个真实问题。
该规则过于宽松。它接受了 repository.pyz ,这看起来像文件路径,但扩展名可疑;还接受了 a.b.c.d,它由四个非常短的分段组成。
我尝试收紧规则。这修复了那些案例,但它也拒绝了 models.item ,而后者在我的测试集中本来就是一个有效的正例。
这就是该规则遇到限制的地方。字符串本身没有足够的信息来判断 models.item 是有效的模块路径,还是 repository.pyz 是拼写错误。两者都只是小写的点分字符串。
所以我测试了两个版本:
| 版本 | 拒绝 repository.pyz | 接受 models.item | 代价 |
| --- | --- | --- | --- |
| 宽松 | 否 | 是 | 拼写错误有时会被接受 |
| 严格 | 是 | 否 | 真实的提交可能被拒绝 |
我保留了宽松版本。
对于这个检测器来说,拒绝真实的提交是更严重的失败。像 services.export 或 config.defaults 这样的路径可能完全有效,即使最后一部分很短。
所以这不是我试图用另一条规则来隐藏的问题。这个限制在代码中有文档记录,检测器保留了能保留这些有效案例的版本。
组件 2:账本
检测器产生一个事件:COMMITTED。之后,我为每个提交保留历史记录,而不是存储一个状态值并在每次发生事情时替换它。
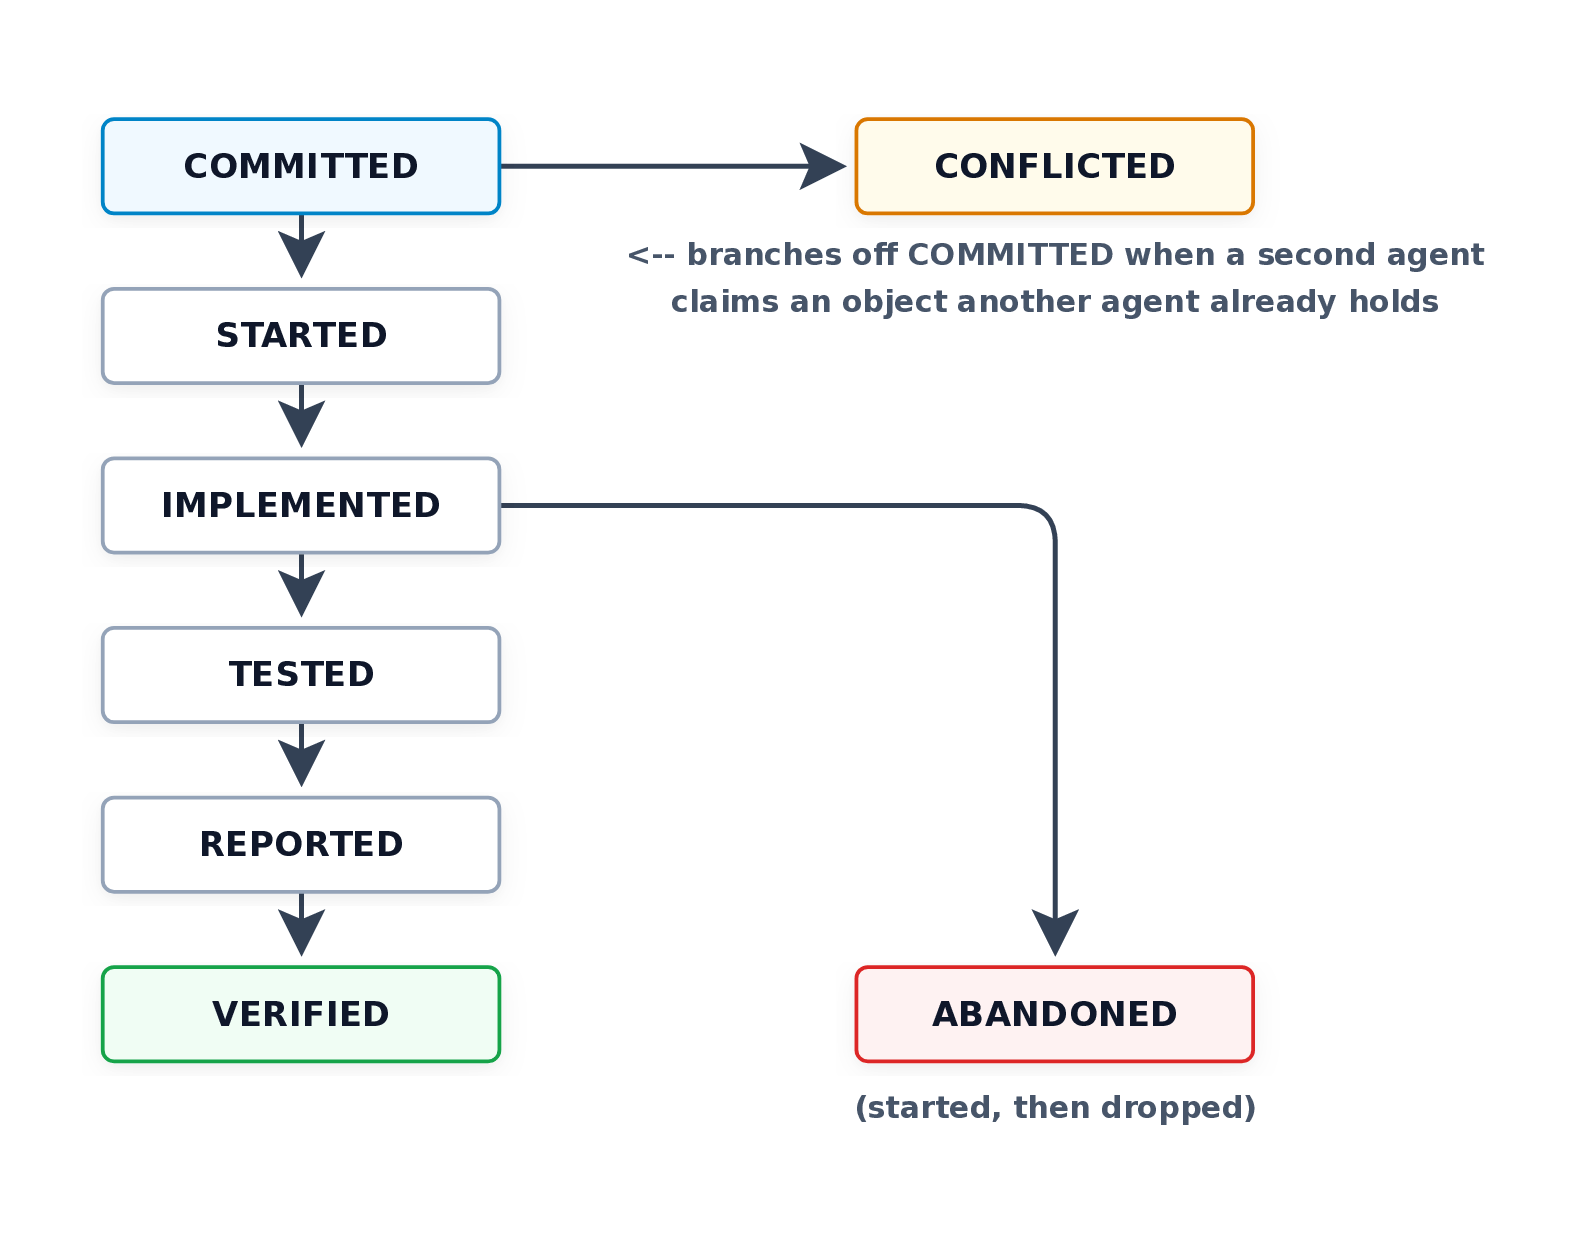
我选择历史记录是因为我不想让后来的事件抹去之前的事件。如果账本只存储当前状态,一次错误的更新可能会替换掉我仍然需要用来理解发生了什么的信息。
这实际上发生在我第一次实现中。
当冲突检查发现重复声明时,我把两个提交都标记为 CONFLICTED。这意味着 Agent A 的原始提交可能仅仅因为 Agent B 后来声明了同一个文件而变成冲突状态。
这是错误的。如果 Agent A 已经到达 REPORTED 状态,Agent B 后来的声明不应该改变 A 的历史。我修复了检查,只将新声明标记为 CONFLICTED。
账本记录了每个承诺所经历的事情。它不会因为另一个智能体后来犯了错误,就回溯并更改更早的事件。
我用五条规则来发现这些历史记录中的协调问题:
| 发现 | 规则 |
| --- | --- |
| 遗漏的承诺 | 仍处于 COMMITTED 或 STARTED 状态,且从未推进 |
| 未验证的承诺 | 到达 REPORTED 但从未到达 VERIFIED |
| 冲突的承诺 | 另一个智能体声称拥有已被其他智能体持有的对象 |
| 依赖未通知 | 到达 IMPLEMENTED 或更晚阶段,但所需的前置条件仍然缺失 |
| 返工 | 到达 IMPLEMENTED 或更晚阶段,随后被 ABANDONED |
账本不评判代码本身。它只追踪承诺及其周围协调所经历的事情。
组件 3:测试用例
我想要一个足够小、可以手动跟踪,但仍然具有真实依赖关系的任务,因此我使用了一个最小的物品目录:
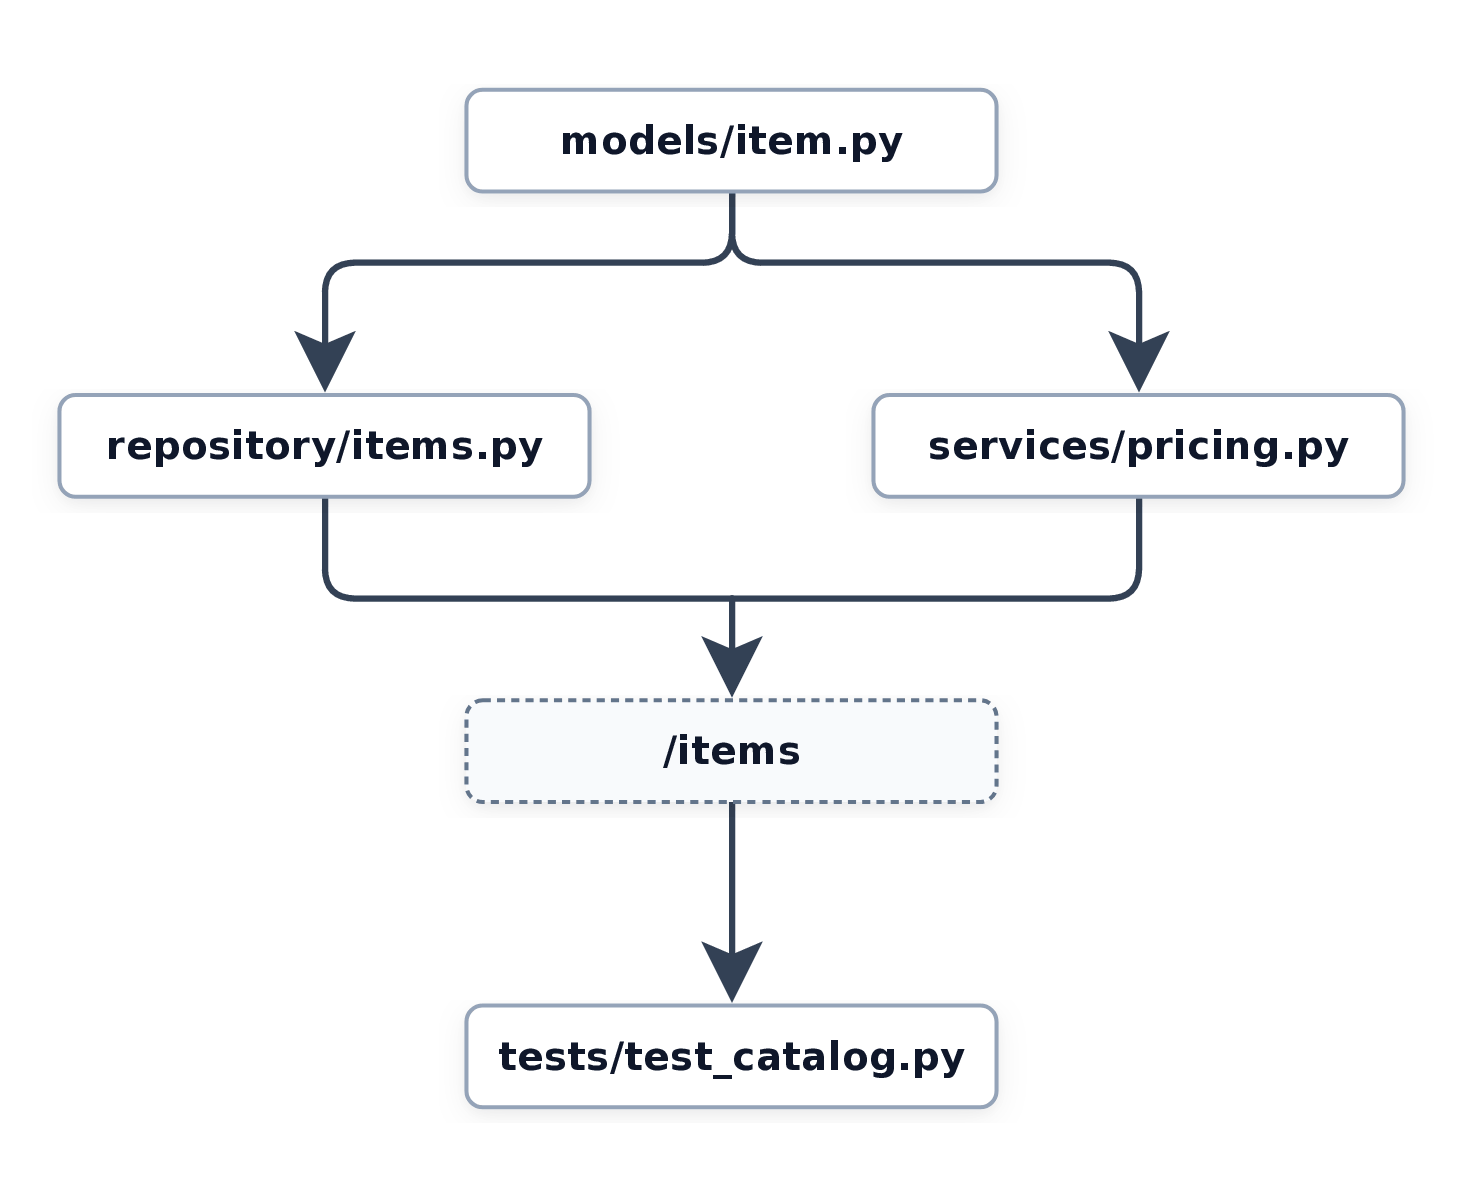
有两个智能体,且没有预先分配归属。它们必须自行决定谁承担每一项工作。这是有意为之的。如果我事先把每个文件分配给一个智能体,我试图测试的主要冲突就会消失。
我为同一个任务写了两份记录。
在第一份中,智能体仅通过聊天进行协调。在第二份中,它们在承接任务之前会检查现有的承诺。处理这两份记录的代码完全相同。唯一的区别是智能体在这两种情况下的行为。
这些是手写的固定装置。它们不是来自实时多智能体模型运行的记录,也不是统计样本。这是一个精心设计的示例,旨在检验账本的规则,而不是基准测试。
结果:实际输出
这是 evaluator.py 对两份记录的终端输出。在运行评估器和撰写本节之间,我没有更改代码。
=== Coordination report: chat-only ===
Total commitments registered: 5
Missed commitments (1):
- C4 (B -> tests/test_catalog.py): "I will test tests/test_catalog.py."  [state=COMMITTED]
Unverified commitments (1):
- C2 (A -> repository/items.py): "I'll implement repository/items.py."  [state=REPORTED]
Conflicted commitments (1):
- C5 (B -> repository/items.py): "I'll implement repository/items.py."
Dependency-not-notified findings (1):
- C3 (B -> /items): "I'll implement /items."  [missing prerequisite: services/pricing.py]
Rework (1):
- C5 (B -> repository/items.py): "I'll implement repository/items.py."
=== Coordination report: chat+ledger ===
Total commitments registered: 5
Missed commitments (1):
- C4 (B -> tests/test_catalog.py): "I will test tests/test_catalog.py."  [state=COMMITTED]
Unverified commitments (1):
- C2 (A -> repository/items.py): "I'll implement repository/items.py."  [state=REPORTED]
Conflicted commitments (0):
Dependency-not-notified findings (0):
Rework (0):
| 指标 | 仅聊天 | 聊天 + 账本 | | --- | --- | --- | | 遗漏的承诺 | 1 | 1 | | 未验证的承诺 | 1 | 1 | | 冲突的承诺 | 1 | 0 | | 未通知的依赖 | 1 | 0 | | 返工 | 1 | 0 |
两次运行都登记了相同的五个承诺。C1 未出现在任何失败列表中。C2 到 C5 展示了两种条件之间的差异。
账本并未减少承诺的总数。它改变了在这个特定记录中三个协调问题的检测方式。
账本带来了什么变化
对比中有三个数字发生了变化:冲突的承诺、依赖通知发现项和返工。
冲突,以及 C2 / C5 对
冲突是最容易看到的。两个智能体都声称对同一个文件负责:
C2   Agent A -> repository/items.py
COMMITTED -> STARTED -> IMPLEMENTED -> TESTED -> REPORTED
C5   Agent B -> repository/items.py
COMMITTED -> CONFLICTED
在仅聊天的记录中,智能体 B 不知道智能体 A 已经在处理该文件:
智能体 B:我将实现 repository/items.py 。智能体 A:等等,我已经完成了那个。我之前发过相关消息。智能体 B:哦,我一定是错过了。我还是自己构建了一份副本,以防万一。
有了账本,智能体 B 会先检查现有的承诺:
智能体 B:我看到 repository/items.py 已经由智能体 A 在处理了。智能体 B:我将实现 services/pricing.py 。
智能体和任务都是相同的。区别在于第二个智能体在提出声明之前有东西可以检查。
账本还将 C2 和 C5 分开记录。C2 保留在其原始历史中。C5 是被标记为 CONFLICTED 的那个。后续的重复声明不会改变第一个承诺所发生的事情。
依赖未被通知:C3
在仅聊天运行中,Agent B 在 services/pricing.py 尚未被认领的情况下就开始处理 /items。当 /items 达到 IMPLEMENTED 时,依赖检查会捕获这一点。
在账本运行中,Agent B 在接受任务之前会检查现有的承诺,因此依赖条件得到满足,该发现不会出现。
返工
返工发现来自同一个冲突。C5 达到 IMPLEMENTED,然后在发现重复工作后被放弃。
在账本条件下,该重复声明不会发生,因此此返工不会出现在报告中。
这三个发现都涉及在正确时间不可用的信息。谁已经认领了该文件?依赖是否已被处理?是否已有另一个智能体在处理同一件事?
这就是账本旨在保持可见的部分。
账本未能提供帮助的地方
两个没有变化的数字同样重要:
Missed commitments:       1 -> 1
Unverified commitments:   1 -> 1
C4 是 Agent B 编写 tests/test_catalog.py 的承诺。在两次运行中都保持在 COMMITTED 状态。账本记录了该承诺,但没有人开始工作。账本中没有任何东西能让智能体拾起它已忽略的任务。
C2 是 Agent A 在 repository/items.py 上的工作。它达到了 REPORTED 状态,但从未达到 VERIFIED 状态。账本记录了 Agent A 所报告的内容。它不会独立检查代码或运行测试来判断该报告是否真实。
这就是该系统的边界。
在这个例子中,账本帮助解决了因缺少共享状态而导致的协调失败。它并没有改变智能体是否坚持到底,也没有验证所报告的工作是否实际正确。
所以我不会将其描述为一个能让编码智能体变得可靠的系统。结果更为有限:让承诺变得明确可以帮助解决一些协调失败,但它并不能解决执行或验证问题。
| 失败类型 | 示例 | 实际修复方式 |
| --- | --- | --- |
| 协调 | 重复工作、遗漏依赖 | 共享的、可检查的状态 |
| 执行 | 工作从未开始、完成从未被验证 | 强制执行、截止时间、真实测试运行 |
这些是不同的问题。账本处理第一个问题。第二个问题需要账本之外的东西。
这不能证明什么
这是一个经过设计的示例。我设计它是为了演练全部五条检测规则,所以它不是基准测试,也不是来自许多独立运行的样本。
这意味着我不能用这些结果来说明真实编码智能体遇到这些问题的频率,或者承诺账本在更大系统中会有多大帮助。
检测器的 150 行结果也有同样的局限性。它是对手工构建的标注集进行的回归测试。它表明检测器在这些案例上遵循了规则,但并不能告诉我这些规则在真实智能体对话中会有多好地成立。
设计承诺账本还有其他方式,而这五种失败模式只是我选择在这里追踪的那些。它们并不是多个编码智能体协同工作时可能出错的所有情况的完整列表。
如果我要真正部署这个系统
在我把它放入真正的多智能体编码流水线之前,有三件事我会做出改变。
首先,VERIFIED 需要来自账本之外的某个东西。这可以是一次实际的测试运行、一次 diff 审查,或某种其他独立检查。目前,账本信任它收到的事件。这足以演示状态机,但不足以捕捉智能体声称某件事能工作而实际上不能工作的情况。
其次,错过的承诺需要某种后续跟进。在当前示例中,除非有人注意到,C4 可以永远停留在 COMMITTED 状态。一个真实系统可以标记那些在一定轮数或一定时间内未被触碰的承诺。确切的阈值将取决于工作流。
这与仅仅记录承诺不同。账本告诉我一个承诺存在。还需要其他东西来确保它得到关注。
第三,依赖关系图应该来自代码库,而不是手工编写。硬编码五个关系对这个示例来说没问题。一旦项目变大,它就撑不住了。真实代码库中的依赖关系会随着代码变化而变化,因此手动维护该图很快就会成为另一个过时信息的来源。
这些改变都不是特别复杂。我略去它们是因为它们会改变我正在测试的内容。
这里的问题更窄:让承诺显式化是否会改变协调结果?
在这个示例中,对于由缺失共享状态导致的失败,它确实改变了结果。对于由智能体未跟进导致的失败,它没有帮助。
设计决策与局限
状态来自事件,而不是更多的语言解析。在 COMMITTED 之后,状态 STARTED、IMPLEMENTED、TESTED、REPORTED 和 VERIFIED 来自传递给账本的事件。我没有添加另一种语法来读取智能体消息并猜测这些事情何时发生。那会使结果依赖于另一层解释。
每行一个承诺。检测器只查看它收到的文本开头。因此,像“Repository and pricing both look done, so I'll implement /items now”这样的句子不会被登记。我将记录保持为承诺单独出现在一行上的形式,而不是为这类情况添加另一个解析器。
这确实留下了一个缺口。智能体可以在一个较长句子的中间做出承诺,而检测器会漏掉它。要正确处理这一点,意味着需要在承诺检测器介入之前先弄清楚实际句子或从句从哪里开始。
承诺重新协商未被建模。一个智能体可能从一项任务开始,之后改变范围。此版本没有对应的状态。一旦承诺被记录,账本可以追踪其后续变化,但无法理解原始承诺被更改的对话。
我只测试了两个智能体。冲突检查本身并不依赖于恰好有两个智能体。它会查找在同一对象上具有活跃承诺的另一个智能体。但我尚未在三个或更多智能体的情况下测试该系统,因此我不想假设相同的结果在那里也成立。更多智能体还会引入此版本未建模的依赖链。
要点
当多个编码智能体在同一个代码库上工作时,仅靠对话是不够的。一份小型的持久化承诺记录可以在某些协调问题变成重复工作、冲突或依赖错误之前使其变得可见。
但记录承诺并不意味着工作会完成。也不意味着结果是正确的。
承诺账本可以改善协调状态。它无法创造执行纪律。
这就是我在此展示的局限。账本帮助解决了因缺少共享状态而导致的问题。它没有解决因智能体未跟进或工作仍需独立验证而导致的问题。
资源
代码和数据:完整源代码、150 行带标签的检测器数据集、两个示例对话记录以及完整的测试套件(12 个测试)可在 https://github.com/Emmimal/commitment-ledger/ 获取。检测器、账本和评估器仅使用 Python 标准库。测试套件使用 pytest。
参考文献
[1] Khatua, A., Zhu, H., Tran, P., Prabhudesai, A., Sadrieh, F., Lieberwirth, J. K., Yu, X., Fu, Y., Ryan, M. J., Pei, J., & Yang, D. (2026). CooperBench: Why Coding Agents Cannot be Your Teammates Yet. arXiv preprint arXiv:2601.13295. https://arxiv.org/abs/2601.13295
[2] CooperBench 项目页面和基准代码。https://cooperbench.com/ 和 https://github.com/cooperbench/CooperBench
[3] Python Software Foundation. (2024). re — Regular expression operations. Python 3.12 Standard Library Documentation. https://docs.python.org/3/library/re.html
[4] Python Software Foundation. (2024). dataclasses — Data Classes. Python 3.12 Standard Library Documentation. https://docs.python.org/3/library/dataclasses.html
披露
本文中的所有代码均为我的原创作品,在 Python 3.12(Windows)上开发和测试。系统本身——检测器、账本和评估器——仅使用 Python 标准库。测试套件使用 pytest。在任何时候都不需要 API 密钥、网络访问、数据库、向量存储或外部模型调用。
本文中的每个终端输出块和结果表均直接取自交付代码库的实际运行结果,未经编辑,并在发布前在第二台机器上独立复现。
本文中的所有图表,包括特色图片,均由作者创建。特色图片使用 ChatGPT(DALL·E)生成。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:Towards Data Science
原创地址:https://towardsdatascience.com/multi-agent-coding-isnt-enough-agents-need-a-commitment-layer/
原文作者:Emmimal P Alexander;如有侵权,请联系管理员删除。

