数据质量问题往往不是在数据入库时才出现的。客户信息缺少关键字段、不同系统中的商品编码不一致、订单状态更新滞后,或者统计报表中的金额与业务系统对不上,都可能让后续的运营分析、自动化流程和经营决策受到影响。数据质量治理的关键,不是笼统地判断“数据好不好”,而是把质量要求转化为可检查、可计算、可追踪的规则。
在实践中,企业可以从完整性、准确性、一致性、及时性、唯一性和有效性六个维度建立基础评估框架,再根据业务场景增加可追溯性、可用性等专项指标。六个维度并非孤立存在:一条记录可能字段齐全,却包含错误值;也可能数据本身准确,但同步太晚,已经无法支持当前业务。
一、完整性:关键数据有没有缺失
完整性衡量数据是否具备业务处理所需的字段和记录。它既包括字段层面的完整,也包括记录和业务事件层面的完整。例如客户档案是否包含客户编码、名称和归属组织,订单是否缺少明细行,某一业务日期的数据是否全部进入数仓。
常见衡量方式包括必填字段非空率、应到记录与实到记录的差异率、关键业务对象覆盖率等。计算时需要先明确分母:如果只统计已入库记录的非空率,就可能忽略整批数据没有到达的问题。因此,对订单、交易流水等场景,通常还要结合源端数量、目标端数量或业务对账结果进行检查。
治理时不宜把所有字段都设为必填。应根据业务规则区分强制字段、条件必填字段和可选字段,并明确缺失后的处理方式,例如拦截、暂存、补录或告警。
二、准确性:数据是否真实反映业务事实
准确性关注数据值与真实业务事实是否一致。客户联系电话格式正确,并不意味着号码一定有效;库存数量是整数,也不代表它与仓库实际库存相符。准确性判断往往需要权威数据源、业务凭证、外部校验结果或人工核验作为参照。
可以采用抽样核验准确率、业务对账差异率、关键字段核验通过率等指标。财务金额、库存数量、证件信息等高风险字段,应设置更严格的校验规则和复核机制。需要注意,格式校验只能证明数据符合格式要求,不能单独证明其业务真实性。
如果企业缺乏权威参照,准确性就很难仅靠技术规则判断。此时应先确定数据责任部门、权威来源和纠错流程,再逐步把人工经验沉淀为可重复执行的规则。
三、一致性:跨字段、跨系统是否相互匹配
一致性主要看同一业务事实在不同字段、表、系统或指标口径之间是否保持一致。例如客户系统中的客户编码与订单系统引用的编码是否对应,订单总额是否等于明细金额汇总,ERP 与 CRM 中同一客户的名称、状态和归属是否符合约定。
衡量指标可以包括跨系统匹配率、字段映射通过率、业务规则校验通过率以及对账差异率。企业需要先建立统一的数据标准和映射规则,否则系统之间即使数据不同,也无法判断差异究竟是错误还是合法的业务表达。
解决一致性问题不能只依赖定期覆盖。应先明确哪个系统负责创建、哪个系统负责审批、哪些系统只消费数据,并规定变更的同步方式、失败补偿和冲突处理策略。对于关键数据,可通过接口、消息或批量同步机制分发,同时保留处理日志和异常记录,便于追溯差异来源。
四、及时性:数据到达和更新是否满足业务时限
及时性衡量数据从产生、变更到目标系统可用之间的时间差。对于经营分析,按小时或按天更新可能已经足够;对于库存扣减、支付状态或生产异常,几分钟的延迟都可能影响业务执行。因而,及时性没有脱离场景的统一标准。
可用数据延迟、任务按时完成率、事件处理时长、超时任务比例等指标进行衡量。制定阈值时,应区分业务发生时间、数据采集时间、传输完成时间和目标系统可见时间,避免仅以任务启动时间判断同步是否及时。
在实施层面,可以根据数据时效要求选择定时批处理、增量采集、消息触发或实时同步方式,并配套任务监控、超时告警、失败重试和补数机制。架构设计的目标不是一味追求实时,而是在业务时限、系统负载和实施成本之间取得平衡。
五、唯一性:是否存在重复记录或重复业务对象
唯一性关注同一业务对象是否被重复创建或重复记录。常见问题包括客户重复建档、同一供应商存在多个编码、重复导入交易流水,以及接口重试导致重复创建业务单据。重复数据不仅影响统计结果,还可能引发重复通知、重复付款或重复履约等业务风险。
常用指标包括重复记录率、主键冲突数、疑似重复对象数和去重后合并率。判断重复不能只依赖名称完全相同:同一企业可能存在简称、历史名称和不同地址;反过来,名称相同的两个主体也未必是同一对象。
治理时通常需要组合使用业务主键、证件或统一编码、字段标准化、匹配规则和人工复核。对确认为同一对象的记录,应明确保留哪条作为权威记录、如何合并关联关系,以及合并后如何通知下游系统。
六、有效性:数据是否符合约定的格式和业务规则
有效性衡量数据是否满足预先定义的类型、格式、范围、枚举值和业务约束。例如日期是否可解析、手机号是否符合约定格式、订单状态是否属于允许值、结束日期是否晚于开始日期、折扣率是否落在业务许可区间。
可以通过规则命中率、规则校验通过率、无效值数量和规则覆盖率来衡量。规则既可以是简单的非空、正则表达式和数值范围检查,也可以是跨字段约束或结合业务状态的复杂校验。
规则制定需要兼顾严格性与业务弹性。若规则长期无人维护,业务变化后就可能把合法数据误判为异常。因此,规则应有责任人、版本、适用范围、生效时间和变更记录,并定期复核误报与漏报。
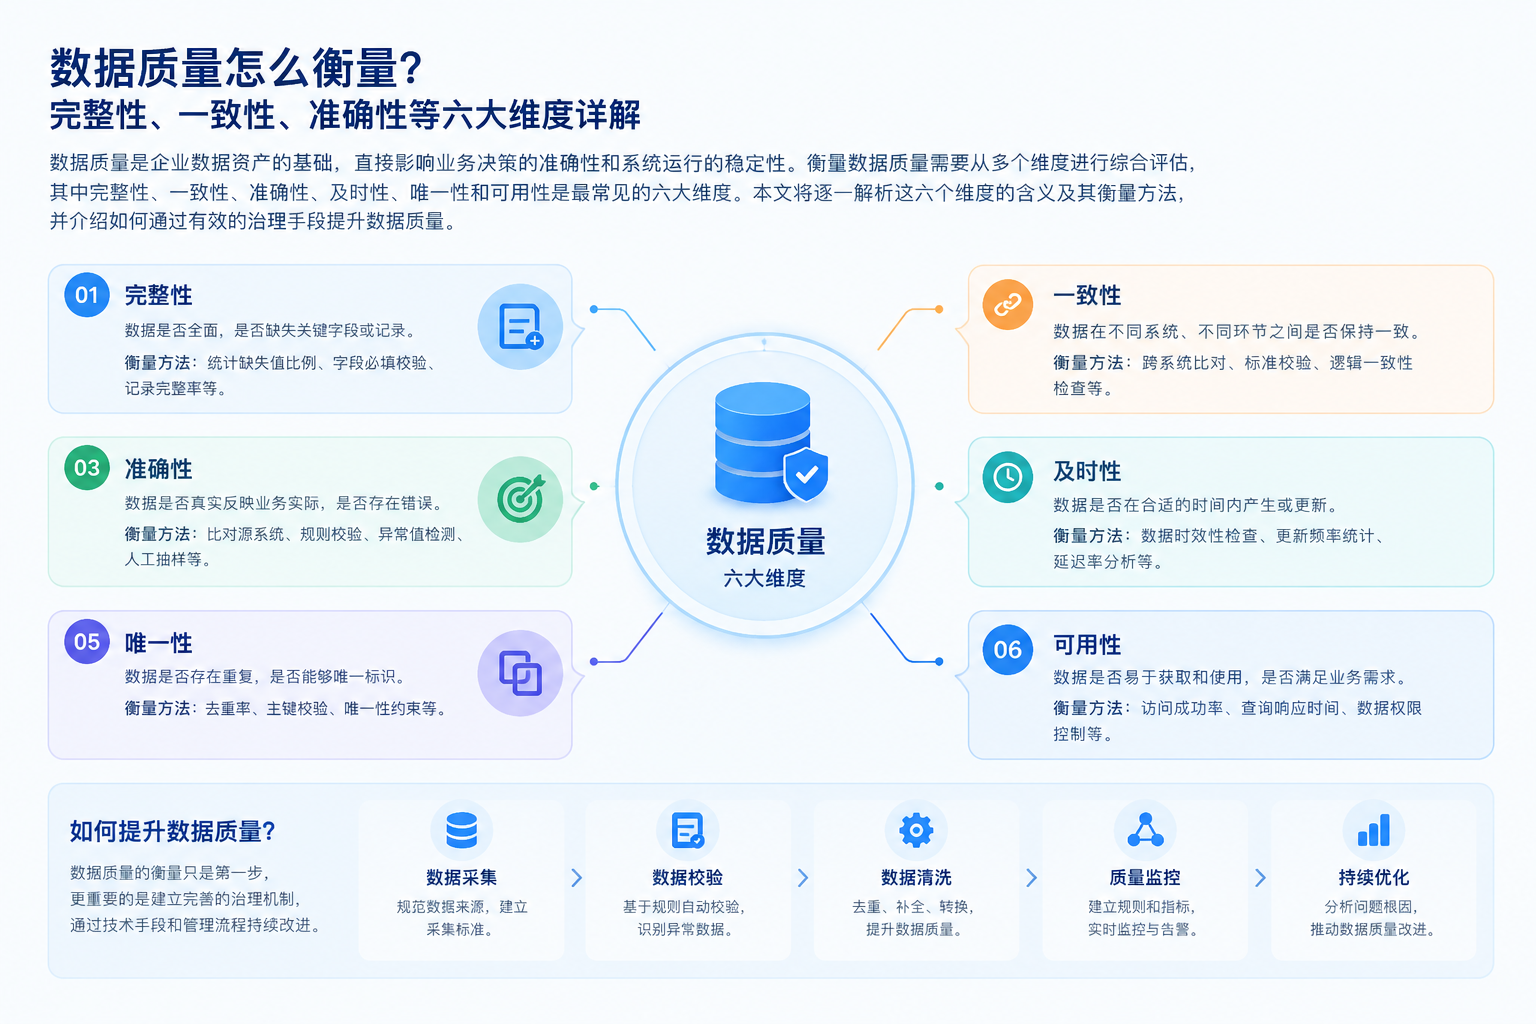
如何把六个维度转化为可执行的治理机制
第一步是确定关键数据对象和质量目标。企业不必一开始覆盖所有数据,可优先选择客户、供应商、物料、订单、库存、财务等影响核心流程的数据。第二步是定义规则和阈值,明确指标口径、检查频率、责任部门以及异常等级。第三步是将规则放入数据产生、传输和使用的链路中,在采集、转换、入库或跨系统同步环节执行检查。第四步是形成异常处理闭环,包括发现、告警、定位、整改、复核和规则优化。
数据质量平台或数据集成工具的价值,在于把分散在脚本、人工表格和临时核对中的规则统一管理,并将检测结果与任务日志、数据血缘和责任流程关联起来。对于跨系统场景,还应检查源端与目标端的数据量、关键字段映射和异常记录,避免数据虽然成功传输,却在转换过程中发生丢失或偏差。
最后,数据质量指标应与业务风险挂钩,而不是单纯追求一个漂亮的百分比。对报表展示类字段,可以允许一定比例的延迟或缺失;对支付、库存和合规字段,则需要更严格的阈值和处理策略。只有当指标能指导责任人采取行动,数据质量衡量才真正从统计报表走向治理能力。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70005218/viewspace-3186560/ ,如需转载,请注明出处,否则将追究法律责任。

