技术社区里每隔一段时间就会爆发一轮“全量同步和增量同步哪个好”的争论,而争论双方往往各自面对的是完全不同的数据特征。事实上,全量、批量增量、CDC(变更数据捕获)三种方式没有优劣之分,只有适用边界之别——决定边界的不是工具,而是两个问题:这张表的数据变化有多频繁?业务对时效的要求是什么量级?
把这两个问题问清楚,选择通常是自明的。难点在于很多团队没有把决策显性化,导致同一张表今天用全量、明天换增量、出了问题又退回全量,来回摇摆的成本全部转嫁给了运维。本文的目标是把选择变成一棵可以执行的决策树。
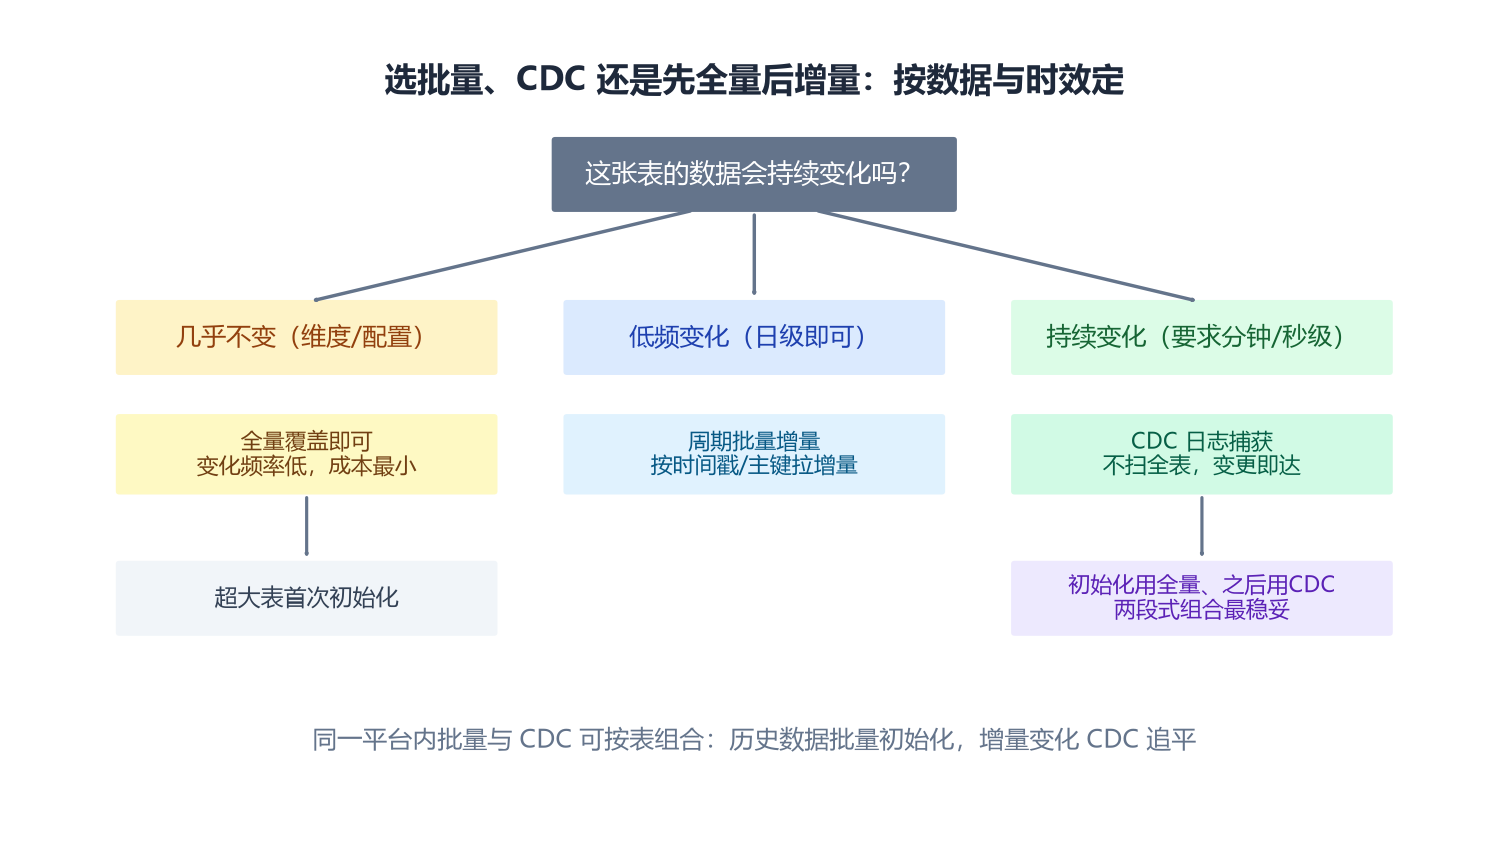
图1:按数据变化频率与时效要求定同步方式
全量同步:最简单,也最容易被滥用
每次同步整表覆盖。优点是逻辑简单、天然保证最终一致;代价是与数据量成正比的传输与写入开销,以及对源库的周期性压力。适合维度表、配置表这类“量不大、变化少”的表——用在小时级的亿级大表上就是灾难。
批量增量:按周期追平变化
依据更新时间戳或主键水位,每个周期只拉取变化部分。代价低、逻辑可控,但时效受调度周期限制(最快也是分钟到小时级),且依赖源表有可靠的变化标记字段——没有标记字段的表做增量,天然有漏数风险。
CDC日志捕获:变更即达
解析数据库日志捕获增、删、改,不扫全表、不依赖业务表加字段,延迟可以做到秒级。代价是对数据库日志权限和解析能力有要求——不同数据库的日志结构差异大,国产库(达梦、人大金仓、OceanBase等)尤其需要逐库核实平台是否支持其日志解析。以ETLCloud为例,CDC链路已支持主流国产库的日志捕获,但落地前仍建议逐库实测。
|
方式 |
时效 |
对源库压力 |
前置条件 |
典型场景 |
|
全量覆盖 |
=调度周期 |
高(与数据量成正比) |
无 |
维度表、配置表、小表 |
|
批量增量 |
分钟~小时级 |
低 |
可靠的变化标记字段 |
日结报表、准实时汇总 |
|
CDC捕获 |
秒级 |
低(读日志) |
日志权限+平台解析能力 |
实时看板、风控、对账 |
第一步:按变化频率分档
几乎不变的表(维度、配置)→全量覆盖即可,不要为它们引入CDC的复杂度;日级时效够用的表→批量增量,前提是源表有变化标记字段;要求分钟级甚至秒级的表→CDC。
第二步:表用两段式组合
需要实时同步的表通常也是大表,第一次上线时不可能用CDC“从零追平”历史数据。标准做法是全量初始化+CDC追平:先做一次全量,记录水位点,再从水位点启动CDC持续追平。ETLCloud这类平台支持批量与CDC在同一平台内按表组合,历史数据批量初始化、增量变化CDC接管,一条链路内完成交接。
第三步:水位交接是一致性的生死线
两段式最容易翻车的位置是交接点:全量结束到CDC启动之间的变化如果没人管,就漏数;水位标记不精确,就重复。落地要点:初始化完成后先做一次行数与关键字段比对,确认水位无重叠后正式切换;切换后前几个周期保持新旧链路并行对账。
决策框架本身与工具无关,但落地成本与工具强相关。如果批量与CDC分属两套工具,两段式组合就要跨系统交接水位,一致性风险和运维成本都会放大;而在ETLCloud这类集批量、CDC、调度监控为一体的平台里,交接在同一个任务体系内完成,告警与对账也能挂在同一处。选型时把“同步方式能否按表自由组合”作为考察项,能让决策框架的落地成本显著降低。
CDC热度持续走高,容易造成“全量同步将被淘汰”的错觉。真实的趋势是分工更精细:实时链路覆盖持续变化的业务数据,全量覆盖继续承担维度配置类数据和周期性校准(很多成熟架构会保留周期性全量重跑作为对账与纠偏手段)。未来更可能出现的形态是一张表多种方式按生命周期组合——初始化用全量、日常用CDC、月度用全量校准——这对平台的“多方式统一管理”能力提出了更高要求。
某电商企业需要把亿级订单表实时同步到分析库支撑实时大屏。落地采用两段式:夜间用ETLCloud批量通道完成全量初始化(约3小时),完成后比对源目标行数与当日金额合计,确认一致后以完成时刻为水位启动CDC;此后订单表的增删改在秒级到达分析库。为防漂移,保留了每日凌晨一次的批量增量对账任务,发现差异自动告警。上线三个月,大屏延迟稳定在秒级,未发生一次数据漂移事故——关键正是水位交接与持续对账这两道保险。
同步方式的选择没有立场,只有匹配:全量适合小而稳的表,批量增量适合日级时效且有变化标记的表,CDC适合持续变化且要求秒级的表;大表实时化的标准姿势是“全量初始化+CDC追平”的两段式。三个落地要点决定成败:变化标记字段是否存在、水位交接是否精确、并行对账是否坚持。把决策树贴在团队墙上,让每张新表接入时都走一遍——同步方式从“个人经验”变成“团队决策”,摇摆和事故都会大幅减少。
- 决策两问:变化频率、时效要求;
- 两段式组合:全量初始化+CDC追平,水位交接是一致性生死线;
- CDC对国产库的支持要逐库实测;
- 保留周期性对账任务,作为实时链路的纠偏保险。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70005218/viewspace-3188903/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- RestCloud iPaaS新版发布|灵活编排、可信认证、高效运维,夯实iPaaS集成底座能力
- ETL工具不是越换越好:三类链路不值得换,四类必须换(附12项自查清单)
- Kettle还能用多久?2026年数据集成工具的迁移路线图
- MES报工、ERP结账、WMS出入库对不上?制造业数据统一的四个卡点与解法
- DataX只能搬数据、做不了转换?三种混合架构方案
- 数据湖、数据中台、湖仓一体之后,企业数据底座的下一层在哪里
- Kettle还香吗?2026年国产ETL工具选型:从离线同步到CDC实时集成
- 读懂企业数据集成:四种主流接入方式的落地逻辑与选型指南
- 数据质量基础规则落地体系:必填、唯一、格式、时效的分层校验与闭环治理
- 主数据管理(MDM)是什么?与业务数据、交易数据有何区别
