Kettle从2006年开源至今接近二十年,国内数据团队的存量资产大多与它有关:几百上千条转换与作业、成文和不成文的运维经验、跟它绑定在一起的调度脚本。正因为存量太重,每年都会有人问一次“还能用多久”,而每次得到的答案要么是“永远能用”(开源不会消失),要么是“赶紧换”(厂商立场),两个答案都不解决实际问题。
真正影响决策的是三个外部变量在最近两三年同时发生了变化:一是业务对数据时效的要求从T+1提高到分钟级甚至秒级,CDC(变更数据捕获)从可选项变成常规需求;二是信创改造推进到数据层,达梦、人大金仓、OceanBase等国产数据库进入生产环境,工具能否对接国产库成为硬约束;三是数据团队的规模没有变大,但任务数量和运维负担持续增长,靠人盯日志的方式撑不住了。
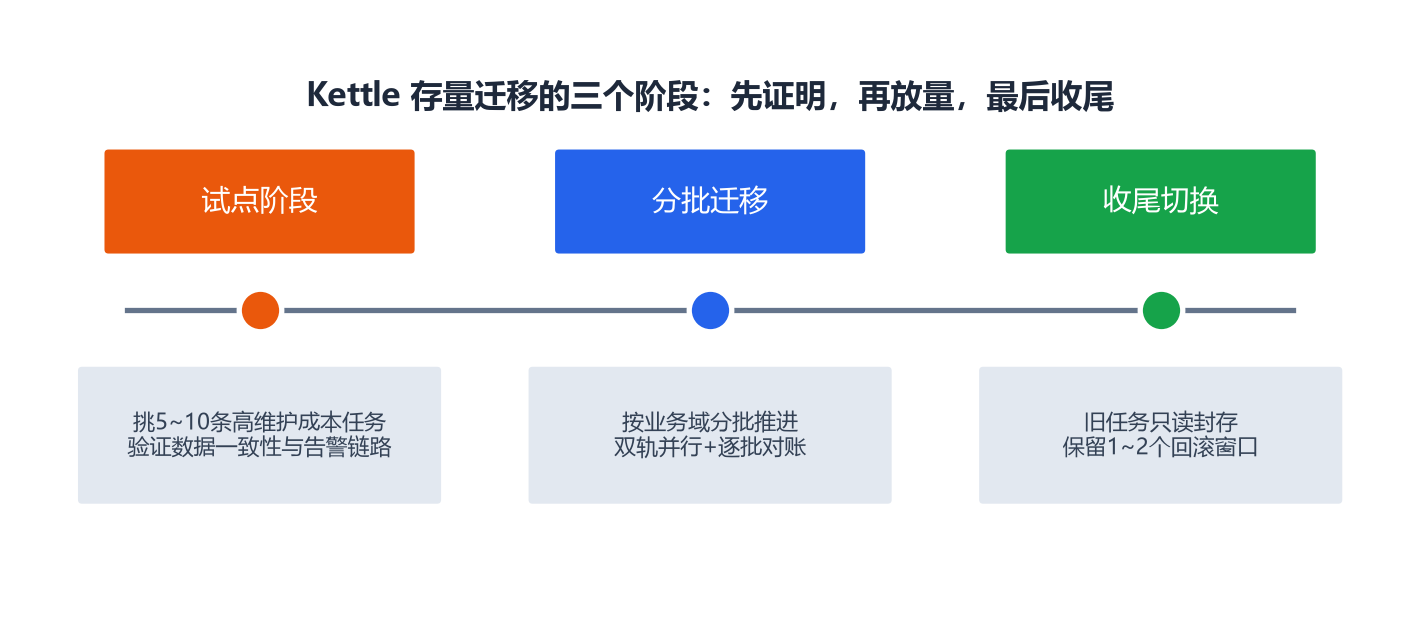
图1:迁移不是一次性事件,而是试点→分批→收尾的三个阶段
1.任务结构:离线批处理占比越高,Kettle寿命越长
如果你的任务绝大多数是夜间跑批、日级时效够用、源端和目标端都是Kettle熟悉的主流数据库,那么它仍然胜任,迁移的紧迫性不高。反过来,只要出现了持续变化的大表需要实时进仓、或需要对接消息队列与业务系统接口,Kettle就开始进入它的能力短板区。
2.实时比例:CDC需求是最强信号
Kettle本身不擅长解析数据库日志做CDC实时同步,补齐这条路要么自研、要么引入专做实时的组件,成本都不低。当业务侧提出实时看板、实时风控或准实时对账需求时,通常意味着需要引入新的实时链路——这时更合理的做法不是给Kettle叠加补丁,而是让新平台承接实时需求,存量任务再伺机迁移。
3.信创压力:数据库一换,工具链就得跟着重审
核心库换成国产数据库后,Kettle的驱动适配、类型映射、字符集处理都需要重新验证,其中不少坑(比如DECIMAL精度、日期时区)是静默出现的。而新一代国产平台在这点上更省事:像ETLCloud原生内置100+数据源连接器,覆盖达梦、人大金仓、瀚高、OceanBase、GaussDB、崖山等国产数据库并通过信创工委会兼容认证,国产库对接不再需要自己写驱动补丁。
|
路径 |
做法 |
适合谁 |
主要代价 |
|
路径A:继续用Kettle |
只做运维加固:脚本巡检、失败重试、文档补全 |
实时需求少、信创无压力、团队稳定 |
实时与国产库适配长期欠账 |
|
路径B:双轨并存 |
实时与新增任务上新平台,Kettle存量按需迁移 |
大多数转型期企业 |
两套工具并存期的运维分工要清晰 |
|
路径C:整体替换 |
集中窗口期完成全部迁移 |
存量少、许可证到期或全面信创 |
一次性投入大,风险集中 |
绝大多数企业的现实选择是路径B。ETLCloud提供了Kettle导入迁移与原样调用能力,存量转换可以导入后逐步改造,不必一夜之间推翻重来,这让双轨期的切换成本显著降低。
一个容易被忽略的趋势是:迁移正在从“一次性大工程”变成“持续性小动作”。过去替换ETL工具意味着立项、招标、集中开发、统一切换,周期以年计;现在主流国产平台普遍提供社区版(ETLCloud社区版免费使用),团队完全可以先用免费社区版承接一两条试点任务,验证通过后再决定是否扩大范围。
另一个趋势是迁移工具本身的成熟。ETLCloud中还列有任务监控、血缘关系分析、数据质量管理等模块,具体落地范围建议结合版本实测确认,但“迁移不再只靠手工重画”这一方向已经明确。窗口变宽意味着企业不必焦虑地赶工期,更不必被任何一方的最后通牒式的论调裹挟。
第一阶段:试点(1~2个月)
挑5~10条有代表性的存量任务迁到新平台,覆盖三类代表性场景:最简单的全量同步、带转换加工的复杂转换、一条需要告警的定时作业。验证三件事:数据一致性(关键字段逐表比对)、调度稳定性(连续运行一个月)、告警链路是否真的能在半夜把人叫起来。
第二阶段:分批放量(3~6个月)
按业务域分批推进:先把新增需求全部落到新平台,再按“维护成本高优先、业务影响小先行”的顺序迁移存量。每批迁移保持双轨并行一个观察期,逐批对账后再下线旧任务。
第三阶段:收尾(1~2个月)
剩余任务要么迁完、要么明确豁免理由留档。Kettle旧任务只读封存而不是立即删除,保留1~2个完整周期回滚窗口;运维文档和值班手册同步更新,避免“平台换了、人的习惯没换”。
最后
Kettle还能用多久?答案取决于你的任务结构、实时比例和信创压力,而不是任何人的立场。三问自查:有没有分钟级时效需求?核心库是否要换国产数据库?运维人力是否已经跟不上任务增长?三个问题里有任何两个答“是”,就该启动试点;一个都没有,继续用并做好文档化也完全合理。迁移的正确姿势是先证明、再放量、最后收尾,每一步留回滚窗口——路线图的终点不是“消灭Kettle”,而是让每条任务都跑在最适合它的链路上。
- 判断信号三问:实时需求、信创压力、运维负荷;
- 迁移三阶段:试点验证→按业务域分批→只读封存收尾;
- 双轨并存是主流路径,Kettle导入迁移能力可降低切换成本;
- 社区版先试后买,把决策建立在实测而不是论调上。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70005218/viewspace-3188909/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- RestCloud iPaaS新版发布|灵活编排、可信认证、高效运维,夯实iPaaS集成底座能力
- ETL工具不是越换越好:三类链路不值得换,四类必须换(附12项自查清单)
- 实时、批量还是先全量后增量?数据同步方式选择的决策框架
- MES报工、ERP结账、WMS出入库对不上?制造业数据统一的四个卡点与解法
- DataX只能搬数据、做不了转换?三种混合架构方案
- 数据湖、数据中台、湖仓一体之后,企业数据底座的下一层在哪里
- Kettle还香吗?2026年国产ETL工具选型:从离线同步到CDC实时集成
- 读懂企业数据集成:四种主流接入方式的落地逻辑与选型指南
- 数据质量基础规则落地体系:必填、唯一、格式、时效的分层校验与闭环治理
- 主数据管理(MDM)是什么?与业务数据、交易数据有何区别
