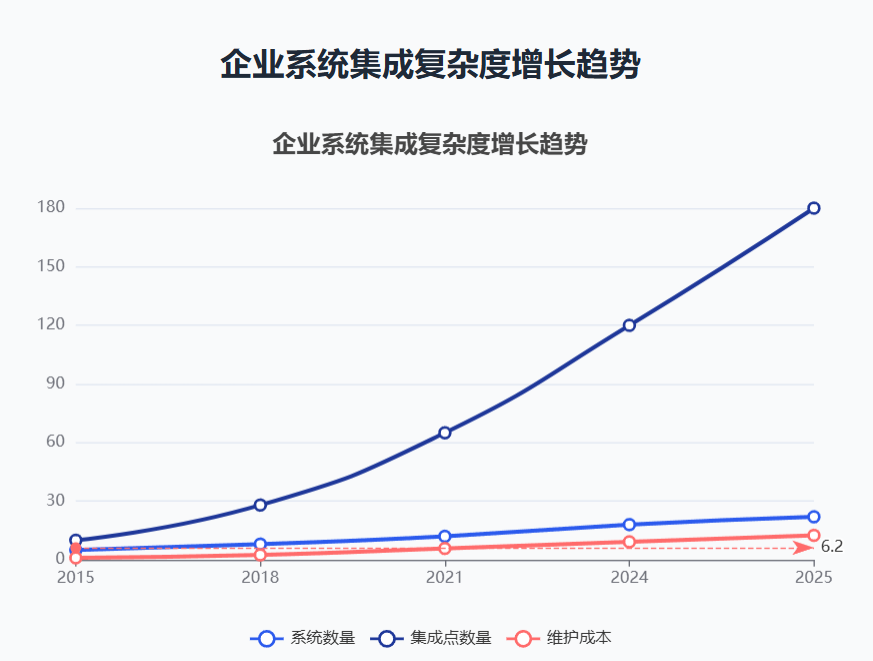
上个月,一家零售集团的IT部门在升级订单系统时遇到严重数据延迟:夜间批处理任务耗时从 2 小时激增到 7 小时,导致库存同步失败、客户订单发货延迟。
许多企业厂家也经常反映一个问题:为什么自己的数据集成越来越慢?
导致这一系列问题的根源究竟是什么?答案便是——
现有ETL工具
已经无法满足实时数据同步需求。
本文面向 企业IT负责人、数据架构师、后端开发工程师,为您全面梳理
2025年市面上主流ETL工具的功能、场景与优劣势,帮助你快速选型、避免踩坑。
在讲解之前,我们先给出结论:
ETL早已进化为覆盖实时流处理、数据治理和云原生部署的数据集成平台。而这一切的机理是什么?别急,我们慢慢来分析。
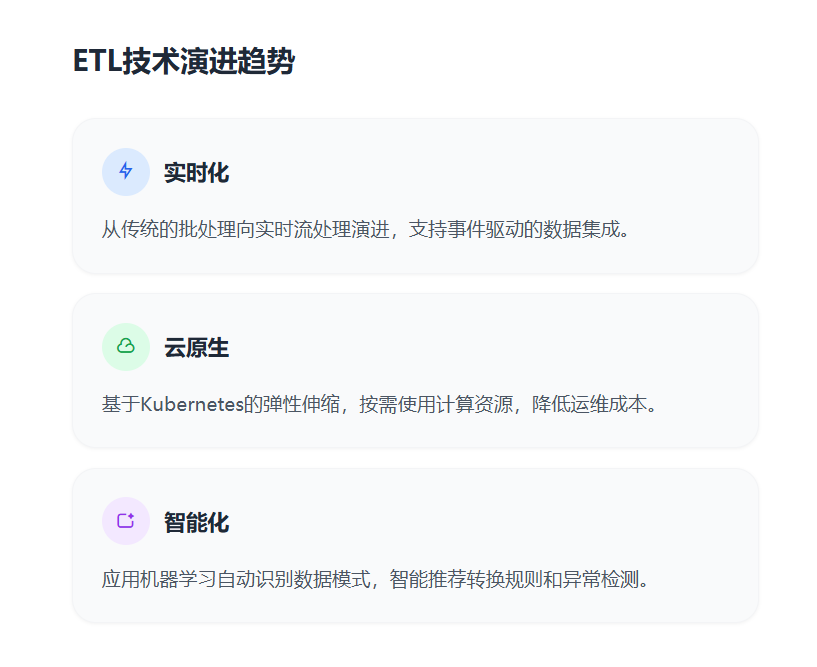
传统ETL以批处理为主(如每晚跑一次),擅长结构化数据。然而,随着技术发展,现代ETL / ELT发展出了更多高级的功能,比如支持流式处理、云原生架构、自动扩展等,同时还具备数据血缘追踪和API编排能力。
传统“抽取-转换-加载”功能的ETL工具已经无法满足企业的需求,企业急需功能更完善、先进的ETL工具。
企业在进行ETL工具选型时需要明确的一个核心事实便是:
没有一应俱全的ETL,只有更匹配的工具。接下来我们将为您列举几个具体的ETL工具选型场景,方便您更好地理解。
优选:Informatica PowerCenter、IBM DataStage
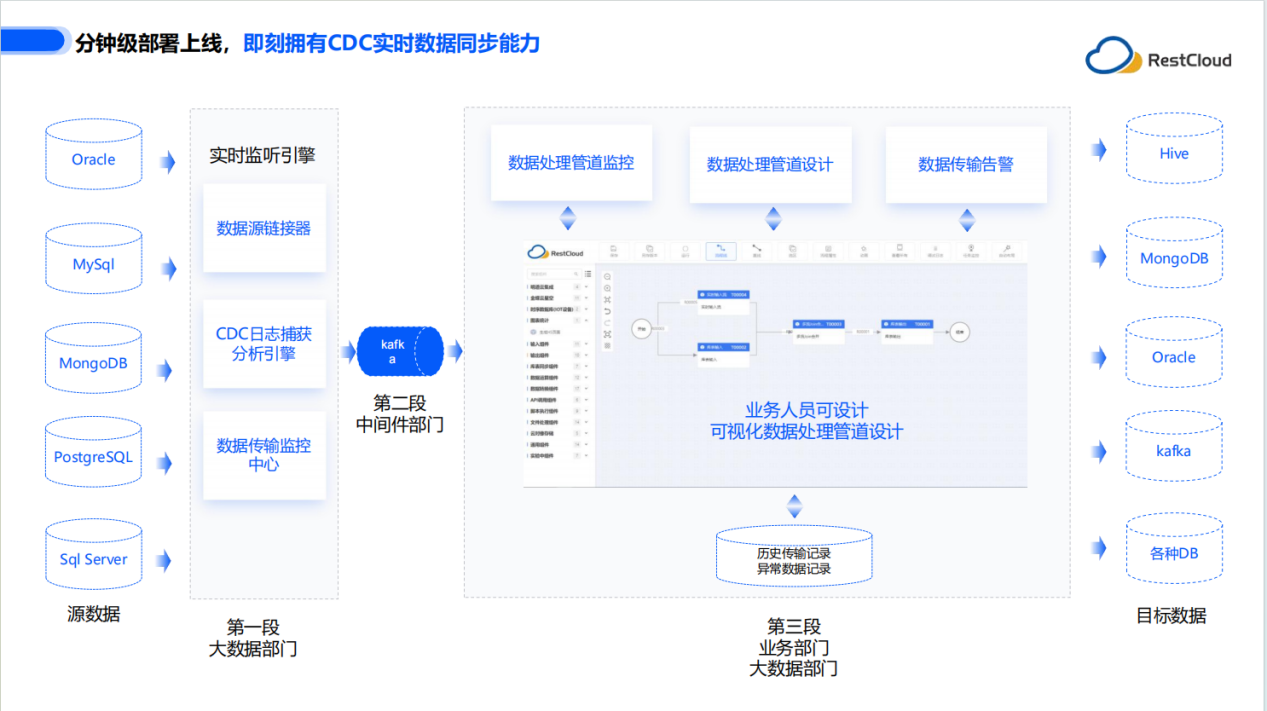
优选:Apache Kafka + Kafka Connect、Debezium、RestCloud ETLCloud
原因:原生支持CDC(Change Data Capture),适合动态数据管道
优选:Fivetran、Airbyte、AWS Glue
原因:免维护、弹性扩展,适合快速上线,但深度定制能力有限
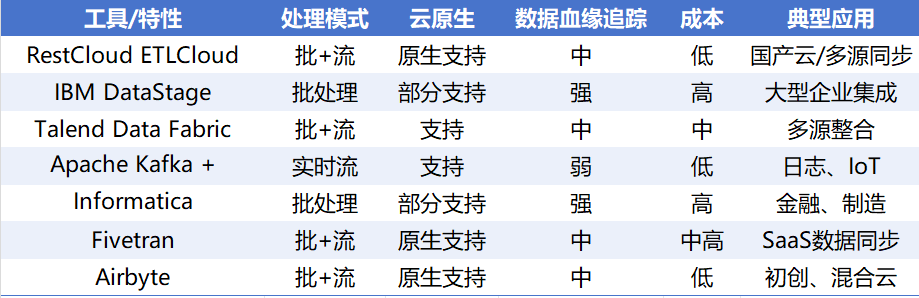
我们准备了一张表格,帮助您清晰的对比这几款不同的ETL工具:
-
实时 vs 批处理
-
成本控制 vs 灵活扩展
-
合规审计 vs 快速上线
-
数据源兼容性(≥80%自动化适配)
-
运维成本(人力投入 vs SaaS模式)
-
社区活跃度或厂商支持力度
-
在核心数据流上跑一次端到端测试
-
重点观察延迟、错误率、资源占用
-
验证后再大规模迁移
云原生与实时处理是ETL领域当下不可避免的发展趋势,但传统ETL在部分关键行业仍占据着不可替代的地位。
因此,企业在选型的过程中必须综合权衡产品的成本、合规、扩展性。要回归业务价值,而非一味的工具堆砌。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70005218/viewspace-3093398/
,如需转载,请注明出处,否则将追究法律责任。