数据仓库建设之数仓架构
不管是离线数仓与实时数仓,建设的时候都少不了架构设计,今天来学习一下常见的架构及发展演变过程。
数仓(Data Warehouse)是指一个用于集成和管理大量数据的系统,旨在支持企业的决策制定和分析业务需求。它是一个经过优化设计的数据库,用于存储历史和当前的业务数据,为企业提供一个可靠、安全、稳定的数据源,以支持管理和决策制定。数仓通常由数据提取、转换、加载(ETL)和数据存储等组成,支持在线分析处理(OLAP)和可视化分析工具的使用。
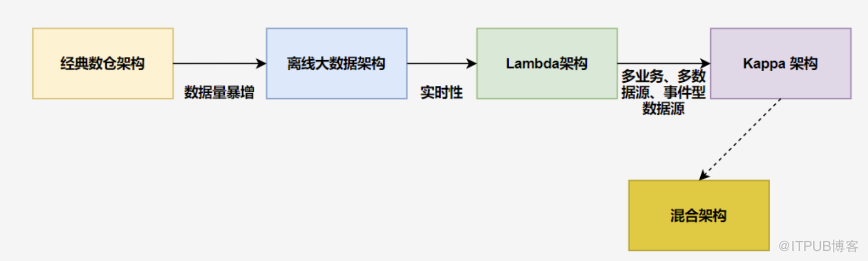
数仓设计是指将数据从各个不同的数据源、不同的格式和不同的系统中提取、转换、清洗并存储到一个中心化的数据仓库中,以支持数据分析和决策制定。一个好的数仓设计需要考虑到以下几个方面:
1. 数据源的选择:需要选择与业务相关的数据源,确保数据的完整性、准确性和一致性。
2. 数据的提取:通过ETL(提取、转换、加载)工具从数据源中提取数据,并对数据进行转换和清洗,确保数据可用于分析。
3. 数据的存储:将处理后的数据存储到数据仓库中,通常使用关系型数据库或非关系型数据库,以便于后续数据分析和挖掘。
4. 数据的维护和更新:数仓设计需要考虑数据的更新和维护,确保数据的及时性和准确性,同时需要考虑数据的备份和恢复。
5. 数据分析和可视化:设计出易于分析和可视化的数据模型和报表,以便用户可以更好地理解和利用数据,支持决策制定。
综上所述,数仓设计是一个复杂的过程,需要综合考虑多个因素,才能设计出高效、可靠和易于维护的数仓系统。
一、离线数仓大数据架构
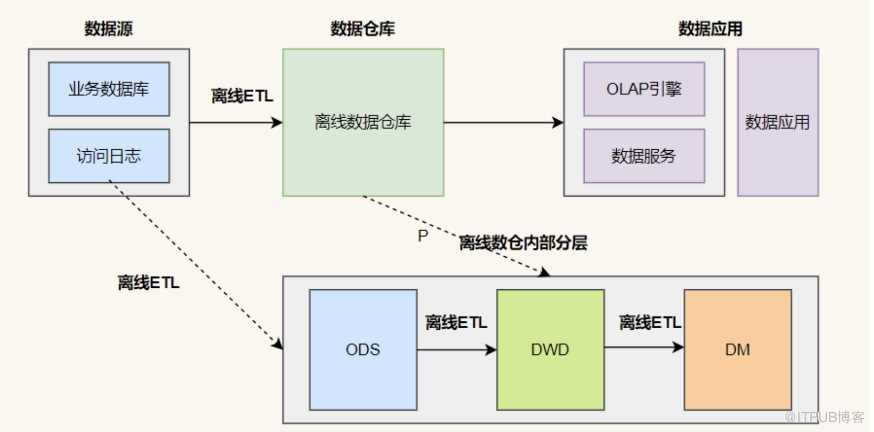
下面详细说明图中的各个组件及其所起的作用。
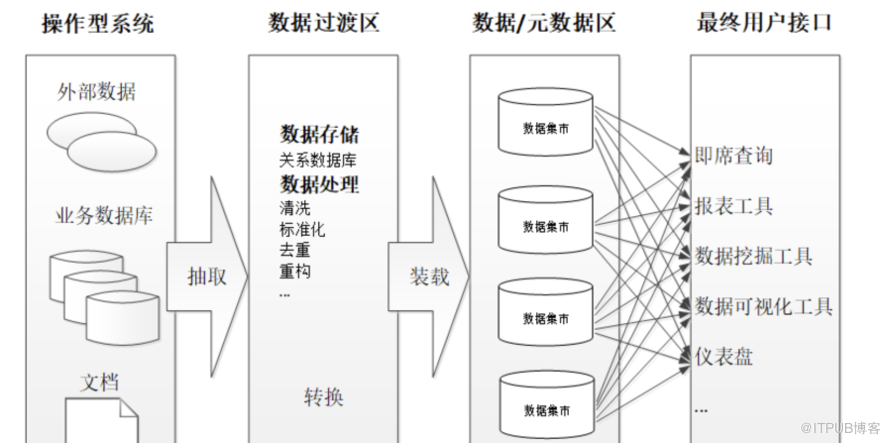
图中显示的整个数据仓库环境包括操作型系统和数据仓库系统两大部分。ETL过程分成了抽取和转换装载两个部分。抽取过程负责从操作型系统获取数据,该过程一般不做数据聚合和汇总,但是会按照主题进行集成,物理上是将操作型系统的数据全量或增量复制到数据仓库系统的RDS中。转换、装载过程将对数据进行清洗、过滤、汇总、统一格式化等一系列转换操作,使数据转为适合查询的格式,然后装载进数据仓库系统的TDS中。传统数据仓库的基本模式是用一些过程将操作型系统的数据抽取到文件,然后另一些过程将这些文件转化成MySQL或Oracle这样的关系数据库的记录。最后,第三部分过程负责把数据导入进数据仓库。
RDS(RAW DATA STORES)是原始数据存储的意思。将原始数据保存到数据仓库里是个不错的想法。ETL过程的bug或系统中的其它错误是不可避免的,保留原始数据使得追踪并修改这些错误成为可能。有时数据仓库的用户会有查询细节数据的需求,这些细节数据的粒度与操作型系统的相同。有了RDS,这种需求就很容易实现,用户可以查询RDS里的数据而不必影响业务系统的正常运行。这里的RDS实际上是起到了操作型数据存储(Operational Data Store,ODS)的作用,关于ODS相关内容本小节后面会有详细论述。
TDS(TRANSFORMED DATA STORES)意为转换后的数据存储。这是真正的数据仓库中的数据。大量的用户会在经过转换的数据集上处理他们的日常查询。如果前面的工作做得好,这些数据将被以保证最重要的和最频繁的查询能够快速执行的方式构建。
这里的原始数据存储和转换后的数据存储是逻辑概念,它们可能物理存储在一起,也可能分开。当原始数据存储和转换后的数据存储物理上分开时,它们不必使用同样的软硬件。传统数据仓库中,原始数据存储通常是本地文件系统,原始数据被组织进相应的目录中,这些目录是基于数据从哪里抽取或何时抽取建立(例如以日期作为文件或目录名称的一部分);转换后的数据存储一般是某种关系数据库。
自动化调度组件的作用是自动定期重复执行ETL过程。不同角色的数据仓库用户对数据的更新频率要求也会有所不同,财务主管需要每月的营收汇总报告,而销售人员想看到每天的产品销售数据。作为通用的需求,所有数据仓库系统都应该能够建立周期性自动执行的工作流作业。传统数据仓库一般利用操作系统自带的调度功能(如Linux的cron或Windows的计划任务)实现作业自动执行。
数据目录有时也被称为元数据存储,它可以提供一份数据仓库中数据的清单。用户通过它应该可以快速解决这些问题:什么类型的数据被存储在哪里,数据集的构建有何区别,数据最后的访问或更新时间等。此外还可以通过数据目录感知数据是如何被操作和转换的。一个好的数据目录是让用户体验到系统易用性的关键。
查询引擎组件负责实际执行用户查询。传统数据仓库中,它可能是存储转换后数据的Oracle、MySQL等关系数据库系统内置的查询引擎,还可能是以固定时间间隔向其导入数据的OLAP立方体,如Essbase cube。
用户界面指的是最终用户所使用的接口程序。可能是一个GUI软件,如BI套件的中的客户端软件,也可能就是一个浏览器。
2.
数据集市
架构
数据集市是按主题域组织的数据集合,用于支持部门级的决策。有两种类型的数据集市:独立数据集市和从属数据集市。
数据集市是按主题域组织的数据集合,用于支持部门级的决策。有两种类型的数据集市:独立数据集市和从属数据集市。
独立数据集市集中于部门所关心的单一主题域,数据以部门为基础部署,无需考虑企业级别的信息共享与集成。
应用系统:这些应用是组织中的操作型系统,用来支撑业务。它们收集业务处理过程中产生的销售、市场、材料、物流等数据,并将数据以多种形式进行存储。操作型系统也叫源系统,为数据仓库提供数据。
ETL过程:ETL过程从操作型系统抽取数据,然后将数据转换成一种标准形式,最终将转换后的数据装载到企业级数据仓库中。ETL是周期性运行的批处理过程。
企业级数据仓库:是该架构中的核心组件。正如Inmon数据仓库所定义的,企业级数据仓库是一个细节数据的集成资源库。其中的数据以最低粒度级别被捕获,存储在满足三范式设计的关系数据库中。
部门级数据集市:是面向主题数据的部门级视图,数据从企业级数据仓库获取。数据在进入部门数据集市时可能进行聚合。数据集市使用多维模型设计,用于数据分析。重要的一点是,所有的报表工具、BI工具或其它数据分析应用都从数据集市查询数据,而不是直接查询企业级数据仓库。
4.Kimball数据仓库架构
Kimball与Inmon两种架构的主要区别在于核心数据仓库的设计和建立。Kimball的数据仓库包含高粒度的企业数据,使用多维模型设计,这也意味着数据仓库由星型模式的维度表和事实表构成。分析系统或报表工具可以直接访问多维数据仓库里的数据。在此架构中的数据集市也与Inmon中的不同。这里的数据集市是一个逻辑概念,只是多维数据仓库中的主题域划分,并没有自己的物理存储,也可以说是虚拟的数据集市。
二、实时数仓Lambda 架构
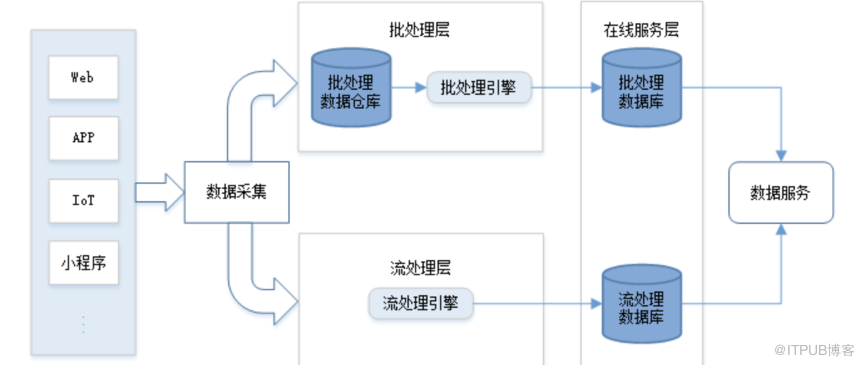
Lambda 架构总共由三层系统组成:批处理层(Batch Layer),速度处理层(Speed Layer),以及用于响应查询的服务层(Serving Layer)。
批处理层 存储管理主数据集(不可变的数据集)和预先批处理计算好的视图。
三、实时数仓Kappa 架构
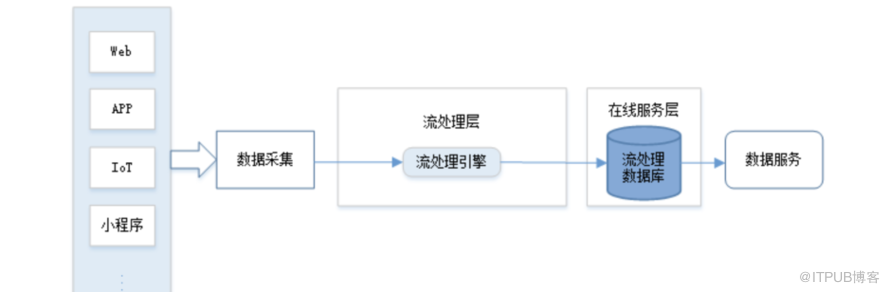
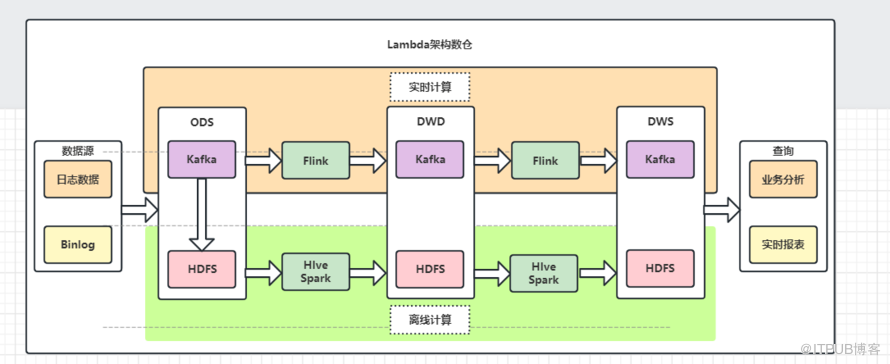
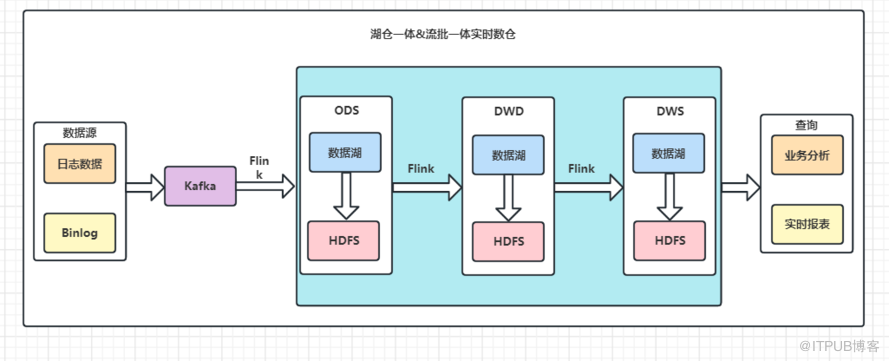
流量买卖黑产官网数据收集:
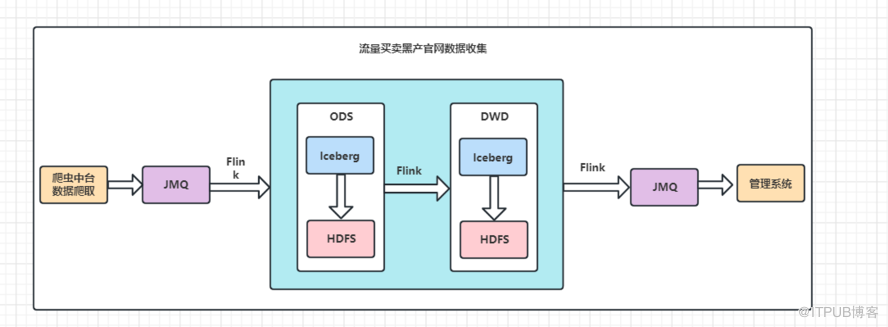
四、混合架构
参考资料:
https://blog.csdn.net/chimchim66/article/details/124268091
https://blog.csdn.net/chimchim66/article/details/124268091
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69949806/viewspace-2957405/ ,如需转载,请注明出处,否则将追究法律责任。

