-
Storm 是一个
分布式
的,可靠的,容错的数据流处理系统
storm中服务器节点分为主节点和从节点,Nimbus为主节点和
Supervisor
为从节点。以及若干组件构成。下面为对一些术语进行简单的介绍:
Nimbus:主节点,是一个调度中心,负责分发任务
Supervisor:从节点,任务执行的地方
-
Worker:任务工作进程,一个Supervisor中可以有多个Worker。
-
Executor:Worker进程在执行任务时,会启动多个Executor线程
4.
Topology:任务的抽象概念。由于storm是流式计算的框架,它的数据流和拓扑图很像,所以它的任务就叫topology。
Spout:从数据源获取数据并进行分发。
Bolt:得到Spout或者上一个Bolt的数据,然后进行处理后交给下一个Bolt处理。
Tuple:在storm中,一条数据可以理解为是一个Tuple。
二、storm的
架构
任务提交处理流程
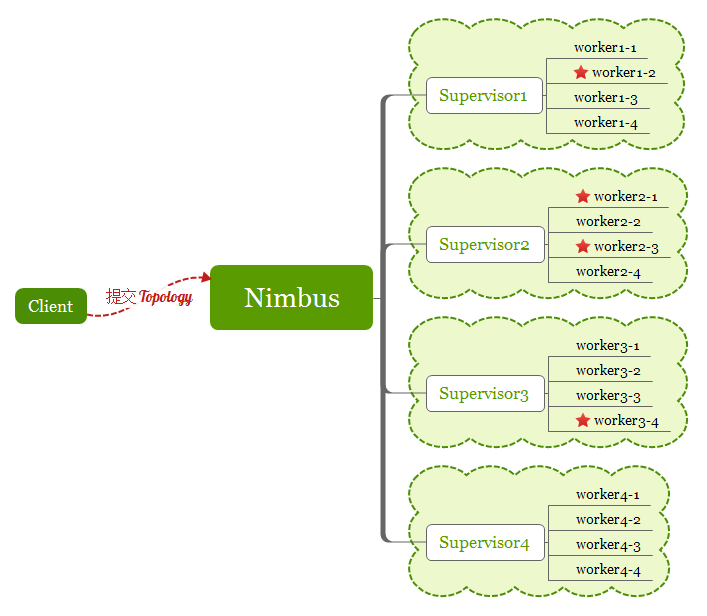
当客户端向storm集群提交一个Topology时,这里的提交就是在集群上通过命令
storm jar xxx启动topology。如果我们是在Supervisor节点上执行
storm jar xxx,那么Supervisor会将jar包拷贝到Nimbus,之后Nimbus对Topology进行调度。
Nimbus会根据Topology所需要的Worker进行分配,将其分配到各个Supervisor的节点上执行。
storm中的数据流
启动完Topology后,相关组件就开始运行起来了。在Storm中,Spout组件主要用来从数据源拉取数据,形成一个Tuple后转交给Bolt处理。Bolt接受到Tuple处理完后,可以选择继续交给下一个Bolt处理,也可以选择不往下传。这样数据以Tuple的形式一个接一个的往下执行,就形成了一个拓扑数据流。
storm数据在组件间的流向如下图所示:

三、Storm的并发度
在Storm中,Worker不是组件执行的最小单位。Executor才是,Executor可以理解为是一个线程。我们在创建topology的时候,可以设置执行spout的线程数和bolt的线程数。
假设spout和bolt的线程数加起来设置了8个,然后设置了2个worker,那么这8个线程可能就会随机分配到2个worker中,可能一个worker3个,一个worker5个。也有可能各自分配4个。如下图所示:
四、数据的Grouping策略
在实际应用中,Bolt组件的实例可能有多个,Tuple在流向Bolt时,选择哪个Bolt实例的策略就是grouping策略。
下面是Storm中的6种Grouping策略:
1. Shuffle Grouping: 随机分组, 随机派发stream里面的tuple, 保证每个bolt接收到的tuple数目相同。轮询,平均分配。
2. Fields Grouping:按字段分组, 比如按userid来分组, 具有同样userid的tuple会被分到相同的Bolts, 而不同的userid则会被分配到不同的Bolts。
3. All Grouping: 广播发送, 对于每一个tuple, 所有的Bolts都会收到。
4. Global Grouping: 全局分组, 这个tuple被分配到storm中的一个bolt的其中一个task。再具体一点就是分配给id值最低的那个task。
5. Non Grouping: 不分组, 这个分组的意思是说stream不关心到底谁会收到它的tuple。目前这种分组和Shuffle grouping是一样的效果,不平均分配。
6. Direct Grouping: 直接分组, 这是一种比较特别的分组方法,用这种分组意味着消息的发送者举鼎由消息接收者的哪个task处理这个消息。 只有被声明为Direct Stream的消息流可以声明这种分组方法。而且这种消息tuple必须使用emitDirect方法来发射。消息处理者可以通过TopologyContext来或者处理它的消息的taskid(OutputCollector.emit方法也会返回taskid)
五、消息的可靠性保证 —— ack机制
一条数据在Spout中形成一个Tuple,然后交给一个个Bolt执行,那我们怎么保证这个Tuple被完整的执行了呢?这里的完整执行说的是这个Tuple必须在后面的每一个Bolt都成功处理,假设在一个Bolt中发生异常导致失败,这就不能算完整处理。
为了保证消息处理过程中的可靠性,storm使用了ack机制。storm会专门启动若干acker线程,来追踪tuple的处理过程。acker线程数量可以设置。
每一个Tuple在Spout中生成的时候,都会分配到一个64位的messageId。通过对messageId进行哈希我们可以执行要对哪个acker线程发送消息来通知它监听这个Tuple。
acker线程收到消息后,会将发出消息的Spout和那个messageId绑定起来。然后开始跟踪该tuple的处理流程。如果这个tuple全部都处理完,那么acker线程就会调用发起这个tuple的那个spout实例的ack()方法。如果超过一定时间这个tuple还没处理完,那么acker线程就会调用对应spout的fail()方法,通知spout消息处理失败。spout组件就可以重新发送这个tuple。
六、Storm的HA保证——高可用性保证
1. 数据方面的高可用
使用ack机制保证数据处理的高可用
Supervisor会自动重启worker线程。
3. Supervisor节点失效了怎么办?
可以在其他节点重启该supervisor任务。
4. Nimbus挂了怎么办?
推荐阅读:
https://blog.csdn.net/qq_18769269/article/details/100191788
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69949806/viewspace-2905016/
,如需转载,请注明出处,否则将追究法律责任。

