介绍
ELK是Elasticsearch、Logstash、Kibana三大开源框架首字母大写简称(但是后期出现的filebeat(beats中的一种)可以用来替代logstash的数据收集功能,比较轻量级)。市面上也被成为Elastic Stack。
Filebeat
是用于转发和集中日志数据的轻量级传送工具。
Filebeat监视您指定的日志文件或位置,收集日志事件,并将它们转发到Elasticsearch或 Logstash进行索引。
Filebeat的工作方式如下:
启动Filebeat时,它将启动一个或多个输入,这些输入将在为日志数据指定的位置中查找。对于Filebeat所找到的每个日志,Filebeat都会启动收集器。每个收集器都读取单个日志以获取新内容,并将新日志数据发送到libbeat,libbeat将聚集事件,并将聚集的数据发送到为Filebeat配置的输出。
Logstash
是免费且开放的服务器端数据处理管道,能够从多个来源采集数据,转换数据,然后将数据发送到您最喜欢的“存储库”中。
Logstash能够动态地采集、转换和传输数据,不受格式或复杂度的影响。利用Grok从非结构化数据中派生出结构,从IP地址解码出地理坐标,匿名化或排除敏感字段,并简化整体处理过程。
Elasticsearch
Elastic Stack核心的分布式搜索和分析引擎,是一个基于Lucene、分布式、通过Restful方式进行交互的近实时搜索平台框架。Elasticsearch为所有类型的数据提供近乎实时的搜索和分析。无论您是结构化文本还是非结构化文本,数字数据或地理空间数据,Elasticsearch都能以支持快速搜索的方式有效地对其进行存储和索引。
Kibana
是一个针对Elasticsearch的开源分析及可视化平台,用来搜索、查看交互存储在Elasticsearch索引中的数据。使用Kibana,可以通过各种图表进行高级数据分析及展示。并且可以为 Logstash 和 ElasticSearch 提供的日志分析友好的 Web 界面,可以汇总、分析和搜索重要数据日志。还可以让海量数据更容易理解。它操作简单,基于浏览器的用户界面可以快速创建仪表板(dashboard)实时显示Elasticsearch查询动态
日志主要包括系统日志、应用程序日志和安全日志。系统运维和开发人员可以通过日志了解服务器软硬件信息、检查配置过程中的错误及错误发生的原因。经常分析日志可以了解服务器的负荷,性能安全性,从而及时采取措施纠正错误。
特征
收集
能够采集多种来源的日志数据
传输
能够稳定的把日志数据解析过滤并传输到存储系统
存储
存储日志数据
分析
支持 UI 分析
警告
能够提供错误报告,监控机制
>

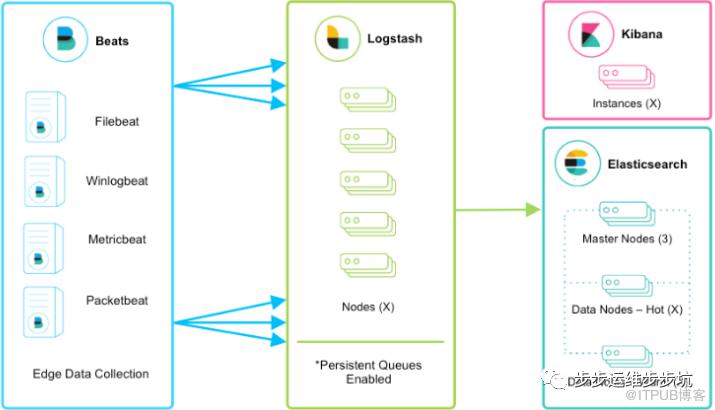
如上图所示,该ELK框架由beats(日志分析我们通常使用filebeat)+elasticsearch+kibana构成,这个框架比较简单,入门级的框架。其中filebeat也能通过module对日志进行简单的解析和索引。并查看预建的Kibana仪表板。 该框架适合简单的日志数据,一般可以用来玩玩,生产环境建议接入logstash
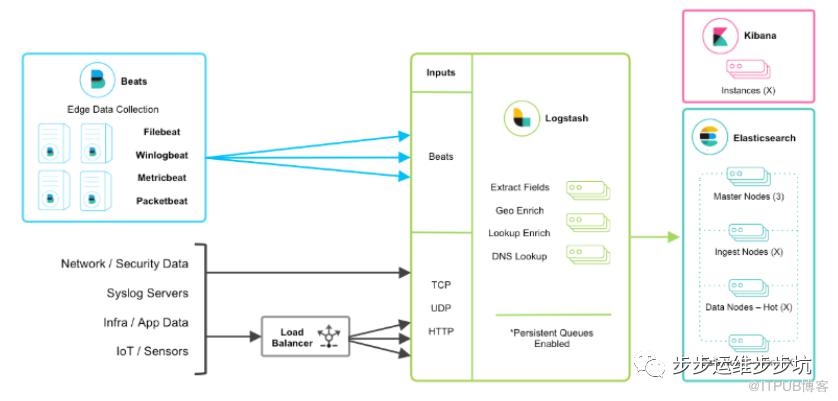
该框架是在上面的框架的基础上引入了logstash,引入logstash带来的好处如下
Logstash具有基于磁盘的自适应缓冲系统通,该系统将吸收传入的吞吐量,从而减轻背压
从其他数据源(例如数据库,S3或消息传递队列)中提取
将数据发送到多个目的地,例如S3,HDFS或写入文件
使用条件数据流逻辑组成更复杂的处理管道
filebeat结合logstash带来的优势:
1、水平可扩展性,高可用性和可变负载处理:filebeat和logstash可以实现节点之间的负载均衡,多个logstash可以实现logstash的高可用
2、消息持久性与至少一次交付保证:使用Filebeat或Winlogbeat进行日志收集时,可以保证至少一次交付。从Filebeat或Winlogbeat到Logstash以及从Logstash到Elasticsearch的两种通信协议都是同步的,并且支持确认。Logstash持久队列提供跨节点故障的保护。对于Logstash中的磁盘级弹性,确保磁盘冗余非常重要。
3、具有身份验证和有线加密的端到端安全传输:从Beats到Logstash以及从 Logstash到Elasticsearch的传输都可以使用加密方式传递 。与Elasticsearch进行通讯时,有很多安全选项,包括基本身份验证,TLS,PKI,LDAP,AD和其他自定义领域
当然在该框架的基础上还可以引入其他的输入数据的方式:比如:TCP,UDP和HTTP协议是将数据输入Logstash的常用方法(如下图所示):
在如上的基础上我们可以在beats和logstash中间添加一些组件redis、kafka、RabbitMQ等,添加中间件将会有如下好处:
第一,降低对日志所在机器的影响,这些机器上一般都部署着反向代理或应用服务,本身负载就很重了,所以尽可能的在这些机器上少做事;
第二,如果有很多台机器需要做日志收集,那么让每台机器都向Elasticsearch持续写入数据,必然会对Elasticsearch造成压力,因此需要对数据进行缓冲,同时,这样的缓冲也可以一定程度的保护数据不丢失;
第三,将日志数据的格式化与处理放到Indexer中统一做,可以在一处修改代码、部署,避免需要到多台机器上去修改配置
部署
elk各个组件的网址可以在官网下载:
官网
或者在中文社区下载:
中文社区
包下载
各个组件的网址可以在官网下载:https://www.elastic.co/cn/
中文社区下载:https://elasticsearch.cn/download/
java 环境(所有节点都需要)
链接:
百度网盘
提取码:1010
版本
7.70
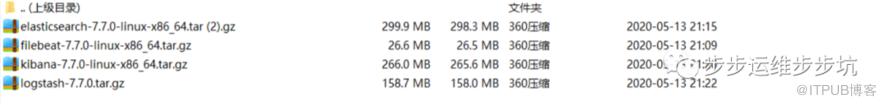
环境说明
安装步骤
java环境准备
# tar xf jdk-8u121-linux-x64.tar.gz   -C  /usr/local/jdk
# vim  /etc/profile
JAVA_HOME=/usr/local/java CLASS_PATH=.:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jar
PATH=$PATH:$JAVA_HOME/bin
export PATH JAVA_HOME CLASS_PATH

# source /etc/profile
# jave -version
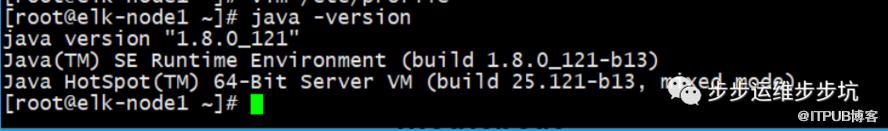
系统设置
vim /etc/security/limits.conf
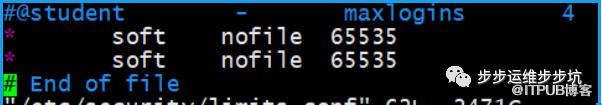
sysctl -w vm.max_map_count=262144
vim /etc/sysctl.conf
vm.max_map_count=262144
Node3
安装配置redis
# yum install epel-release -y
# yum install redis -y
修改配置文件
# vim /etc/redis.conf
bind 0.0.0.0
daemonize yes
启动和自启
# systemctl start redis
# systemctl enable redis
# systemctl status redis
安装配置nginx
# yum install nginx -y
修改日志格式为js
# vi /etc/nginx/nginx.conf
修改配置文件
user nginx;
worker_processes auto;
error_log /var/log/nginx/error.log;
pid /run/nginx.pid;
include /usr/share/nginx/modules/*.conf;
events {
worker_connections 1024;
}
http {
    include /etc/nginx/mime.types;
    default_type application/octet-stream;
    log_format main '{
        "time_local": "$time_local", '
        '"remote_addr": "$remote_addr", '
        '"remote_user": "$remote_user", '
        '"body_bytes_sent": "$body_bytes_sent", '
        '"request_time": "$request_time", '
        '"status": "$status", '
        '"host": "$host", '
        '"request": "$request", '
        '"request_method": "$request_method", '
        '"uri": "$uri", '
        '"http_referrer": "$http_referer", '
        '"http_x_forwarded_for": "$http_x_forwarded_for", '
        '"http_user_agent": "$http_user_agent" '
        '}';

    access_log /var/log/nginx/access.log main;
    sendfile on;
    keepalive_timeout 65;
    include /etc/nginx/conf.d/*.conf;
    server {
        listen 8001 ;
        listen [::]:8001;
        server_name _;
        root /usr/share/nginx/html;
        # Load configuration files for the default server block.
        include /etc/nginx/default.d/*.conf;
        location / {
    }
    error_page 404 /404.html;
    location = /40x.html {
    }
    error_page 500 502 503 504 /50x.html;
    location = /50x.html {
        }
    }
    server {
        listen 8080;
        }
}
为了使Nginx和httpd不产生冲突,把Nginx监听端口改为8001
启动和自启
# systemctl start nginx
# systemctl enable nginx
# systemctl status nginx
安装配置httpd
# yum install httpd -y
#
修改配置文件
vi /etc/httpd/conf/httpd.conf
<IfModule log_config_module>
LogFormat "{ \
    \"@timestamp\": \"%{%Y-%m-%dT%H:%M:%S%z}t\", \
    \"@version\": \"1\", \
    \"tags\":[\"apache\"], \
    \"message\": \"%h %l %u %t \\\"%r\\\" %>s %b\", \
    \"clientip\": \"%a\", \
    \"duration\": %D, \
    \"status\": %>s, \
    \"request\": \"%U%q\", \
    \"urlpath\": \"%U\", \
    \"urlquery\": \"%q\", \
    \"bytes\": %B, \
    \"method\": \"%m\", \
    \"site\": \"%{Host}i\", \
    \"referer\": \"%{Referer}i\", \
    \"useragent\": \"%{User-agent}i\" \
    }" ls_apache_json
    <IfModule logio_module>
    </IfModule>
    CustomLog "logs/access_log" ls_apache_json
    </IfModule>
    <IfModule alias_module>
启动和自启
# systemctl start httpd
# systemctl enable httpd
# systemctl status httpd
Node1 + Node2
创建用户
由于elasticsearch不能使用root用户运行,需要在node1和node2结点上创建elk用户
# useradd elk
# echo 123456 | passwd --stdin elk
node1和node2部署elasticsearch集群
上传压缩包并解压
# tar -zxvf elasticsearch-7.7.0-linux-x86_64.tar.gz -C /usr/local/es
# tar -zxvf elasticsearch-7.7.0-linux-x86_64.tar.gz -C /usr/local/es
修改node1配置文件
vi /usr/local/elasticsearch/config/elasticsearch.yml
network.host: 192.168.50.31
cluster.name: my-cluster
node.name: node1
bootstrap.memory_lock: false
http.port: 9200
discovery.seed_hosts: ["192.168.50.31","192.168.50.32"]
cluster.initial_master_nodes: ["192.168.50.31"]
node.max_local_storage_nodes: 100
http.cors.enabled: true
http.cors.allow-origin: "*"
http.cors.allow-methods: OPTIONS, HEAD, GET, POST, PUT, DELETE
http.cors.allow-headers: "X-Requested-With, Content-Type, Content-Length, X-User"
修改node2配置文件
vim /usr/local/elasticsearch/config/elasticsearch.yml
cluster.name: my-cluster
node.name: node2
bootstrap.memory_lock: false
network.host: 192.168.50.32
http.port: 9200
discovery.seed_hosts: ["192.168.50.31","192.168.50.32"]
cluster.initial_master_nodes: ["192.168.50.31"]
node.max_local_storage_nodes: 100
http.cors.enabled: true
http.cors.allow-origin: "*"
把elasticsearch的权限改为elk用户
# chown -R kawhi:kawhi /usr/local/es
# chown -R kawhi:kawhi /usr/local/es
启动
# su - elk
# cd /usr/local/es/bin
# nohup ./elasticsearch > /dev/null 2>&1
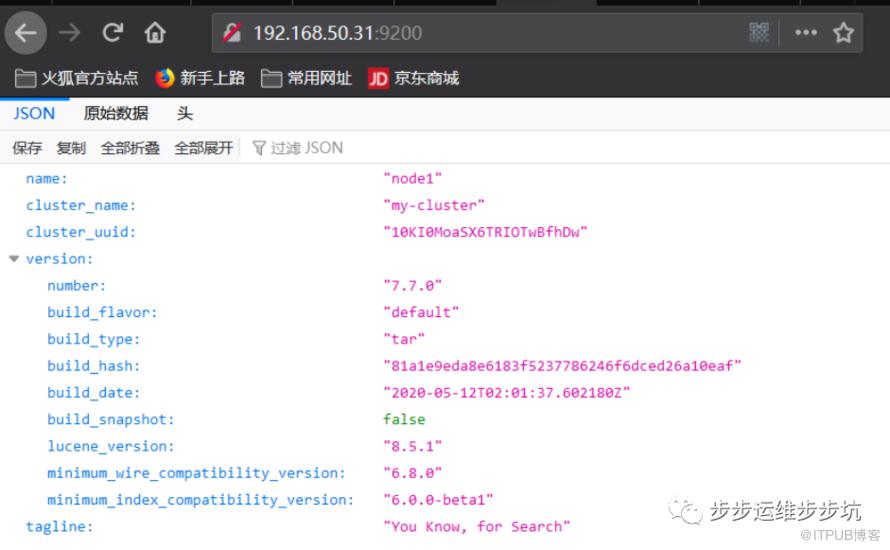
验证
访问 http://node1:9200
访问 http://node2:9200
Node1
部署elasticsearch-head-master插件
# yum install npm  git-y
# git clone git://github.com/mobz/elasticsearch-head.git
# cd /usr/local/head-master/
# cd _site
# npm install
# nohup npm run start >/dev/null 2>&1
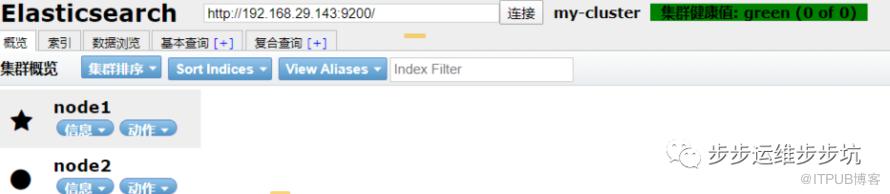
验证
访问 http://node1:9100
Node1 + Node3 部署LogStash
上传包并解压
# tar -zvxf logstash-7.7.0.tar.gz -C /usr/local/logstash
# tar -zvxf logstash-7.7.0.tar.gz -C /usr/local/logstash
#创建日志收集配置文件夹
# mkdir /usr/local/logstash/conf.d/
# mkdir /usr/local/logstash/conf.d/
配置
node1添加日志收集文件,从node3的redis数据库读取数据,存储到elasticsearch中
vi /usr/local/logstash/conf.d/redis_to_elk.conf
input {
    redis {
    port => "6379"
    host => "192.168.50.33"
    data_type => "channel"
    key => "logstash:redis"
    type => "redis-input"   }
}
output {
    elasticsearch {
    hosts => ["192.168.50.31"]
    index => "logstash-%{+YYYY.MM.dd}"
}
}
node3添加日志收集文件,把apache和nginx的日志存储到redis中
vi/usr/local/logstash/conf.d/web_to_redis.conf
input {
    file {
    path => ["/var/log/nginx/access.log"]
type => "nginx_log"
}
file {
        path => ["/etc/httpd/logs/access_log"]
    type => "apache_access_log"
}
}
output {
    redis{
    host => "192.168.50.33"
    key => 'logstash:redis'
    data_type => 'channel'
    port => '6379'
}
stdout {
    codec    => rubydebug
}
}
启动服务
node3
# cd /usr/local/logstash/bin/
# ./logstash -f /usr/local/logstash/conf.d/web_to_redis.conf &
node1
# cd /usr/local/logstash/bin/
# ./logstash -f /usr/local/logstash/conf.d/redis_to_elk.conf &
查看logstash运行情况
命令行最后输出以下语句证明启动成功
Successfully started Logstash API endpoint {:port=>9600}
node1部署 kibana
上传压缩包并解压
# tar -zxvf kibana-7.7.0-linux-x86_64.tar.gz -C /usr/local/kibana
修改配置文件
vi /usr/local/kibana/config/kibana.yml
server.host: "0.0.0.0"
elasticsearch.hosts: ["http://192.168.50.31:9200"]
i18n.locale: "zh_CN"
启动服务
# cd /usr/local/kibana/bin/
# ./kibana --allow-root &
验证
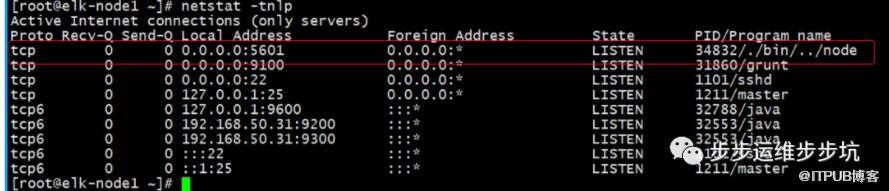
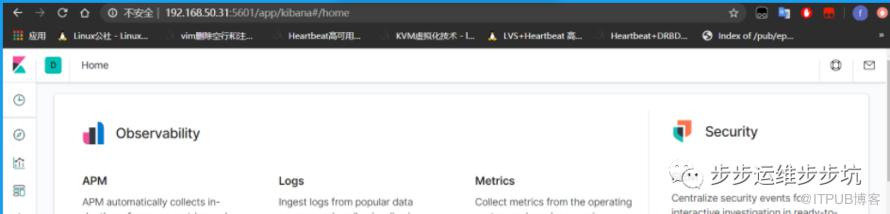
ELK日志收集系统部件部署完成
测试
生成日志 通过浏览器访问node3的Nginx服务器和apache服务器产生日志

配置kibana的模板

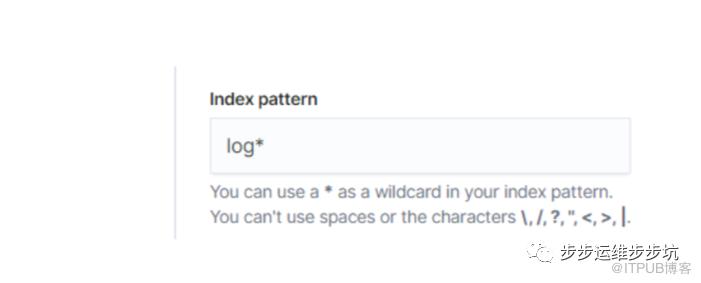
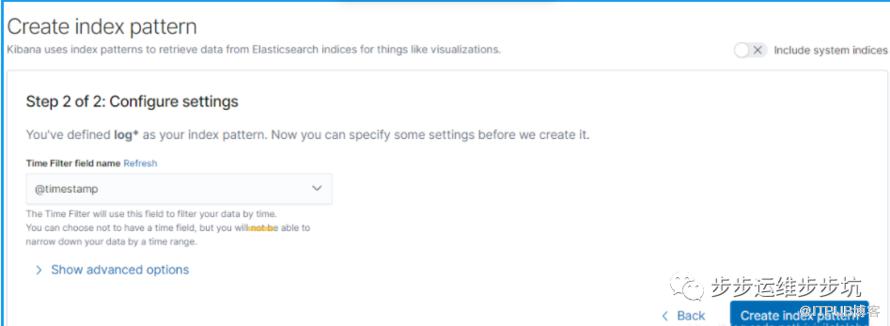
查看日志收集情况
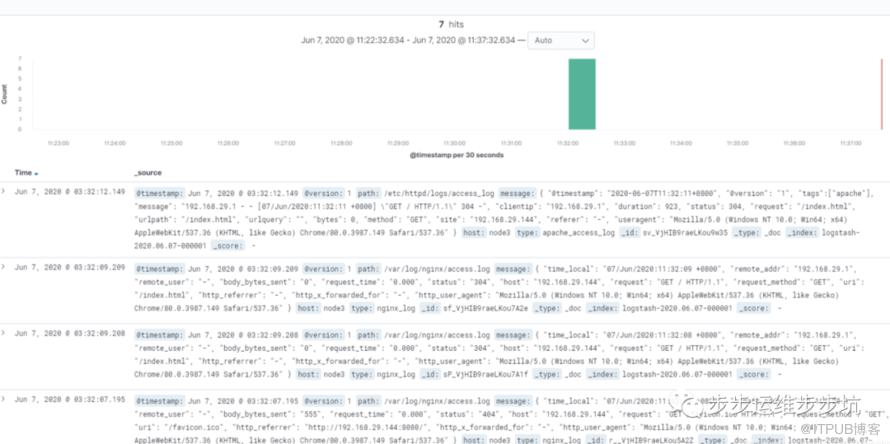
自此ELK日志收集系统部署完成并成功运转
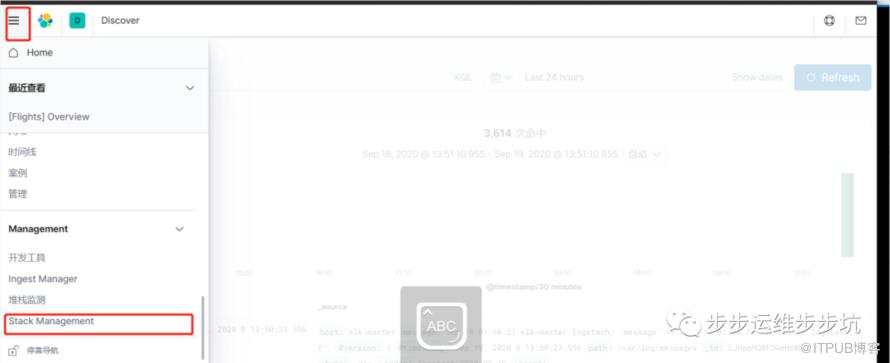
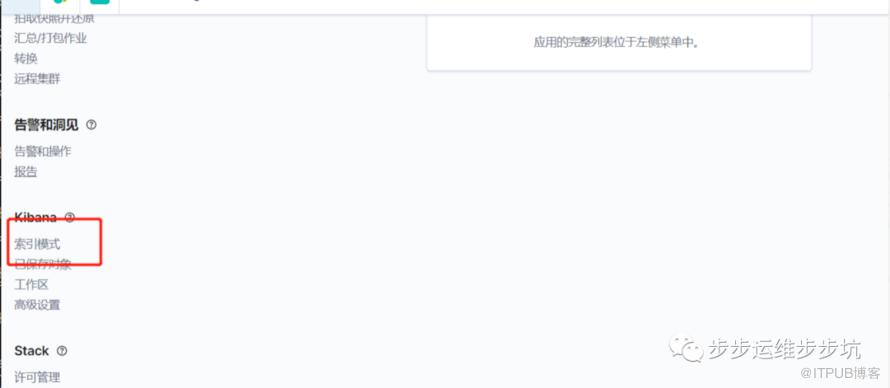
可查看到是否 有数据输入
yum 安装
环境说明
jdk 版本不变
JDK安装省略
源配置
# cat /etc/yum.repo.d/elasticsearch.repo

[elasticsearch-7.x]
name=Elasticsearch repository for 7.x packages
baseurl=https://mirror.tuna.tsinghua.edu.cn/elasticstack/7.x/yum/
gpgcheck=1
gpgkey=https://artifacts.elastic.co/GPG-KEY-elasticsearch
enabled=1
autorefresh=1
type=rpm-md
node1
# yum install logstash kibana filebeat
node2
# yum instasll elasticsearch fiebeat -y
node3
# yum install nginx httpd filebeat-y
服务配置省略
elasticsearch
# vim /etc/elasticsearch/elasticsearch.yml

path.data: /var/lib/elasticsearch
path.logs: /var/log/elasticsearch
network.host: 192.168.50.32
cluster.name: my-cluster
node.name: node2
bootstrap.memory_lock: false
http.port: 9200
discovery.seed_hosts: ["192.168.50.31","192.168.50.32"]
cluster.initial_master_nodes: ["192.168.50.31"]
node.max_local_storage_nodes: 100
http.cors.allow-origin: "*"
启动和自启
# systemctl start elasticsearch
# systemctl enable  elasticsearch
验证
curl http://192.168.50.32:9200kibana
Kibana
# vim /etc/kibana/kibana.yml

server.host: "192.168.50.31"
elasticsearch.hosts: ["http://192.168.50.32:9200"]
i18n.locale: "zh-CN"
启动和自启
# systemctl start kibana
# systemctl enable kibana
logstash
# vim /etc/default/logstash

$JAVA_HOME ="/usr/local/java"
vim /etc/logstash/logstash.yml

path.data: /var/lib/logstashpipeline.ordered: auto
path.logs: /var/log/logstash
# vim /etc/logstash/conf.d/pipeline.conf

input {
beats{
        port => 5555
        codec => json  # 直接将filebeat保存在message中的json字串解析出来
        }
}
filter {
    json {
    source => message
    tag_on_failure => ["_jsonparsefailure"]
    skip_on_invalid_json => true
    add_field => {
    "hostname" => "%{[agent][hostname]}"}}
    if  "messages" in [tags]{
    grok{
       match => {"messasge" => "%{SYSLOGLINE}"}}}
}

output {
if "apache" in [tags] {
elasticsearch  {
hosts => ["192.168.50.32:9200"]
index => "apache-access-log-%{+yyyy.MM.dd}"}}
if "messages" in [tags] {
elasticsearch  {
hosts => ["192.168.50.32:9200"]
index => "messages-log-%{+yyyy.MM.dd}"}}
}
启动和自启
# systemctl start logstash
# systemctl enable logstash
验证
# netstate -tnlp |grep 5555
filebeat
vim  /etc/filebeat/filebeat.yml

filebeat.config.inputs:
  enable: true
  path: "${path.config}/inputs.d/*.yml"
output.logstash:
  hosts: ["192.168.50.31:5555"]
mkdir /etc/filebeat/inputsvim /etc/filebeat/inputs/logs.yml (此处只写出了node3上面)
- input_type: log  paths:
    - /var/log/messages
  tags: ["messages", "node3"]
- input_type: log
  paths:
    - /var/log/httpd/access_log
  tags: ["http-access-log", "apache"]
- input_type: log
  paths:
    - /var/log/httpd/error_log
  tags: ["http-error-log", "apache"]
- input_type: log
  paths:
    - /var/log/nginx/access.log
  tags: ["nginx-access-log", "nginx"]
- input_type: log
  paths:
    - /var/log/nginx/error.log
  tags: ["nginx-error-log", "nginx"]
启动和自启
# systemctl start filebeat
#ystemctl enable filebeat
期待你的
分享
点赞
在看
添加博主
微信号|yfq940-
原文作者:步步运维步步坑;如有侵权,请联系管理员删除。

