SQL优化思想1-2-3(参考文链接)
上期回顾
小余买鱼与数据库优化【1】——诊断与改进
小余买鱼与数据库优化【2】——需求与设计
小余买鱼与数据库优化【3】——资源的利用
小余买鱼与数据库优化【4】——真正的需求
小余买鱼与数据库优化【5】——买鱼买出方法论
小余买鱼与数据库优化【6】——方法论应用案例(上)
1.2.1.3需求与设计(再次优化)
遇到疑问最重要的就是,去理解需求是什么?真正的需求让我大吃一惊!原来该SQL1的语句在过程包中的代码是类似如下的:
beginselect count(*) into v_cnt from t1 ;if v_cnt>0 then …A逻辑….else then …B逻辑…..End;
因为这条select count(*) from t1执行的偏慢,所以被10046 TRACE给追踪到了,但是这个逻辑真的需要这么实现吗?
我来翻译一下这段需求,获取t1 表的记录数,判断是否大于0,如果大于0走A逻辑,否则就走B逻辑。因此代码就如上所示来实现了。
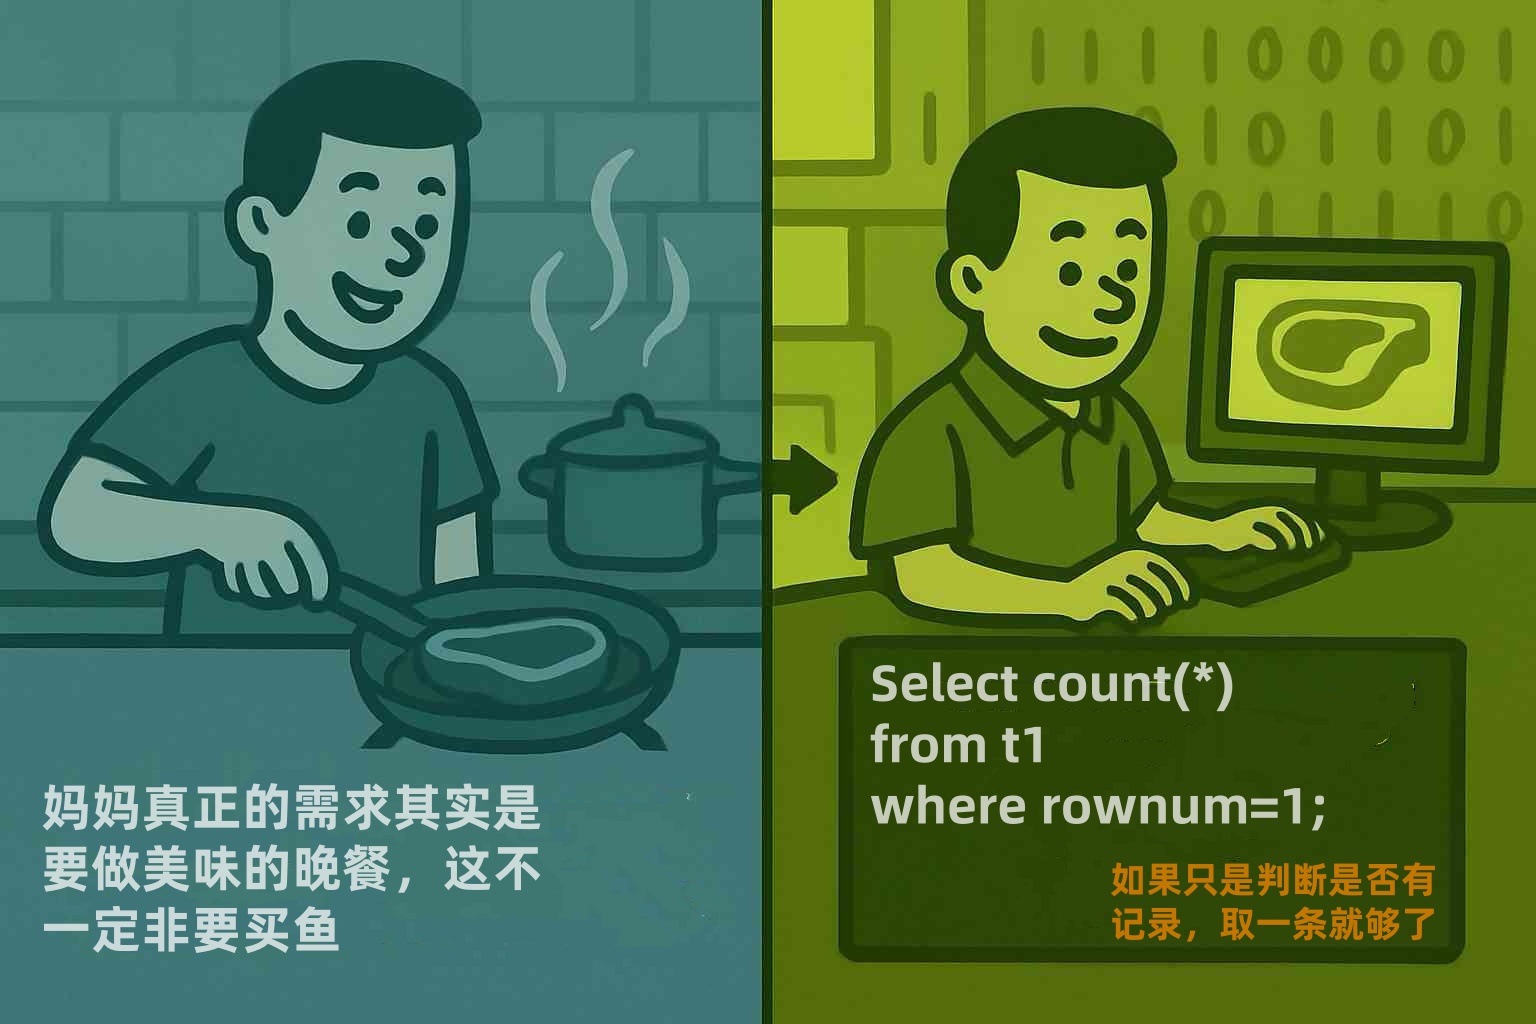
真正的需求是这样吗?其实应该是这样的:只要T1表里有记录就走A逻辑,否则就走B逻辑。
两者有区别吗?其实区别还是很大的,前者可是强调获取记录数,我们是不是一定要遍历整个表得出一个记录数才知道是否大于0?真正需求的理解可以让我们这样实现,只要从T1表中成功获取到第一 条记录,就可以停止检索了,表示该表有记录了,难道事实不是这样?
因此原先的SQL1 从Select count(
) from t1; 被改造为Select count() from t1 where rownum=1; 速度从1秒提升到0.01秒,几乎可以忽略不计了。这里我们马上联想到《小余买鱼4》 ,妈妈真正的需求其实是要做美味的晚餐,站在这个角度,完全可以用现成的其他菜来代替非常麻烦的买鱼经历,少做事甚至不做事而快速满足需求,提升效率。
对于SQL2,我查看了T2表,发现真有大量重复记录,怪不得需要用distinct来排重。我很奇怪为什么会有重复记录,在问明开发设计人员后,我明白了,原来是源头程序有漏洞,导致t2表出现大量重复记录,现在所有的应用只要涉及到访问t2表的,都需要增加distinct关键字来排重!
天啦,居然还有这回事!还有更神奇的,关于此处的order by ,居然是多余的,展现的几个字段的输出根本无需排序,没这个需求!
接下来思路很简单,就是优化了源头程序(另外一个数据库包),保证插入t2表的数据再也不会有重复记录,然后再把t2表记录进行删除重复记录的操作。
后来t2表的记录从原来的500万缩减为20万,最难得的是,distinct语句可以去掉了(因为不会有重复记录了),order by 也去掉了(因为根本没有顺序展现的需求),现在T2表不但记录数变小了,排序也都避免了,结果SQL2也由原来的1秒优化为0.01秒,也快到几乎可以忽略不计了。
现在后台短信进程调用该过程包,需要总时间还不足0.1秒,比起以前成百上千倍的提升,这次优化终于取得了圆满的成功!
最难能可贵的是,很多和这个后台短信进程无关的别的应用也快了!咦,很奇怪吗?其实不奇怪,因为只要是访问t2表的应用都少做了两件事,第一是不再需要增加distinct语句来去重了,避免了排序。第二就是以前访问t2表是大表,现在是访问小表。
读者还记得我说的T2表排除重复记录的事情吧,我当时提供了技术方案给维护人员,方案是新建一张表出来,提取不重复记录,然后把旧表替换了,大致思路如下:
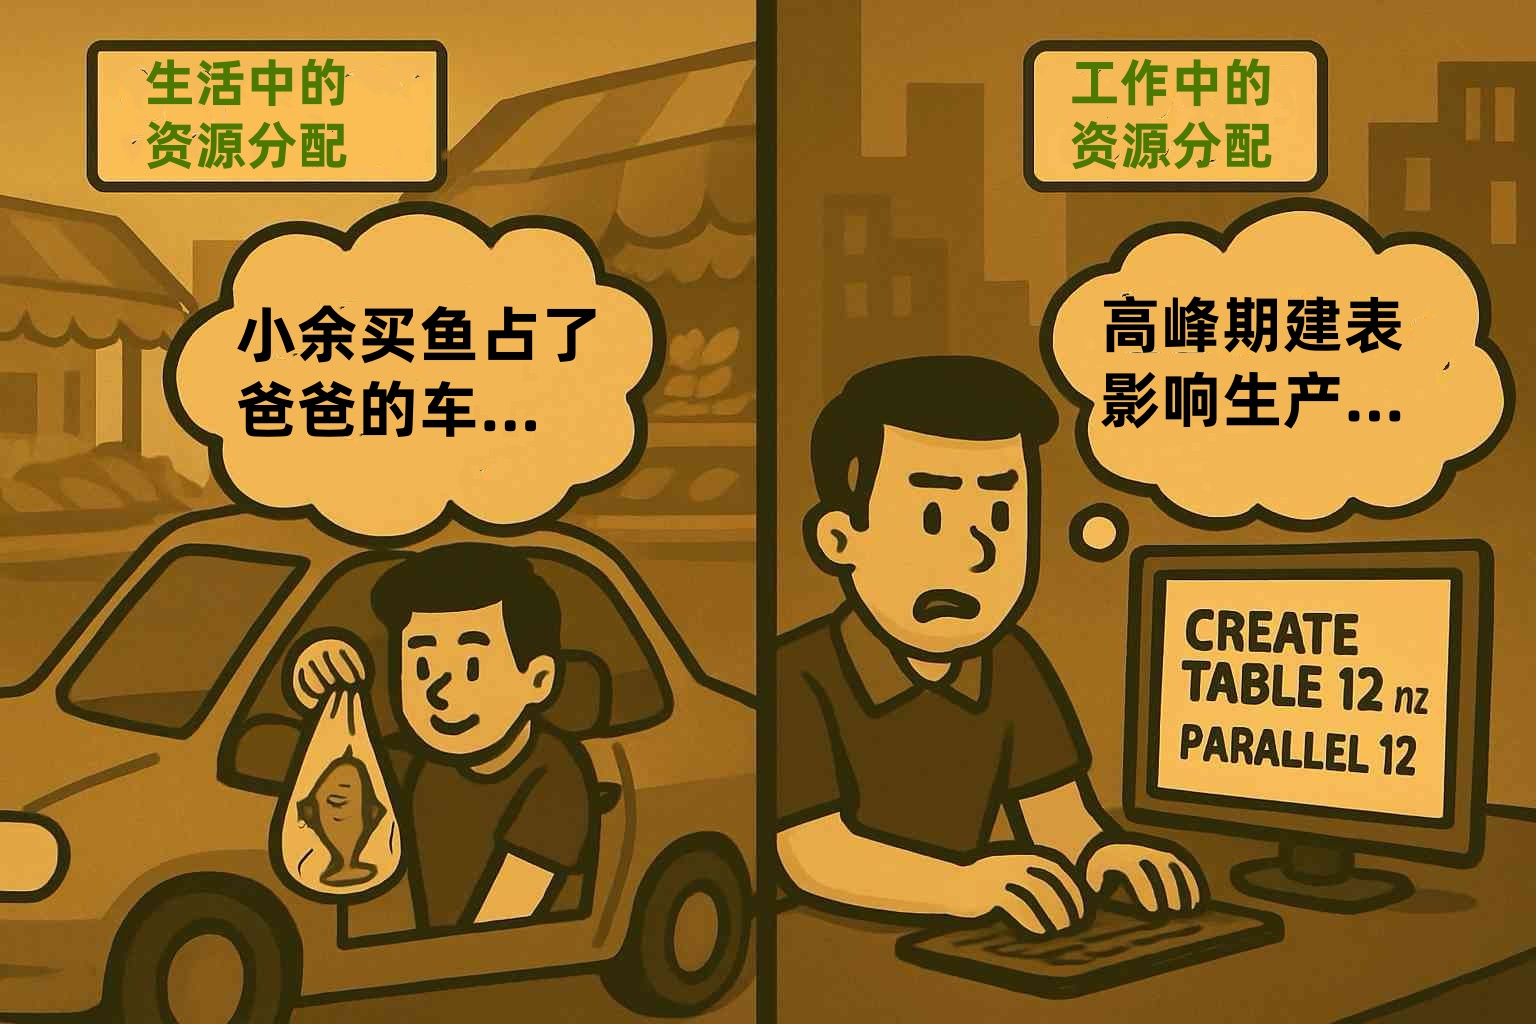
Create table t2_new nologging parallel 12
As select  distinct * from t2 where …..;
- 停应用
- Rename t2 to t2_bk
- Rename t2_new to t2;
- 补上t2表的相关索引,并将t2表的logging属性恢复。
我之前有提醒是要在业务不繁忙的时候操作,比如凌晨打补丁的时候顺道操作。因为我有写了parallel 12 ,表示要并行用到12个CPU。(而当时生产仅有12个CPU)。
可惜的是维护人员自作主张,在大白天系统繁忙的时候执行了上述语句,结果导致12个CPU资源被这条create table t2_new的语句占据消耗着,引发生产系统短时间的压力繁忙,险些压垮了系统,好在该语句在5分钟内结束,未造成严重的影响。
亲爱的读者,这个花絮让你们联想到什么吗?应该是《小余买鱼3》吧,小余不会合理利用资源,开车去楼下附近农贸市场买鱼,导致要去远方开会的爸爸没车开,迟到了。当然《小余买鱼2》却是会合理利用资源的典范,爸爸去出差了,要去那么远的地方,不选择开车去就是傻瓜了。如果维护人员按我的要求在凌晨打补丁的时候顺便执行这个语句,不用并行也是不善于利用资源,因为凌晨系统没有什么进程在运行,不会有应用因为CPU被占用光而收到影响。
还记得前面《小余买鱼》故事总结的买鱼方法论中的“两大 法宝”吧,总结的很简单,就是意识+技能。不知道读者注意到没有,这次生产系统的数据库优化不断体现出这两大 法宝的作用。
- 思考该数据库包具体涉及那几个模块,主要矛盾又在哪个模块?(选择用10046 TRACE 工具包来实现);
- 找到问题所在以后去理解需求,探索是否能少做事完成需求(选择用索引来替代全表扫描,从而减少访问路径);
- 去思考需求背后的真正需求(最终将select count(
) from t1 改造为select count() from t1 where rownum=1);
- 去分析资源如何合理应用 (在系统繁忙时使用并行,占用他人资源,险些酿成大祸)。
为什么称之为意识,因为这些并不是具体的知识点技能的使用,更像是一种经验的总结,习惯的培养,所以称之为意识。那技能呢?其实上述的意识正是和技能紧密联系的。比如 10046 TRACE诊断工具包的使用和学习;比如执行计划的查看与分析;比如理解索引的原理;比如知道如何使用并行的命令...
Oracle优化的意识的内容大致就在总结的一套流程中,看起来内容不多,不过这些朴素的道理确是优化的核心思想,非常经典!相比ORACLE优化意识而言,ORACLE技能涉及的范围却有不少,比如除了前面介绍的技能的一小部分外,还有理解ORACLE体系结构;理解表连接原理;理解AWR等性能报表的使用与分析;精通SQL和PL/SQL编程等等...
原来优化方法论和生活中的故事是一样一样的,你看明白了吗?
公众号:收获不止数据库
微信:ljbyxl1213
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/9091385/viewspace-3084578/
,如需转载,请注明出处,否则将追究法律责任。

