一文搞懂 NVIDIA Holoscan 与 HSB:传感器数据到底是怎么“零拷贝“进 GPU 的
先说结论:如果你做的是医疗影像、工业检测、机器人感知这类 对延迟有硬指标的项目,那你迟早会碰到两个东西——NVIDIA Holoscan 平台,和它前面那块叫 Holoscan Sensor Bridge(下称 HSB)的板子。
很多人第一次看官方文档会有点懵:Holoscan 到底是框架还是平台?HSB 是硬件还是协议?这篇文章把这两个概念拆开讲清楚,顺便把链路、指标、上手路径都捋一遍。
一、老问题:传感器接不进来,算法再准也没用
做过边缘视觉的都知道,烦人的从来不是模型。
摄像头是 GMSL2 的,雷达走 CAN,激光雷达走以太网,超声是一路模拟视频,还有台老设备只有 HDMI 输出。每种传感器的协议都不一样,而且很多是厂家私有的—— 开发、维护、扩展这三件事,成本都在协议层,不在算法层。
更要命的是数据路径。传统做法是:传感器 → 采集卡/接口 → 主机内存 → CPU 调度 → 拷到 GPU 显存。这一路上数据被搬了至少两次,中间还夹着内核态和用户态的切换。4K60 一帧 RGB888 就是 24MB 左右,60 帧/秒意味着每秒要搬 1.5GB 量级的数据,全靠 CPU 搬运,延迟抖动完全不可控。
NVIDIA 对这件事的判断很直接: 传感器接入不应该是每个项目自己拼的活,它应该是平台能力的一部分。HSB 就是从这个判断里长出来的东西。
二、Holoscan 是什么:不是推理框架,是"流"的平台
官方定义是这样的:Holoscan 是一个 多模态计算平台,提供加速的全栈基础设施,对运行在边缘的流数据做 可扩展、软件定义的实时处理。用途写得很明确——医疗影像、机器人开发、工业传感器。
注意"流"这个字。DeepStream、TensorRT 这些工具的前提是"数据已经在内存里了",它们只管算。Holoscan 管的是 从传感器上电那一刻,到结果画在屏幕上那一刻的整条流。
它由三层构成:
1)Holoscan SDK 基于图的编程框架,用 Python 或 C++ 把算子(Operator)串成流水线。I/O、预处理、推理、后处理、可视化都是"即插即用"的算子,并且支持 动态流量控制——运行中改算子之间的连接关系,做条件分支、自适应路由。比如检测到异常帧就临时切一路高精度模型做二次推理,不用重编译整条流水线。
2)Holoscan Sensor Bridge(HSB) 把视频、超声、雷达等传感器数据直接送进 GPU,做低延迟的同步处理。下面单独讲。
3)NVIDIA IGX 工业级边缘硬件载体。Holoscan SDK 保证同一套流水线可以在目标平台上灵活部署。
官方列了四条优势,前三条好理解——低延迟实时性能、模块化工作流、从 Jetson 到 IGX 再到 DGX 的可扩展性(同一套代码换硬件不用重写)。第四条最容易被跳过,但恰恰是关键: 生产级、软件定义的硬件,靠 GPUDirect 做快速 I/O、靠 HSB 接传感器、靠 MONAI 做医学成像。
说白了,Holoscan 的设计前提就是"传感器接入是原生能力"。这也是它跟"自己攒一套采集链路 + DeepStream"最本质的区别。
三、HSB 是什么:一条把传感器变成以太网流的通道
NVIDIA 给 HSB 的定位是 以太网传感器串流平台(sensor-over-Ethernet)。用一句话概括它的工作方式:
通过 FPGA 接口,把高速传感器数据直接流式送进 GPU 内存,并提供标准 API 和开源软件。
拆开看三个关键词:
"FPGA 接口" —— HSB 不是靠 CPU 去轮询搬运的。传感器信号进到 FPGA,帧捕获、协议转换、时间戳标记这些活在硬件层就完成了。这也是它能做到确定性延迟的根本原因。
"直接进 GPU 内存" —— 走的是 NVIDIA GPUDirect 这条路,数据绕过 CPU 和主机内存的中间拷贝,直接落到显存里。官方给的数据是,在 IGX Orin 上用 GPUDirect 做信号处理,延迟可以做到 1 毫秒以内。
"标准 API + 开源软件" —— 这一条对开发者最实际。官方提供的不只是一块板子,而是一套能访问流式 DMA、能控制 GPIO / SPI / I2C、能读写自定义寄存器、还带传输抽象层和 Linux socket 接口的软件栈。传感器厂商或集成商可以基于这套标准 API 自己写驱动、自己做应用,不用每家都从零发明一套私有协议。
四、几个关键指标,以及它们的口径
这些数字建议连口径一起记,单独摘出来讲容易失真:
| 指标 | 数值 | 测量口径 |
|---|---|---|
| 4K60 相机端到端延迟 | 17 ms | 从光子到 IGX Orin 上显示,全链路 |
| GPUDirect 信号处理 | < 1 ms | 在 IGX Orin 上实测 |
| CoE(以太网相机)CPU 占用 | 约 1% | 在 AGX Thor 上启用加速 |
| 相对传统方案的延迟 | 最多降低 10 倍 | 官方对比口径 |
| 驱动开发时间 | 最多缩短 100 倍 | 官方对比口径(指创建和集成传感器驱动环节) |
| 网络速率 | 10GbE ~ 100GbE | 模块化设计支持范围 |
| 功能安全 | 符合 SIL 2 | 端到端安全协议 |
这组数字里我最看重的是 1% CPU 占用。延迟数字大家都在卷,但"CPU 几乎不参与数据搬运"这件事,意义在于把 CPU 的时间片彻底让给业务逻辑——多路相机 + 多传感器融合 + 实时控制同时跑的时候,这个差别非常明显。
17ms 和 1ms 不要混用。 17ms 是"光子进、屏幕出"的整链路;1ms 是数据落到显存后做信号处理那一段。前者衡量系统,后者衡量传输。
五、它跑起来是什么样
整条链路大致是这样:
各类传感器(相机 / 雷达 / 激光雷达 / RF / 超声)
        ↓  (私有协议、模拟信号、各种物理接口)
   HSB 模组(FPGA:协议转换 + 帧捕获 + 打时间戳 + 打包)
        ↓  (标准以太网,10GbE ~ 100GbE)
   算力主机(IGX Orin / AGX Thor / Jetson Orin)
        ↓  (GPUDirect,绕过 CPU)
   GPU 显存(DRAM)
        ↓
   Holoscan SDK 流水线 → 推理 → 可视化 / 控制输出

值得单独提的是" 软件定义传感器"这个设计。传感器的寄存器配置(曝光、增益、触发模式)不是靠改 FPGA 逻辑来适配的,而是通过 I2C / SPI / GPIO 这套控制通道从主机侧下发。换一款新相机,多数情况下改的是配置和驱动代码,不是重新流片。官方把这叫"把新传感器的集成简化到软件定义级别"——这是 HSB 能被不同行业的传感器厂商接进去的前提。
上层应用看起来还是普通的 Holoscan 写法:
from holoscan.core import Application
from holoscan.operators import FormatConverterOp, InferenceOp, HolovizOp
class MyPipeline(Application):
    def compose(self):
        # HSB 接收端:通过标准 API 拿到 DMA 流,对上层就是一个数据源算子
        rx    = self.make_operator("hsb_receiver", {})
        fmt   = FormatConverterOp(self, in_dtype="rgb888", out_dtype="float32")
        infer = InferenceOp(self, backend="trt", model_path="model.plan")
        viz   = HolovizOp(self, window_title="HSB Live")
        self.add_flow(rx, fmt, {"frame": "frame"})
        self.add_flow(fmt, infer, {"tensor": "preprocessed"})
        self.add_flow(infer, viz, {"tensor": "receivers"})
(代码是示意结构,具体算子参数以你手上的 SDK 版本为准。)
你会发现, "这块板子"在应用层几乎是透明的。这就是 HSB 想要的效果:把协议适配、帧同步、传输这些脏活沉到硬件和标准 API 里,应用层只看到一条干净的数据流。
六、跟几种常见方案放一起比
| 方案 | 数据路径 | 延迟 | CPU 占用 | 主要限制 |
|---|---|---|---|---|
| USB 相机 | 传感器→USB→内核→内存→GPU | 较高(官方口径下 HSB 约低 5 倍) | 高 | 带宽和线缆长度受限 |
| MIPI 直连 | 传感器→CSI→内存→GPU | 中等(HSB 约低 1.5 倍) | 中 | 排线短,多路布线困难 |
| 传统采集卡 | 传感器→采集卡→内存→GPU | 十几毫秒,抖动大 | 中高 | 依赖厂商私有 SDK,多源同步难 |
| HSB | 传感器→FPGA→以太网→GPU 显存 | 17ms 全链路(4K60) | 约 1% | 需 FPGA 侧适配,成本不低 |
表里最后一行"限制"是真话。HSB 依赖 FPGA 和万兆以上网络,硬件成本摆在那儿;如果项目只是单路 USB 相机跑个 YOLO,用 DeepStream 反而更省事。 HSB 的价值区间在多路、高速、强同步、低抖动的场景——单路轻量场景用它属于过度设计。
七、想上手,官方给了三条路
不想买整机、想自己评估的,官方这套启动选项比较实用:
第一条:直接跑软件栈。 全栈方案由 NVIDIA Holoscan 支持,保证 HSB 接口的数据能一路到达 DRAM。提供了标准 API 来访问流式 DMA、控制 GPIO / SPI / I2C、读写自定义寄存器,还有传输抽象层、智能网卡加速和 Linux socket。配套有《HSB 用户指南》和 HSB IP。
第二条:拿合作伙伴的评估板。 FPGA 侧有 Altera、Lattice、Microchip PolarFire 的方案;MCU 侧有 NXP、STMicroelectronics 的方案。相当于给你一份参考设计,把 FPGA/MCU 侧最难的那段先铺好了。
第三条:直接用集成方案。 生态里有摄像头厂商和模拟信号转换厂商的成品,拿来就能接。
这三条路对应三类人:想验证软件可行性、想自己做硬件、想快速出产品。
八、多传感器融合为什么在这儿特别重要
官方在讲 HSB 的动机时,第一句就是"连接不同的摄像头、雷达、激光雷达和 RF 传感器通常需要独特的专有协议"。这句话不是客套。
真正难的不是把某一路相机接进来,而是 让四路相机、一路激光雷达、一路 IMU 的数据在同一个时间基准上对齐。传统做法是在主机侧软件打时间戳,精度取决于调度,多源融合时外参标定好了照样飘。
HSB 的思路是把同步放在硬件层:帧捕获时打戳,多设备之间可以走 PTP(IEEE 1588) 对齐。这套机制在手术导航、高速产线、机器人环视这类"位置必须严格对应图像"的场景里是刚需——差几毫秒,可能就是"看着没缺陷、实际已经过去了"。
再加上 SIL 2 的功能安全等级和端到端安全协议,意味着这套链路在设计上是可以进医疗和工业安全相关系统的,不用后期再补一套安全层。
九、落到国内项目上,现成的硬件形态
HSB 是 NVIDIA 的开放技术,IP、软件栈、参考设计都对外开放,所以关键在于 谁能把这块 FPGA 板子做成能直接插相机、能直接上机的成品,以及谁能把驱动和文档维护住。
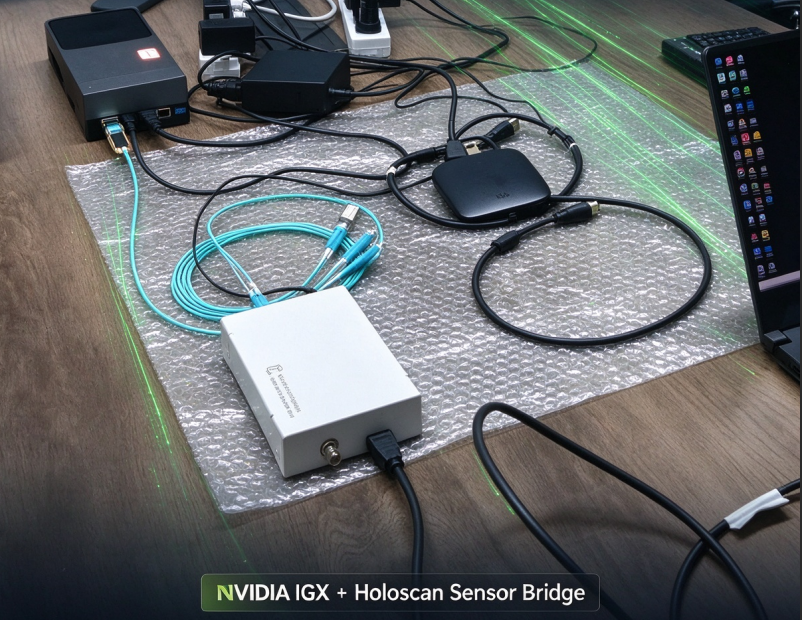
视程空间(我们)这条产品线就是干这件事的,目前覆盖几种主流接口形态:GMSL2 单路 / 四路版本(车载相机、多目视觉)、HDMI2.0 + 12G-SDI 版本(医疗摄像机、内镜、广电信号源,支持 4K60,SFP+ 光口输出,尺寸 157.23 × 107.9 × 36.4 mm,无风扇、即插即用)、以及多路 4K 汇聚型号。硬件侧统一走 GPUDirect RDMA 直写显存和 PTP 同步,软件侧跟 Holoscan SDK 原生对接,配套的接收组件和 NexVDO SDK 一起提供。
指标口径这里也说清楚:NVIDIA 官方的 17ms 是 IGX Orin 上的全链路测量;我们的模组在典型配置下端到端可以做到 10ms 以内,个别短链路配置能进亚毫秒级, 具体取决于你的传感器、分辨率和帧率,拿自己的数据流实测才算数。
十、适合谁,不适合谁
适合:
- 医疗影像设备(内镜、OCT、手术导航),要实时性也要功能安全;
- 工业高速产线检测,图像和工位必须严格对应;
- 机器人 / 自动驾驶的多传感器融合,多路相机 + 雷达同步是刚需;
- 仪器仪表、信号处理,需要把高速采集和 GPU 计算连成一条流。
不太适合:
- 单路 USB 相机做轻量推理,DeepStream 更合适;
- 预算很紧、已有成熟自研采集链路且短期没有升级计划;
- 需要设备本地编码存档、离线回放(HSB 不做编码和存储,得另配)。
结语
把 Holoscan 和 HSB 放在一起看,逻辑其实很简单: Holoscan 把"任务关键型实时感知"拆成传感器桥接层、算力处理层、软件流水线层,各司其职。NVIDIA 把后两层做完了,第一层长期是各家自己拼,HSB 就是补这个缺口的标准答案。
对开发者来说,这件事最实际的价值是:你终于可以把时间花在算子上,而不是花在调驱动、改时序、追丢帧上。
如果准备动手,建议的验证顺序是:先拿一块评估板,用自己的相机和分辨率把数据流跑通;再压 72 小时连续运行看丢帧;最后测多路同步的实际偏差和端到端延迟的 抖动分布(别只看平均值)。这三项过了,剩下的都是可以谈的。
参考来源
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70050123/viewspace-3188868/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 视程空间将边缘AI内存用量降低约20%,让智慧社区影像分析在NVIDIA Jetson Orin NX 8GB
- 5000 路摄像头,4 个值班员:智慧城市的瓶颈其实在“判断发生在哪里”
- 把超声原始数据直接喂给 AI?聊聊我们实测的 Holoscan Sensor Bridge(HSB)
- 视程空间Edge工业边缘盒:给工业机器人装一颗耐造的“本地大脑“
- 视程空间Holoscan方案中立测评:边缘AI传感器处理,是生态红利还是差异化能力?
- 四足机器狗/人形机器人开发瓶颈如何破?视程空间全套算力与视觉解决方案
- Holoscan 与 HSB 传感器桥接模组:打通边缘实时 AI 感知的最后一公里
- 视程空间Pandora:157TOPS边缘算力,落地本地离线大模型开发
- 视程空间SC系列采集卡|专业级4K图像采集硬件,构筑产业视觉系统坚实底座
- 解锁机器人开发全新势能|视程空间将NVIDIA Jetson Orin Nano 2赋能,2 倍 AI 推理性能
