为什么要分库分表?
随着业务的发展,单库单表难以满足我们对性能的要求,在分库之前,可能我们经历了sql调优、索引优化、数据库参数优化、读写分离、使用分布式缓存来降低我们数据库的压力。但是随着业务再一步扩大,以上的方法可能就不适用了;基本上就以下几种情况
IO瓶颈
并发量过大,查询磁盘次数过大,特别是缓存命中率很低的时候更严重(分库)
表太大,一次查询磁盘操作过多(分库、或分表,单表容量控制在2000万以内,根据业务增长预估提前规划)
进出数据比较多,网络IO较大 (分库)
数据库参数未优化,比如可以开启组提交来降低IO操作
缓存设置过小也会
CPU瓶颈
大SQL查询导致cpu彪高,单独从库,或者走大数据
函数操作,特别是聚合、排序、分组、关联查询,能在程序中处理最好在程序中处理
未走索引,优化sql,或者添加索引
存储瓶颈
比如阿里单实例最大3TB,业务数据过多无法存储(分库)
一般不建议单实例存储太多的数据,存储数据多,代表着表多,表多了磁盘寻址也是个性能损耗
连接数瓶颈
并发量过大,链接数不够用(分库)
死锁导致堆积,也会带来cpu瓶颈(实时监控与治理)
慢查询,导致连接消耗也会带来cpu瓶颈
我还遇到一个因微服务拆分带来的分库需求,由单体拆出去以后多个项目共用一个数据库,多源写导致数据操作难以控制。
数据切分
既然要分库分表,那一定会涉及到数据的切分,一般有两种模式,垂直切分,和水平切分;
垂直切分
一种是分库
将不同的系统模块的表拆解到不同的库中;
将同一个系统模块中根据数据量或者业务规则拆到不同的库中(程序关联性大的放在一起);
将不同的租户数据拆到不同的库里(表结构一样)
举个例子:比如我们授信系统,拆成了两个库auth 和auth2
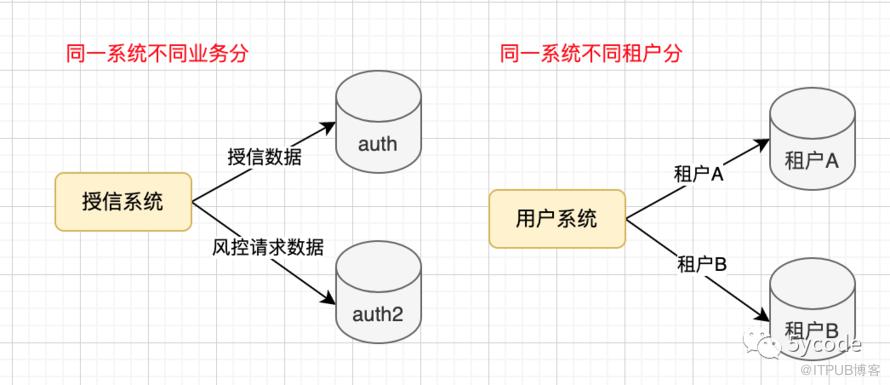
auth库里是用户授信记录
auth2库是风控相关的操作记录
一种是分表
将字段特别多的表拆分为多个表;
将大字段拆出(单行超过700多个字节的时候,会拆到额外的存储区域)
举个例子:

还有我们在做业务的时候,也会不自觉的采用分表,比如我们的工单表和工单扩展表
水平切分(每个表的结构相同)
这个主要是解决单表数据量过大的问题,比如说,10亿的用户,单表存储不现实的吧,一般会拆成10张表;
水平拆分,一般由程序进行控制,一般有以下几种方式:
范围拆分
按照id范围,比如id[1~1000万)一张表,id[1000万~2000万)一张表,以此类推
增删数据库实例方便,全量顺序查找方便
按照创建时间,比如一个月或者一年一张表
业务操作都得带着时间,比如查询最近一个月的账单,可以拆分出来查哪些库表
交易订单、银行流水等按照时间排序的
按照某个分类比如租户分表
业务操作都得带租户,按租户查找方便,按租户新增库表方便
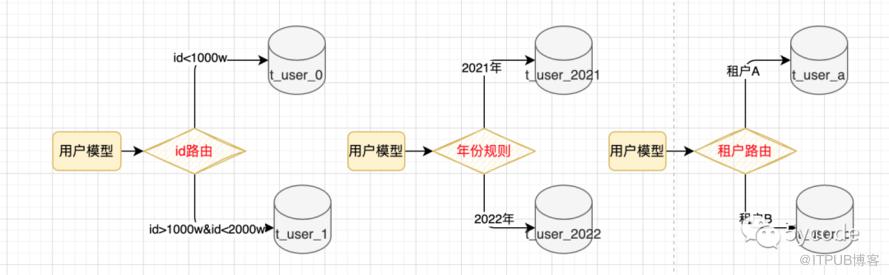
优点:
扩/缩容方便(增加或删除库表方便)
归档方便
缺点:
流量倾斜,热点数据不均衡(热点一般都是新进来的数据)
某个库表压力过大
取模拆分(一般为业务主键)
note: 分表尽可能使用比较均匀的字段,同时要考虑到用户的行为习惯,比如手机号码,大部分人不会选择尾号为4的手机号,如果按尾号分,很容易出现尾号4的库表访问量少的问题,同时还有一个身份证,也存在同样的问题(x相对较少),如果必须要用这两个,建议hash以后再分
如果是整数,直接进行取模,比如 id/10 路由到不同的库表中;
如果是字符串,可以先hash,然后再取模(避免流量倾斜)
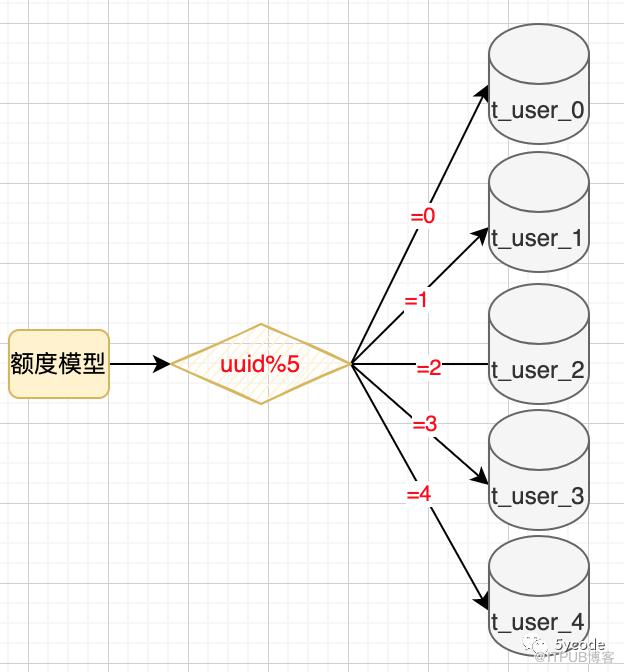
优点:
数据分散相对均匀
数据库表的负载压力均衡
缺点:
扩展能力差(增加库表,数据需要进行迁移)
平衡难以把控,一次规划好,浪费资源,业务增量大,迁移麻烦
扩展能力差的问题,可以用一次性hash的方式来降低迁移的难度;
分库分表带来的问题
数据倾斜问题
业务与倾斜要选一个平衡,比如电商类,在双十一和双十二的订单里会很大,避免不了的倾斜;
数据倾斜不一定会出现热点问题;
热点问题
热点问题,通过取模或一致性hash解决
事务问题
一般互联网应用中不建议使用事务,建议业务补偿,保证最终一致性;
分库时,尽可能将一个事务内的操作放入到一个库,避免跨库事务;
实在避免不了,还必须用事务,用分布式事务解决
本地消息表
TCC
RocketMQ的事务消息
事件中心
saga
聚合查询问题
一般是统计报表或数据分析,需要用到聚合函数或join,这种情况下不建议在业务系统里;
如果是业务系统使用,一般会冗余一些字段,减少聚合查;
一般互联网应用不建议聚合查,代码层进行组装,降低数据库的压力;

通过中间件将各分库的数据同步到聚合库,这个聚合库可以是hbase或者Cassandra里,也可以是oracle,当然也可以是mysql;
分库以后各表的主键id建议使用分布式id,使用雪花算法
yyyyMMddHHmmssSSS+机器位+内存序列,能保证数据相对有序,毫秒级的数据能落入到一个数据页中,性能损耗不大,根据实际需求,可以把自己定义机器位的大小和内存序列的大小;
分页问题
如果是以分区主键来查询业务,分页问题就不是问题;
如果是全局查,且分页,建议使用聚合库做查询分页,操作接口再到具体的分库分表上;
根据业务属性增加一层处理机制,比如审核类的,我们分页查找一般都是进行中的,审核完的,只需要精确查找就行;
我们抽出一个处理中的表,在这里进行业务操作处理;
处理完的一般都是精确查找,如果需要业务分析,大数据处理
如果不使用聚合库,只能使用全局查找,先把符合条件的数据查到,然后在内存中聚合,然后再分页,如果数据量大,oom了,同时对于数据库的压力也不小;
非分区业务查询
比如我们使用用户的uuid分表,然后我们要通过手机号mobile查用户的信息,怎么办?总不能来个全库扫描吧。那怎么办?
-
关系映射
当通过mobile查询的时候,先查到uuid再去具体的表里查
将映射关系存储到一张索引表,通过旁路缓存查询
直接永久缓存起来(需要考虑缓存失效的问题,缓存中没有怎么处理?)
通过手机号生成uuid
在往用户表插入数据的时候,通过一个固定方法把mobile转成uuid(需要考虑去重,极小的概率会重复)
基因法(高低位存储)
自己设计一个id生成器生成uuid,高位存储时间戳(20221201221126945)+3位机器位+3位内存毫秒级自增序列,
低位(2~3位)存储分区规则,分区规则由mobile生成
分库分表实现或工具
直接写mybatis插件自己实现
通过库名和表名替换实现路由
TDDL(淘宝)
https://github.com/alibaba/tb_tddl 2012年后未更新
jar包的方式供应用调用,可以理解为自己实现的增强版
通过规则匹配后做表名替换,然后将sql转发过去
Cobar中间件(阿里巴巴)
https://github.com/alibaba/cobar 2018年以后未更新
cobar是在amoeba基础上进化的版本
代理方式
mycat 中间件
基于ocbar开发的
http://mycatone.top/ 现在社区在推2.x的版本
也是基于代理的方式,所有的规则都配置在mycat里;
ShardingSphere-JDBC 和ShardingSphere-Proxy
https://shardingsphere.apache.org
ShardingSphere-JDBC 仅支持java,低损耗、无中心化的工具
ShardingSphere-Proxy(代理)
大部分都是使用ShardingSphere-JDBC
hash分库分表在线处理方案
水平扩库
note: 如果生产上能对这个库的写拦截10秒左右最好,数据无损
中间件+程序改造
比如dts同步到kafka,然后消费kafka处理
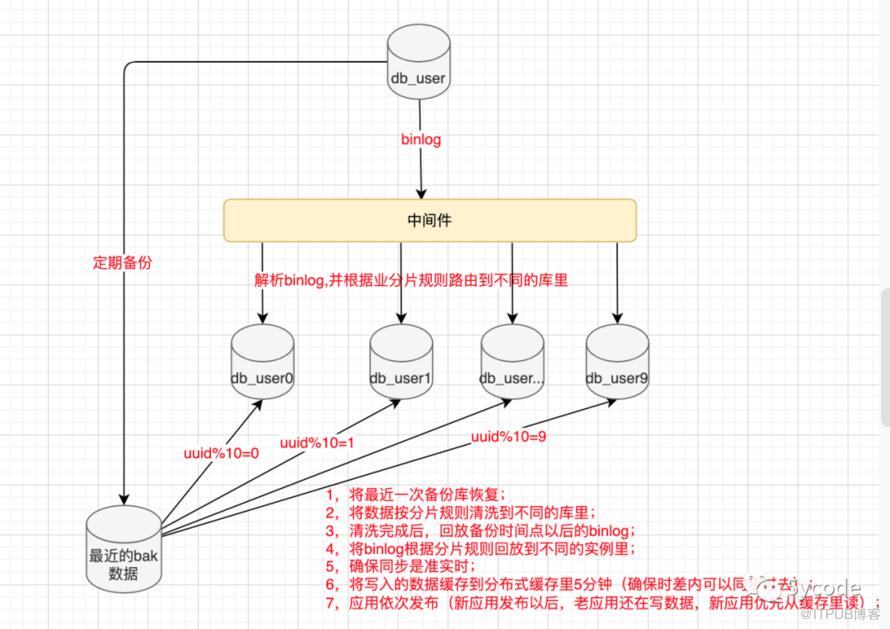
将最近一次备份库恢复;
将数据按分片规则清洗到不同的库里;
清洗完成后,回放备份时间点以后的binlog;
将binlog根据分片规则回放到不同的实例里;
确保同步是准实时;
将写入的数据缓存到分布式缓存里5分钟(确保时差内可以同步过去);
应用依次发布(新应用发布以后,老应用还在写数据,新应用优先从缓存里读);
从库机制
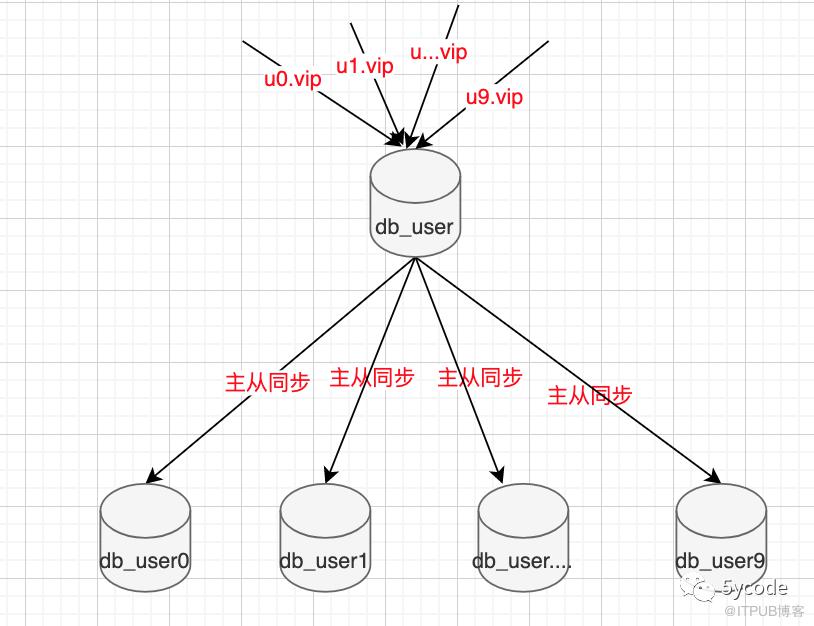
先给要分库的库挂对应数量的从库,比如要分10个库,挂10个从库
同时申请10个VIP挂先挂指向主库db_user上
增加路由规则,uuid%10=0的走u0.vip,其他的类似
虽然路由到了不同的vip上,但是这个vip都指向了主库;

原文作者:5ycode;如有侵权,请联系管理员删除。

最新文章
- DeepSeek+ragflow构建企业知识库之工作流,突然觉的dify又香了
- dify1.0.0版本升级及新功能预览
- DeepSeek+ragflow构建企业知识库:突然觉的dify不香了(1)
- DeepSeek官方充值终于开放了,相关工具推荐
- 聊聊dify权限验证的三种方案及实现
- DeepSeek+dify 工作流应用,自然语言查询数据库信息并展示
- DeepSeek+dify知识库,查询数据库的两种方式(api+直连)
- DeepSeek+dify 本地知识库:高级应用Agent+工作流
- 腾讯有Dify团队吗?difySandbox成了腾讯Dify团队开源的
- Deepseek+Dify本地知识库相关问题汇总
