这两天有小伙伴问我一个问题,为什么redis的zset用跳跃表,不用b+ tree?
我先不说结论,我先说下 跳跃表 和B+tree 。
跳跃表
在之前的 《redis源码阅读-zset》 中,已经详解了zset的使用跳跃表的源码,今天借用下之前的图片。
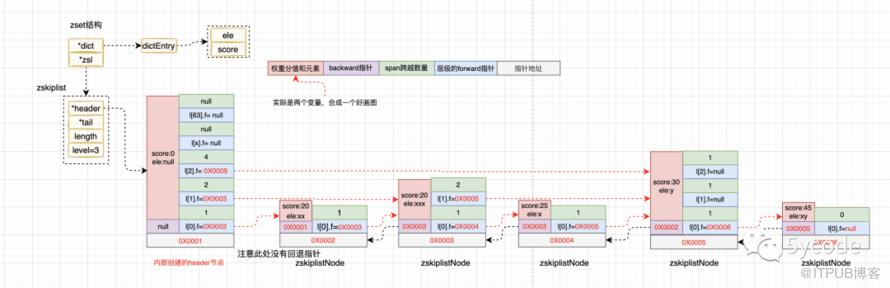
zset在演化为跳跃表以后,主要有两块
一块以
*dict存储的 元素与分值的hash映射一块以
*zsl存储的跳跃表的信息关键是
*header的一个64级的数组(可以理解为hashmap的桶结构)第0层是所有数据的以score排序的双向链表
第1~63层是是构建出来的跳跃表,也是双向链表
在插入数据的时候会随机生成 层级(每一个元素都有可能是0~63级),从上到下查找并插入
在查找数据的时候,有分值直接查,没分值先从
*dict获取对应元素的分值
在这里我们一定要注意几个点,
元素的层级结构
双向链表
举个例子,见下图

插入:
假如有socre=30、25、45 这三个元素,最高层级2层
插入score=30的时候,随机出了3级索引,
会把header节点第2层的指针l[2]指向该元素,同时往下1层查
会把第1层的score=20的指针l[1]指向该元素,同时顺着score=20往下一层查
找到score=30的插入顺序
插入score=60的时候,随机出了4级索引
会把header节点第3层的指针指l[3]向该元素,同时顺着header往下1层查
会把第2层score=30的节点的指针l[2]指向该元素,同时顺着score=30往下1层查
会把第2层score=30的节点的指针l[1]指向该元素,同时顺着score=30往下1层查
然后插入score=45的时候,随机出了3级索引
从header节点第4层查,发现score=60大于45,顺着header往下1层查
查到header的l[2]层,发现45>40,ok,定位到score=30
score=30的l[2]指向60,将该指针指向45,同时将45的l[2]指向score=60
score=30的l[1]指向60,将该指针指向45,同时将45的l[2]指向score=60
理论上最多从*header的最高层到最低层,然后链表查询
删除:
定位到元素以后,通过双向链表,获取到前驱和后继节点,直接改变指针即可
时间复杂度:
跳跃表最坏的时间复杂度为O(n) (索引高度只随机出一层的时候)
B+ Tree
之前在 记一次生产慢sql查询的解决 和InnoDB存储引擎存储结构详解-实战篇中介绍了B+ Tree的结构,以及数据存储分析

首先,我们先了解下:
InnoDB是以数据页为一个存储单元,默认16kb;
非叶子节点存储索引,叶子节点存储数据
一个bigint的索引,在一个索引页中有
878条记录,一个数据页中123条数据(数据量大小和表结构有关,我贴的是我的试验数据)默认mysql三层最多数据页有
878*878约77万个数据页通过
innodb_space -s ibdata1 -T innodb_space/t_user_info -F 1 space-index-fseg-pages-summary可以看到具体的层级按照我试验的表结构,三层可以容纳 77*123= 9471w条数据
当时灌了5000万条数据占磁盘7.7GB
插入:
如果是数值类型,非自增插入
通过底层索引,二分查找,最多8次能定位到第2层的索引页
然后在第二层索引页里,通过二分,再最多进行8次定位到第3层的数据页
在数据页中通过二分查找,最多再6次定位到数据
如果数据页过大,还得进行页分裂
如果是自增插入,只需要在内存中缓存每层的最后节点,能O(n)定位到。
如果是字符串呢?效率会进一步退化
删除
按根据主键删除
和数值型非自增插入的查询效率一样
如果中间删除数据多了,导致相邻的数据页过小,还会进行页合并的操作
如果非主键,先定位到主键再回表。
时间复杂度
平均时间复杂度为O(logn)
分析
相同点(以score和数据库主键id相比)
最下面一层都是顺序的,而且是双向链表
都可以通过二分查找查找数据
不同点
B+ Tree的结构是平衡的,层级默认3级,时间复杂度为O(logn)
zset的跳表数据结构,最高64层,最矮就1层,每个score的对应的层级都是随机的,时间复杂度最差为O(n)
跳表一个节点存储一条数据
B+ Tree是以页为单位存储索引和数据
隐性不同:
redis是纯内存,无磁盘IO
mysql是内存+磁盘 ,如果索引都在磁盘,需要3次IO,如果树的层级高了,需要的IO更多,效率更低
B+ Tree 需要保持树的平衡,会有一系列的分裂与合并(顺序写可以忽略)
zset的跳表插入数据简单,随机出来层了,定位到以后改个链表节点即可
总结
redis设计本身使用的是极简思想,跳跃表的操作,比二叉树简单,不需要考虑平衡,实现起来也简单,我觉的这个是重点
redis是纯内存操作,不需要考虑磁盘IO的次数(一个
*header可以理解为一个数据页,只不过是在内存里)MySQL为了持久化,需要考虑磁盘IO,利用数据页,系统缓存,减少磁盘的操作顺序
如果这个问题反过来就好解释了,MySQL为什么用B+Tree 而不用跳表
层低,磁盘IO少
性能稳定
平衡
到达每一个叶子节点的路径都固定
就上面的两个,实现复杂度高了也无所谓
原文作者:5ycode;如有侵权,请联系管理员删除。

最新文章
- DeepSeek+ragflow构建企业知识库之工作流,突然觉的dify又香了
- dify1.0.0版本升级及新功能预览
- DeepSeek+ragflow构建企业知识库:突然觉的dify不香了(1)
- DeepSeek官方充值终于开放了,相关工具推荐
- 聊聊dify权限验证的三种方案及实现
- DeepSeek+dify 工作流应用,自然语言查询数据库信息并展示
- DeepSeek+dify知识库,查询数据库的两种方式(api+直连)
- DeepSeek+dify 本地知识库:高级应用Agent+工作流
- 腾讯有Dify团队吗?difySandbox成了腾讯Dify团队开源的
- Deepseek+Dify本地知识库相关问题汇总
