PostgreSQL高可用方案全解析:筑牢数据基石
本文整理于 HOW 2026 演讲内容,演讲者:杨宇,PG ACE,第八届 PG 数据库生态大会 2025 年度金 牌讲师,PG 分会哈尔滨用户组核心成员。
引言
在数据库运维中,有两件事是绝对不允许发生的:一是数据丢失,二是业务长时间停滞。备份恢复解决的是前者——防止人为误操作导致的数据损坏;而高可用(High Availability,HA)解决的则是后者——当硬件故障发生时,如何让业务以最快速度恢复运行。
本文将从高可用的核心概念出发,深入解析PostgreSQL的复制技术,对比主流高可用方案,并分享性能优化、监控体系与故障应对的实战经验。
一、高可用概述与核心挑战
1.1 什么是高可用?
高可用不仅是减少停机时间,更是保障业务连续性与数据安全的综合性工程目标。它主要解决三个层面的问题:
- 业务连续性:确保服务7×24小时不间断,硬件或网络故障时业务能快速恢复。
- 数据安全性:保障数据不丢失、不损坏,故障发生后能够恢复到正确状态。
- 用户体验:最小化服务中断影响,保证应用系统始终稳定流畅。
高可用的最终目标,是将系统可用性提升至 99.9% – 99.99%+ ,即每年停机时间仅数小时甚至数分钟。
1.2 核心指标:RTO 与 RPO
衡量高可用方案有两个关键指标:
RTO(Recovery Time Objective) ——恢复时间目标
- 定义:从故障发生到系统完全恢复运行的时间
- 构成:检测时间 + 切换时间 + 应用恢复时间
- 要求:该值越小越好,金融交易场景通常要求 < 30秒
RPO(Recovery Point Objective) ——恢复点目标
- 定义:故障后系统允许丢失的数据量(以时间衡量)
- 计算:最后一次备份到故障发生的时间差
- 要求:核心业务要求 RPO = 0(零数据丢失)
简单来说, RTO关注服务恢复速度,RPO关注数据丢失量。
1.3 高可用面临的挑战
在实际落地过程中,高可用架构面临多重挑战:
| 挑战 | 说明 |
|---|---|
| 数据一致性 | 主备切换时,备库数据必须与主库完全一致 |
| 快速故障检测 | 准确识别故障,避免因网络抖动等造成误判 |
| 自动故障切换 | 无需人工干预,自动将服务切换至备库 |
| 脑裂防护 | 防止网络分区等极端情况下多节点同时成为主库 |
| 性能损耗 | 复制和同步机制会带来开销,需在可用性与性能间权衡 |
| 运维复杂度 | 高可用架构更复杂,对运维人员的技术水平要求更高 |
二、PostgreSQL复制技术深度解析
PostgreSQL原生支持两种复制方式: 物理复制(流复制) 和 逻辑复制。
2.1 物理复制(流复制)
原理:在主库上,预写日志(WAL)记录被实时或异步地传输到一个或多个备库。备库通过重放这些WAL记录,在物理块级别上与主库保持完全一致。
特点:
- 主备之间是整个数据库集群的复制
- 备库通常处于只读状态,可用于查询负载分流
- 是实现高可用的基础
三种确认级别:PostgreSQL提供了三种同步确认级别,用于在数据安全性和性能之间权衡:
| 级别 | 机制 | 适用场景 |
|---|---|---|
| remote_write | 主库提交后,仅等待备库接收到WAL并写入操作系统缓冲区即返回 | 追求最低写入延迟,可接受极端故障下的微小数据丢失 |
| remote_flush | 主库提交后,等待备库将WAL刷写到磁盘后才返回 | 推荐默认,确保零数据丢失 |
| remote_apply | 主库提交后,等待备库完成日志重放(应用至数据文件) | 需要备库实时反映主库最新数据,实现读写一致 |
2.2 复制槽(Replication Slots)
复制槽是PostgreSQL中用于跟踪下游节点已接收WAL位置的机制,其 核心作用是防止主库过早删除备库仍需要的WAL文件,确保复制的连续性。
重要警示:若备库永 久离线,必须手动删除对应的复制槽,否则主库WAL日志将无限堆积,最终耗尽磁盘空间。
查看复制槽状态的SQL:
SELECT slot_name, slot_type, active, restart_lsnFROM pg_replication_slots;
2.3 逻辑复制
原理:基于逻辑解码,将数据更改(INSERT、UPDATE、DELETE)以逻辑形式进行复制,采用 发布(Publication)与订阅(Subscription) 模型。
特点:
- 可复制单个表或一组表,而非整个数据库集群
- 支持跨版本复制、选择性复制
- 订阅端可写入,支持更复杂的拓扑
核心优势:逻辑复制将数据复制从“物理镜像”转变为“逻辑数据流”,提供了“复制什么”和“复制到哪里”的极 致灵活性。
三、主流高可用方案详解与对比
基于PostgreSQL官方文档认可的实现方式,目前主流的高可用方案主要包括以下几类。
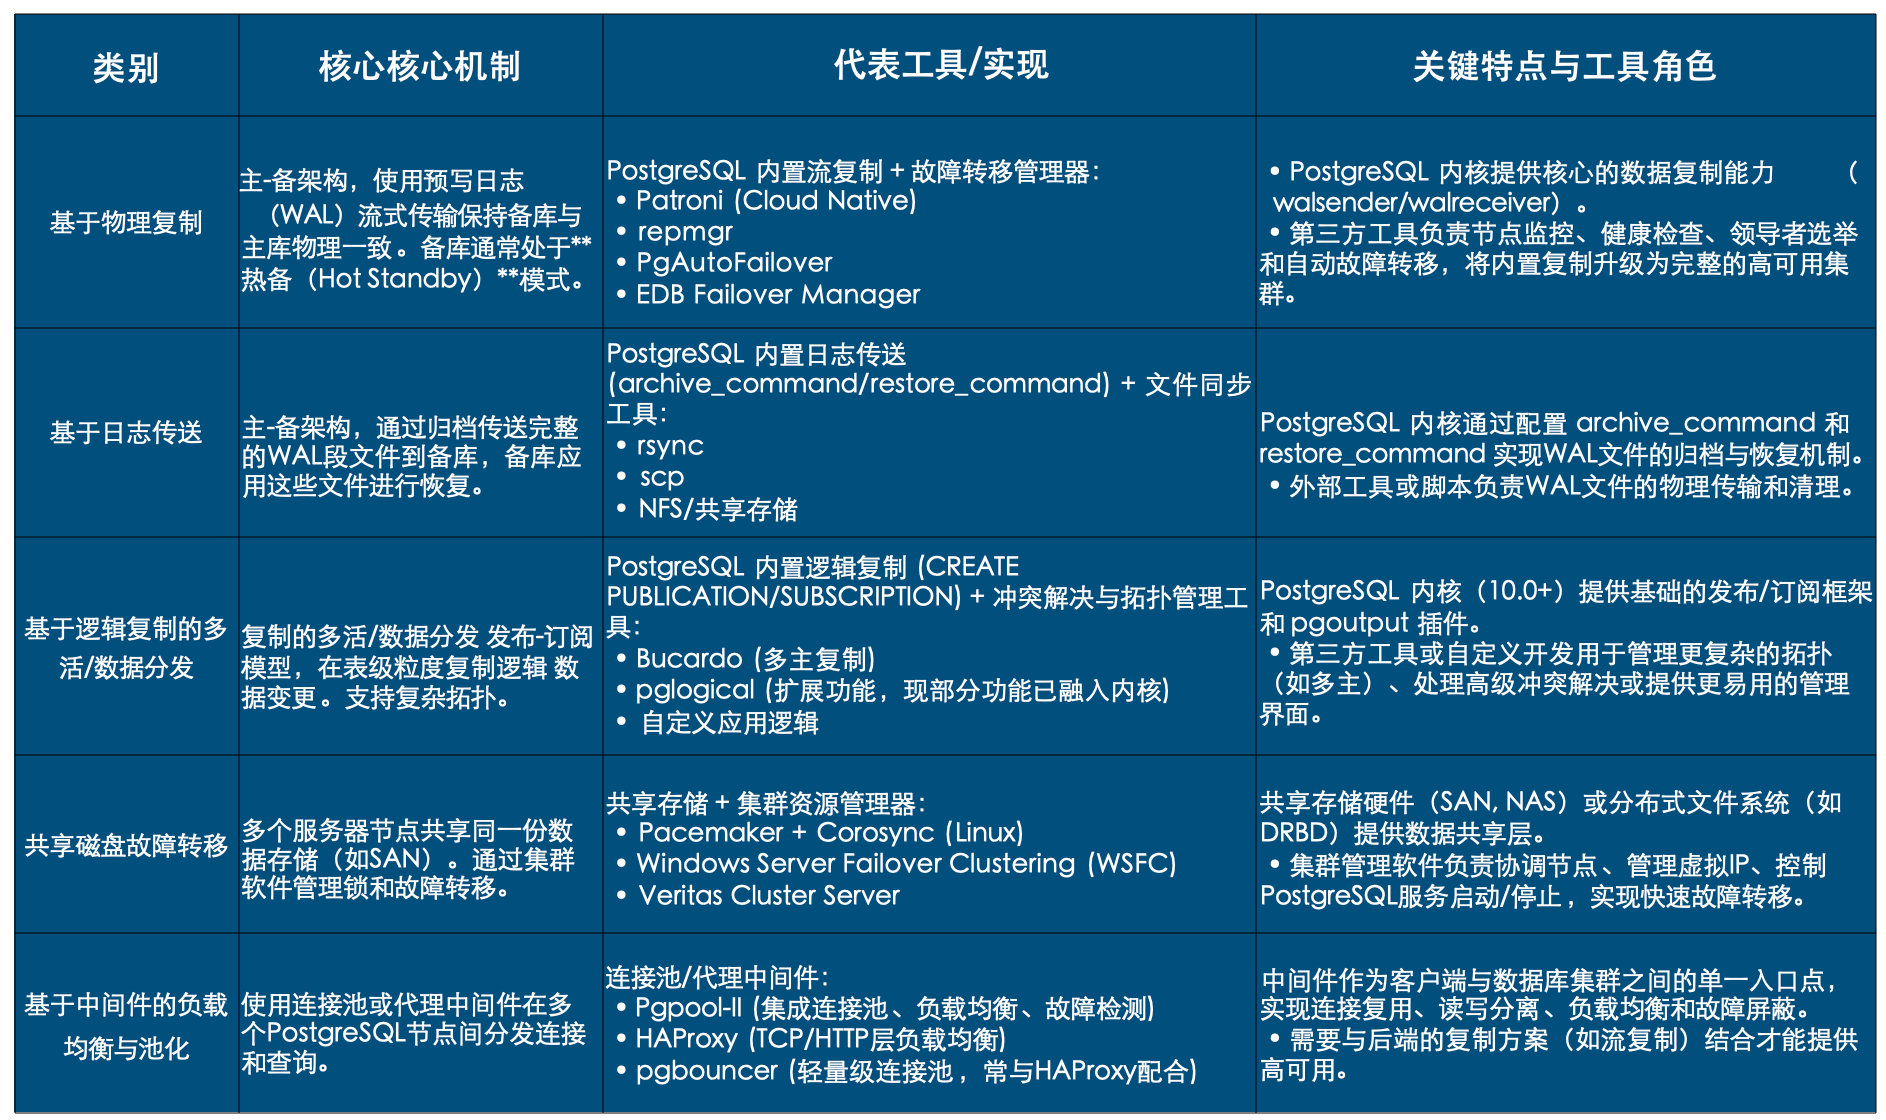
3.1 repmgr —— 轻量级流复制管理器
repmgr是专注于PostgreSQL流复制集群管理的工具套件,设计简洁,对现有系统的侵入性极低。
核心机制:
- Agent守护进程:各节点运行repmgrd,实时监控集群健康状态
- 共享元数据:集群拓扑信息统一存储在共享数据库中
- 智能故障转移:基于LSN对比自动选主,支持Witness节点防脑裂
优势:配置简单、资源占用低、社区成熟度高、维护成本低
局限:防脑裂机制较基础、自动化能力有限、云原生生态支持较弱
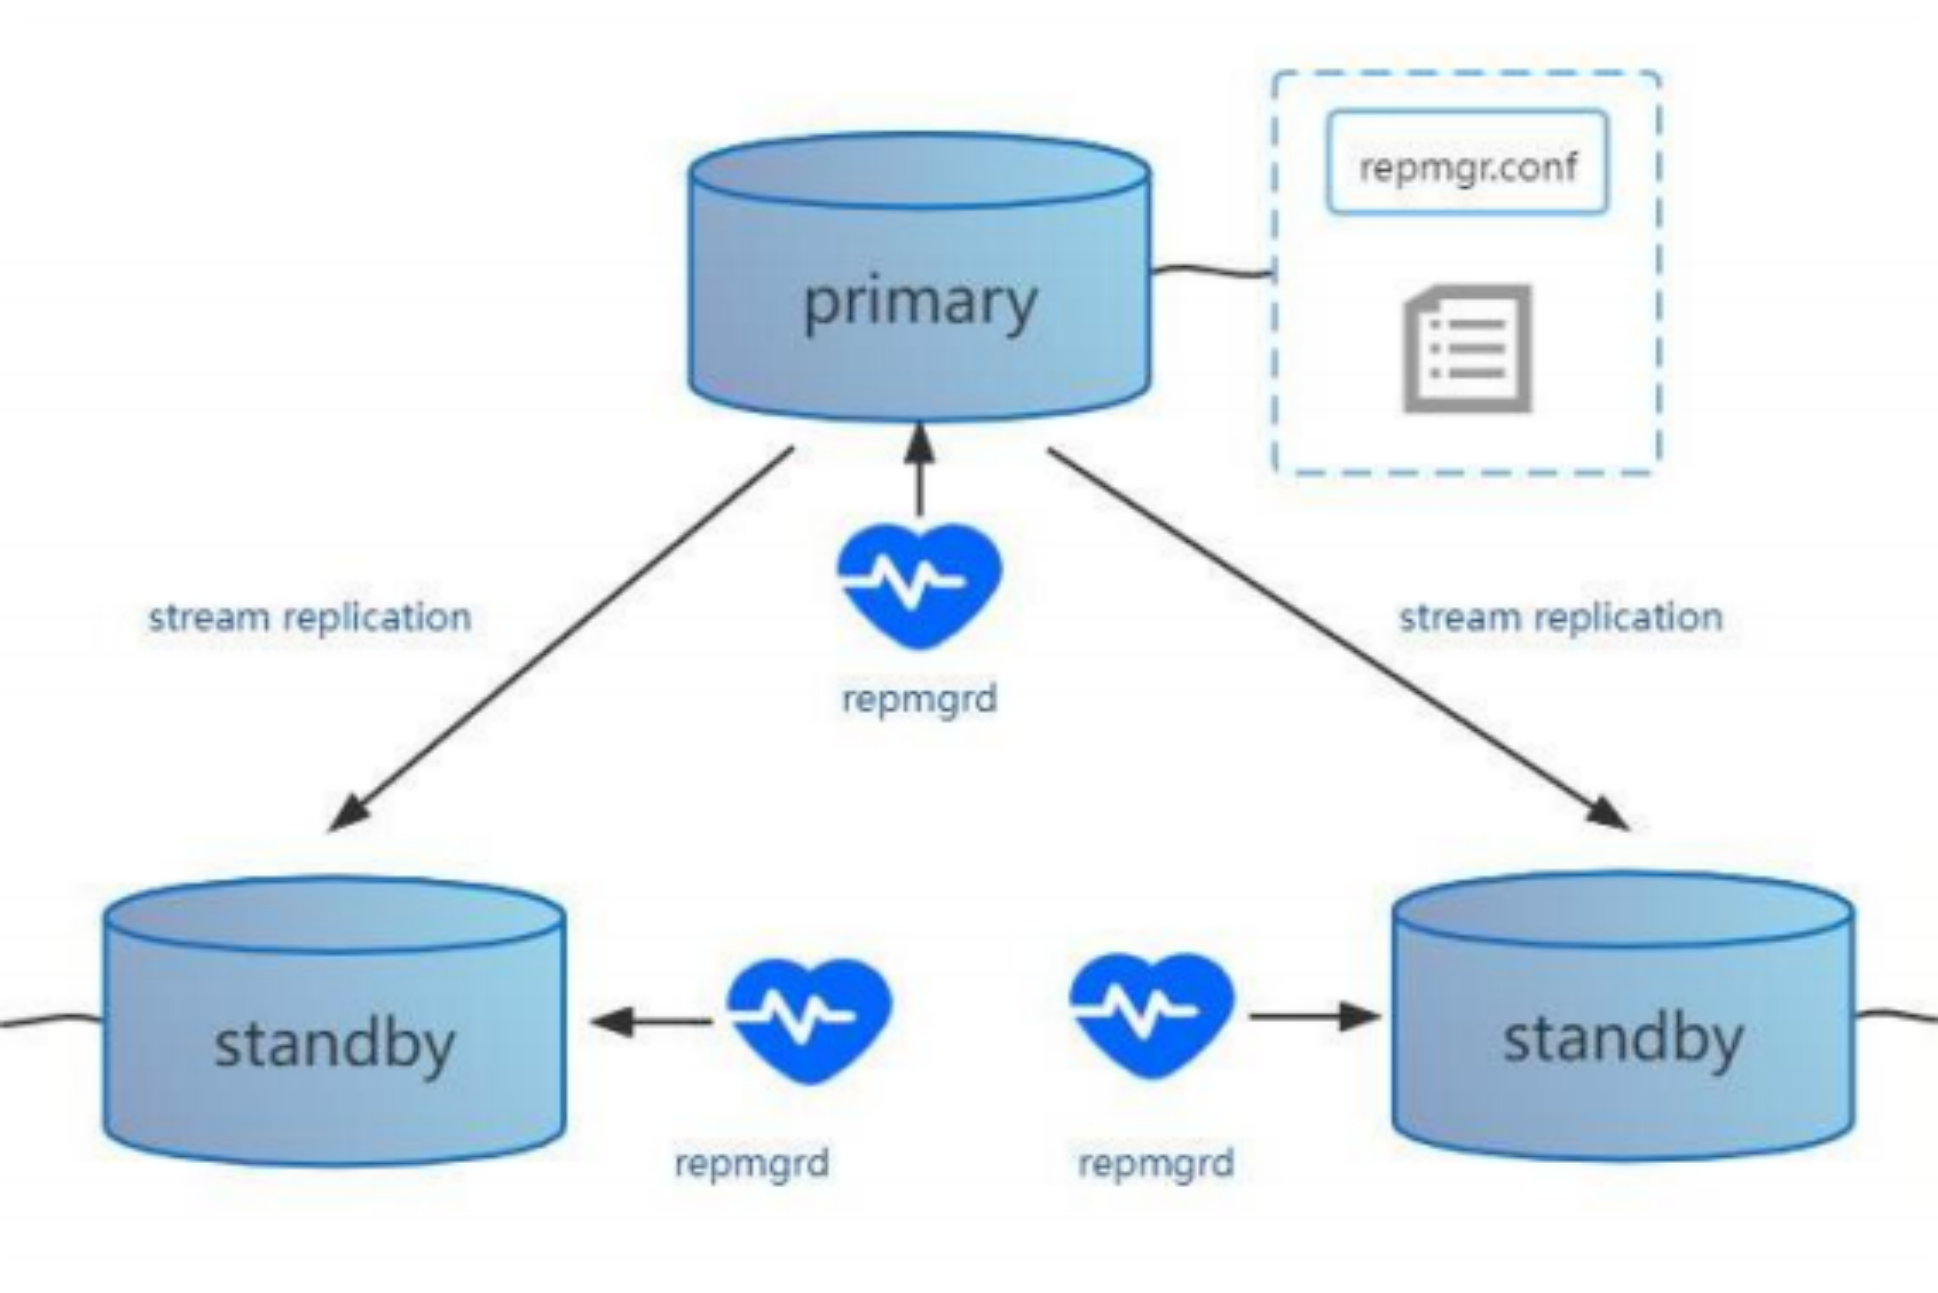
图示展示了主节点与备节点通过 Stream Replication 同步数据, repmgrd 进程实时监控各节点状态 ,实现自动故障转移。
3.2 Patroni —— 企业级推荐方案
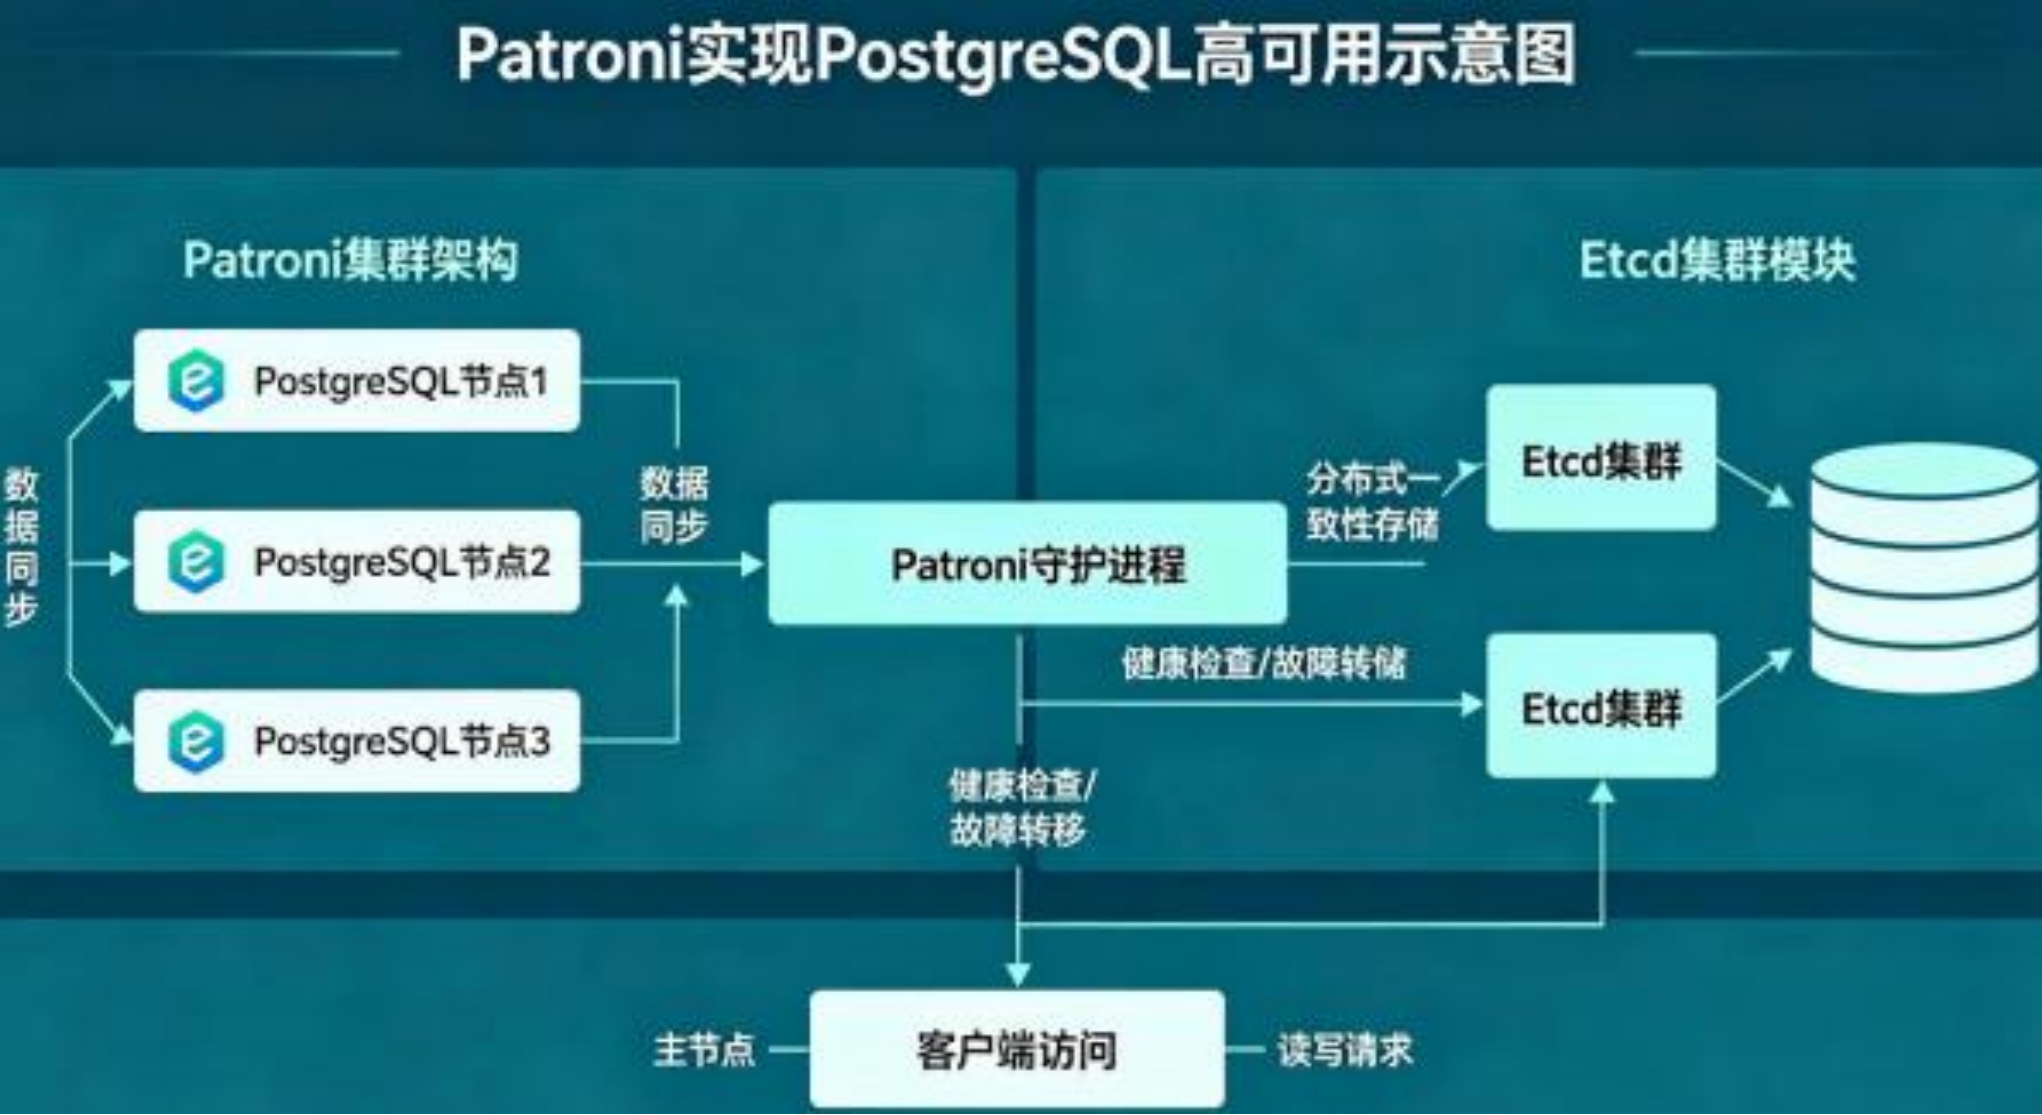
Patroni是基于分布式配置存储(DCS)的PostgreSQL高可用解决方案,是当前企业级部署中最受欢迎的方案之一。
核心机制:
- 基于DCS选举:利用etcd/Consul(基于Raft协议)实现领导者选主,天然防止脑裂
- Agent守护进程:每个数据库节点运行Patroni进程,统一管理PG实例生命周期
- 秒级自动容灾:通过DCS租约机制检测故障,实现全自动秒级主从切换
优势:高自动化运维、数据强一致性、云原生友好、社区生态极其活跃
注意:需额外部署维护DCS集群,对运维人员有一定技术要求
3.3 Stolon —— 云原生PostgreSQL设计
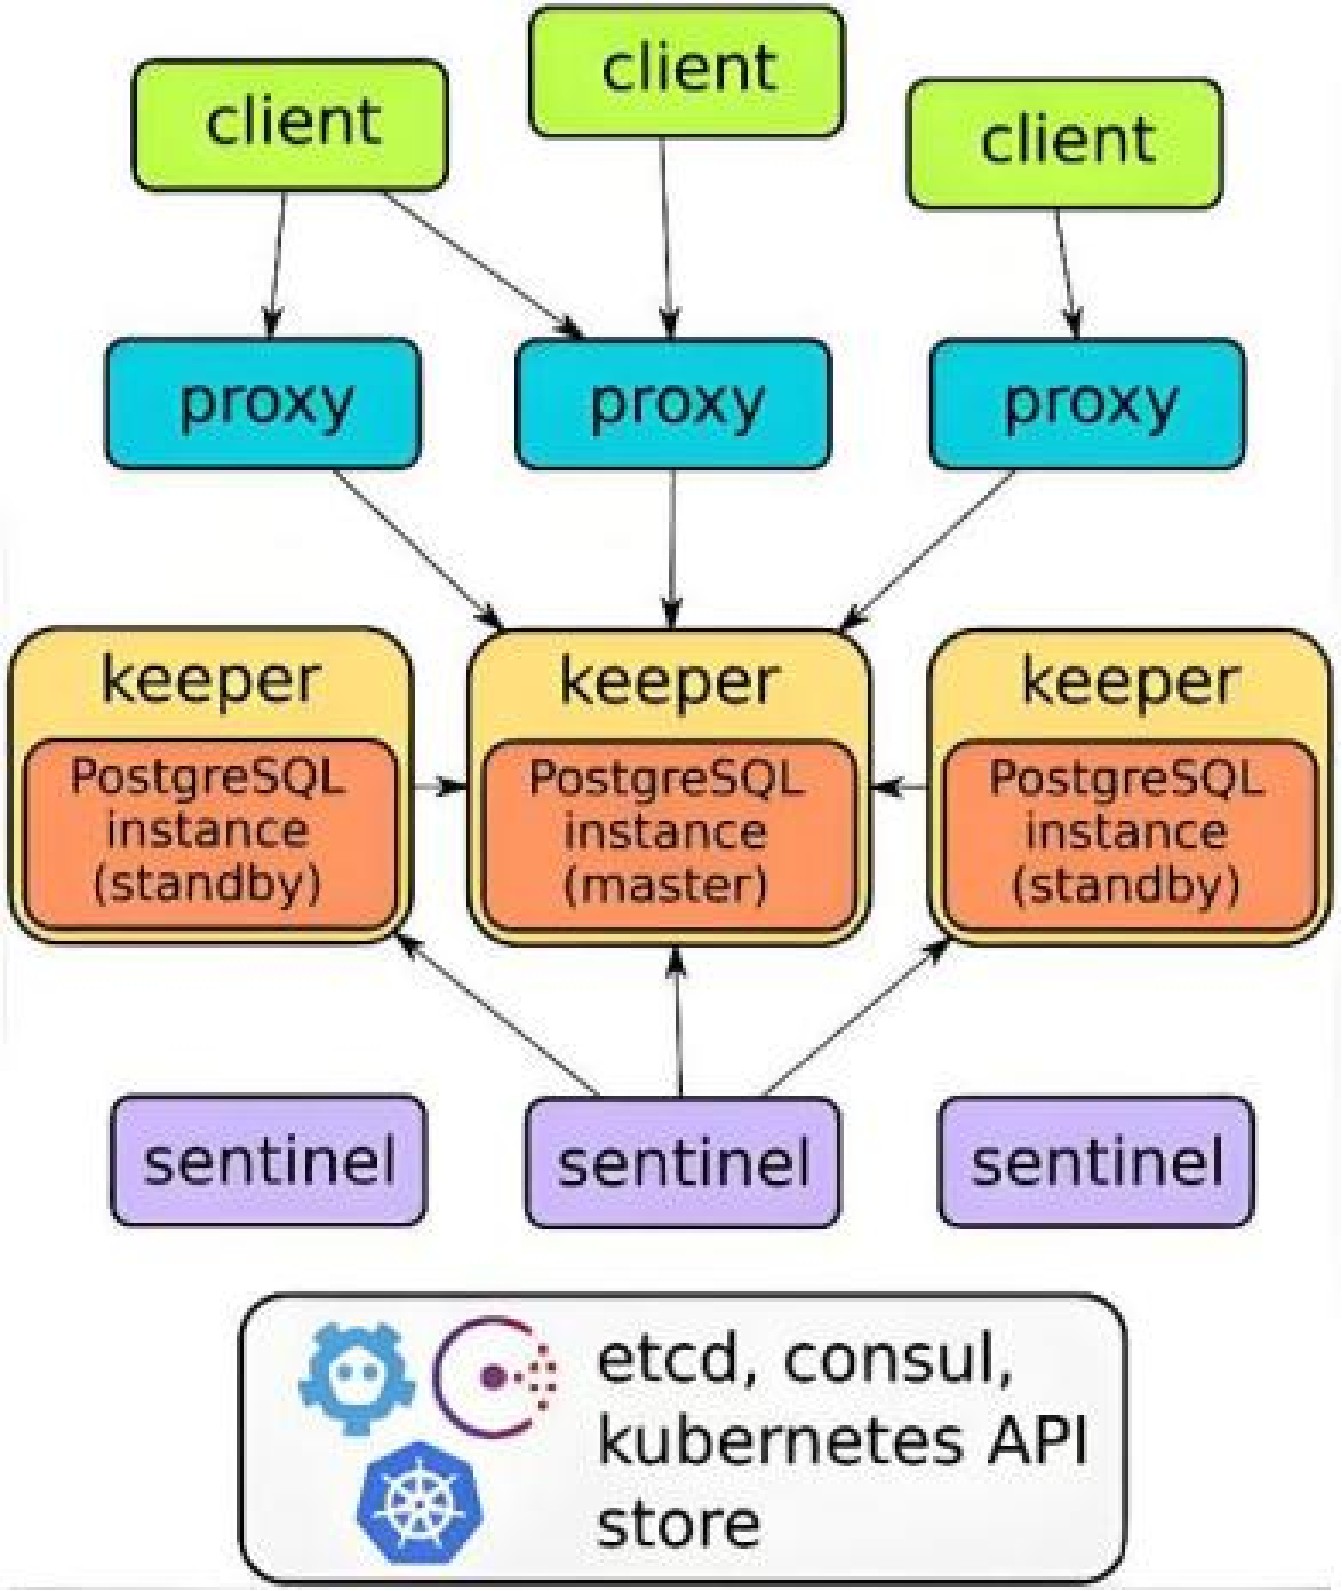
Stolon专为Kubernetes容器化环境设计,将集群管理逻辑与数据存储分离。
核心微服务架构:
- Proxy:客户端唯一入口,智能流量路由
- Keeper:管理本地PG实例生命周期
- Sentinel:监控集群,计算最优拓扑视图
优势:彻底解耦的云原生架构、客户端对故障切换完全无感知、控制平面无单点
挑战:引入Proxy层增加网络开销、组件较多架构复杂、社区活跃度相对有限
3.4 Pgpool-II —— 连接池与高可用中间件
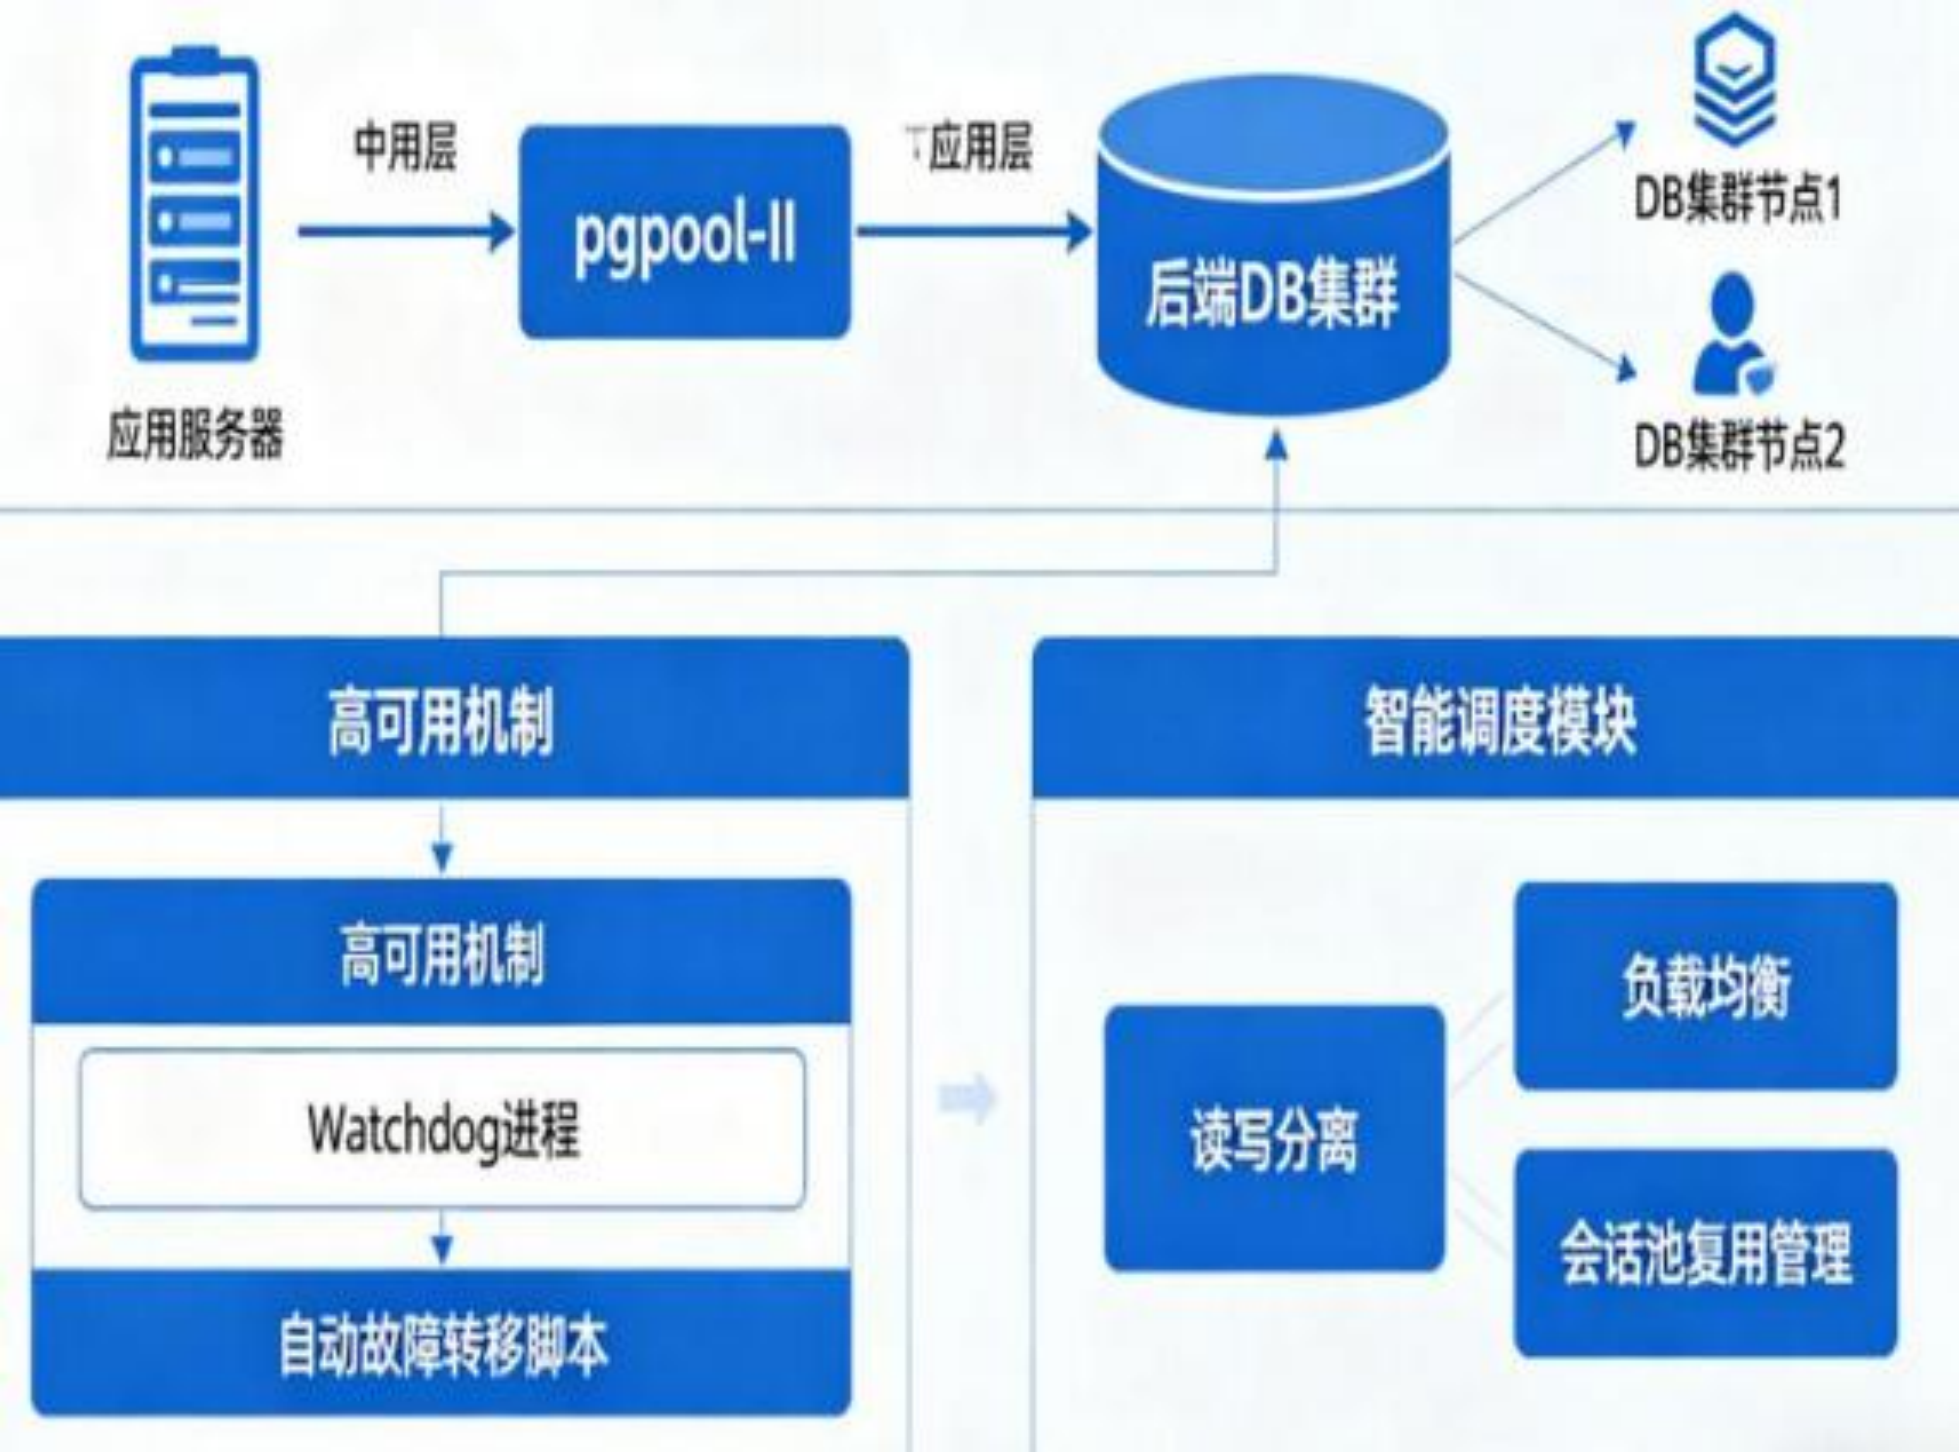
Pgpool-II是位于应用与PostgreSQL之间的代理层,提供连接池管理、负载均衡、自动故障转移等能力。
核心能力:
- 中间件路由:应用直连Pgpool-II,由其统一转发请求
- 高可用机制:配置Watchdog防止自身单点,通过脚本执行自动故障转移
- 智能调度:支持读写分离、负载均衡与会话池复用
优势:对应用透明、功能丰富、部署集成轻量化
局限:存在单点风险、故障转移依赖脚本、SQL解析较复杂
3.5 Pacemaker + Corosync —— 传统企业级集群方案
Pacemaker + Corosync是一套通用的开源集群资源管理器,通过脚本化的资源代理来管理PostgreSQL等各类服务。
核心组件:
- Corosync通信层:节点心跳检测与仲裁机制
- Pacemaker大脑:资源定义、监控与故障转移
- 资源代理:启停监控脚本
- STONITH防护:强制隔离脑裂节点
优势:高度灵活可定制、企业级稳定性强、成熟的仲裁与防脑裂机制
不足:配置极其复杂、自动化程度低、云原生适配不佳
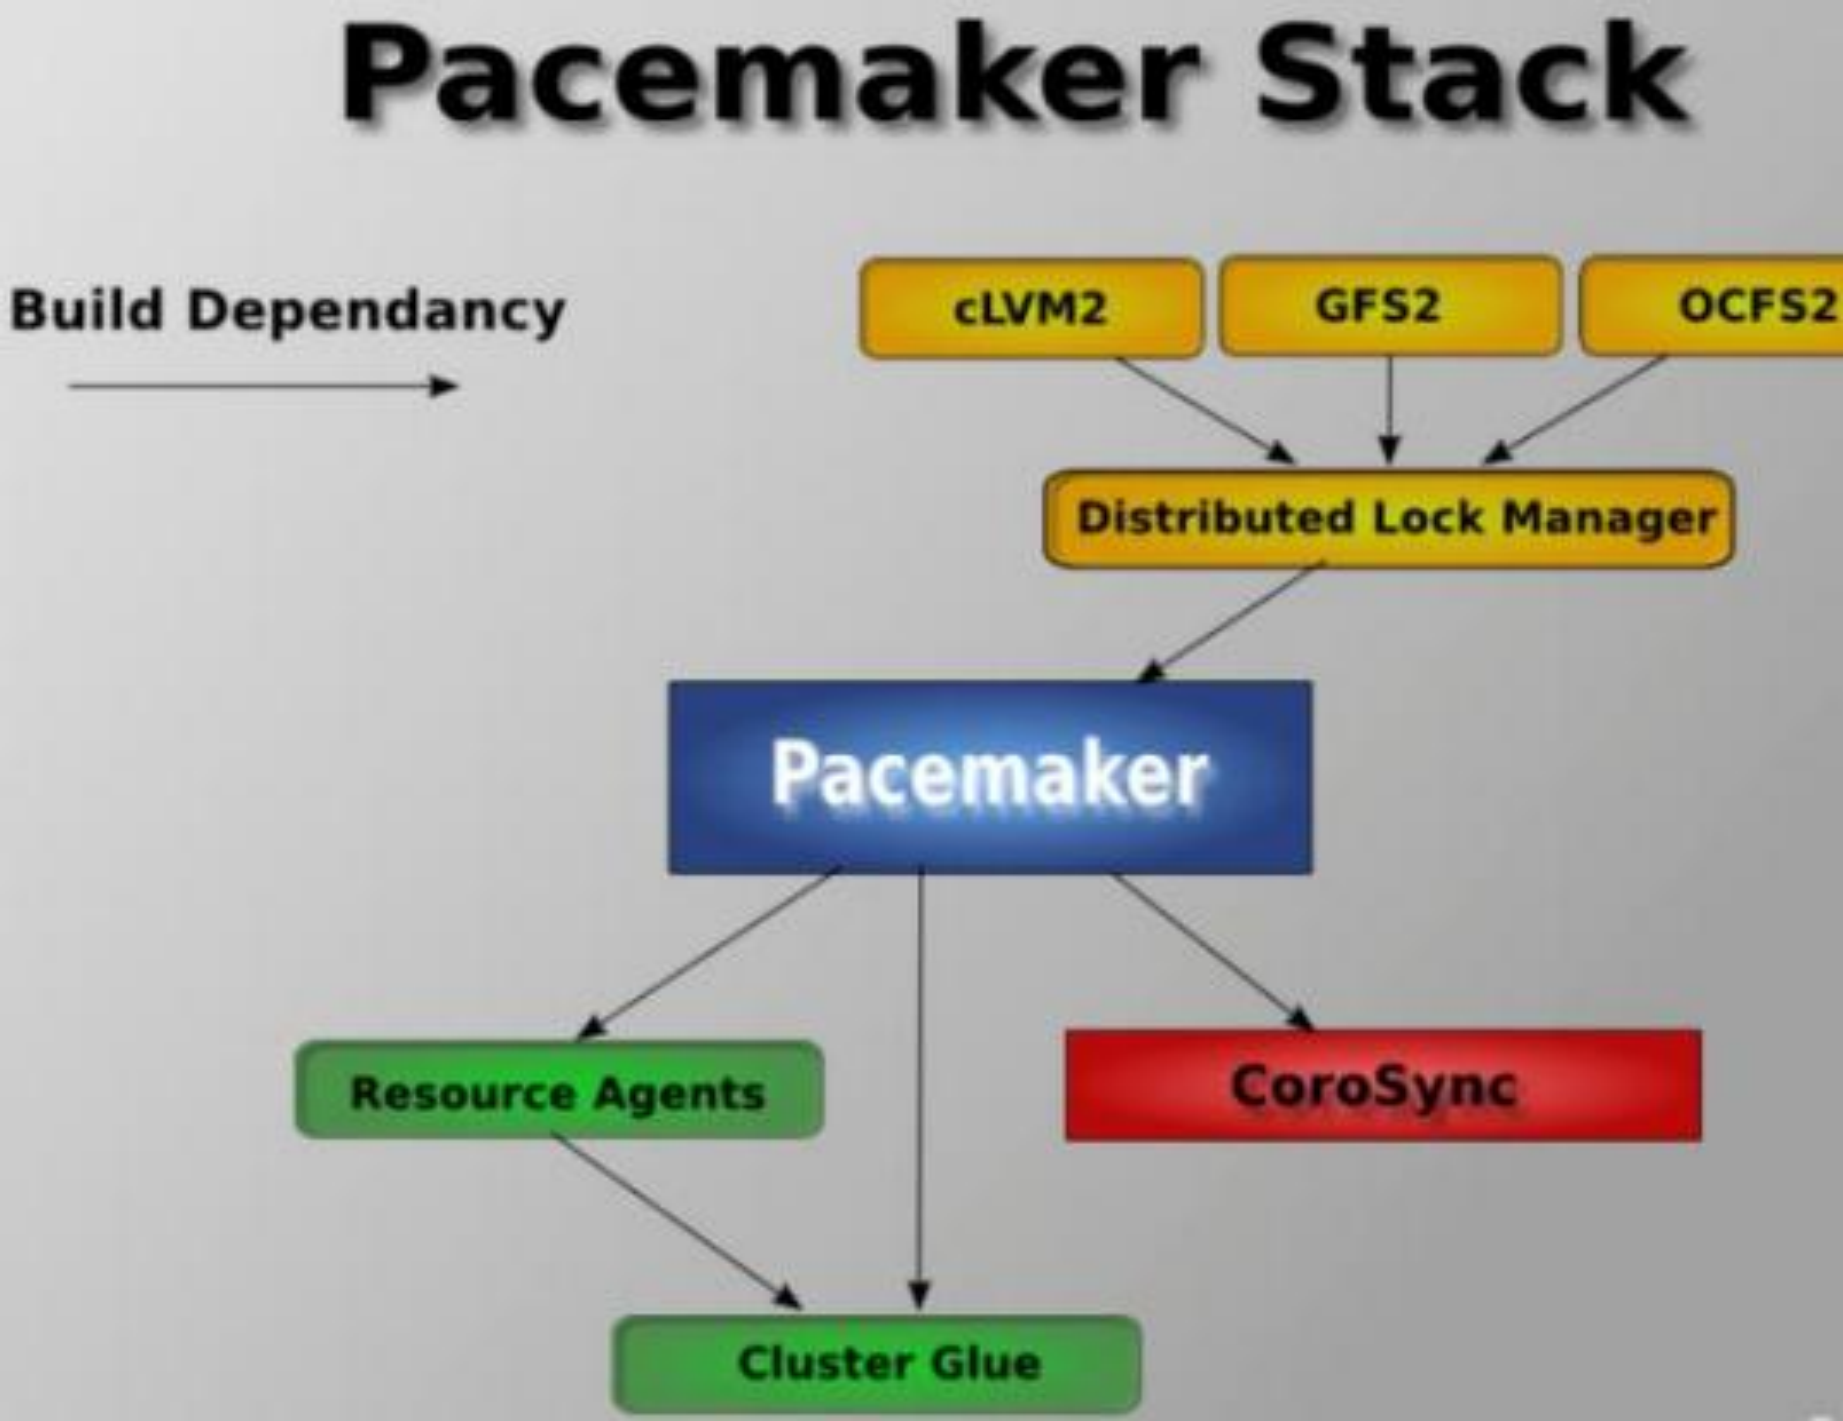
Pacemaker + Corosync 高可用架构示意
3.6 方案选型建议
首选推荐:Patroni
- 适用绝大多数场景,特别是云基础设施或容器化(K8s)环境
- 全链路自动化运维,RTO < 30秒,配合同步复制可实现RPO = 0
- GitHub星数领先,社区活跃,技术问题响应快
轻量级选择:repmgr
- 适用于中小规模集群,追求低学习成本和快速落地
- 在功能完备性与部署维护简单性之间取得良好平衡
云原生选择:Stolon
- 技术栈完全构建在Kubernetes之上,追求架构深度解耦的场景
综合代理:Pgpool-II
- 需要同时满足高可用、连接池管理和读写分离的复杂场景
- 建议作为前端代理层,配合Patroni或repmgr使用
谨慎选择:Pacemaker + Corosync
- 仅推荐在已广泛使用该方案的传统数据中心,或需要高度定制化管理的场景
- 对纯PG数据库场景,引入Pacemaker的高复杂度通常“得不偿失”
四、性能优化与监控体系
4.1 内存配置调优
| 参数 | 作用 | 建议值 |
|---|---|---|
| shared_buffers | 数据库缓存数据块的核心区域 | 物理内存的25%-50% |
| work_mem | 单SQL操作(排序、哈希连接)的临时内存 | 根据并发数调整,避免过大导致OOM |
| maintenance_work_mem | VACUUM、建索引等维护操作的内存 | 设较大值以加速维护任务 |
| effective_cache_size | 告知优化器可用的总缓存大小 | 物理内存的75% |
4.2 WAL与检查点调优
WAL和检查点的配置直接影响写入性能和稳定性:
| 参数 | 建议值 | 说明 |
|---|---|---|
wal_buffers |
16MB | WAL日志内存缓冲区 |
max_wal_size |
16GB – 32GB | 增大可减少检查点频率,避免IO突峰 |
min_wal_size |
8GB | 建议设为max_wal_size的一半 |
checkpoint_completion_target |
0.9 | 使IO操作更平滑 |
wal_writer_delay |
200ms | 高频写入场景可适当调小 |
核心思路:通过增大WAL容量和优化检查点参数,有效降低IO波动,提升系统吞吐量。
4.3 连接与并发调优
-
max_connections:根据资源合理设置,不宜过大 - 推荐使用 PgBouncer 连接池,减少频繁创建销毁连接的开销,防止连接数耗尽
4.4 监控体系:Prometheus + Grafana
推荐架构:
- Prometheus:开源时序数据库,负责指标采集与存储
- pg_exporter:PostgreSQL指标导出器
- Grafana:数据可视化,构建直观仪表盘
核心监控指标:
- 连接与会话:活跃连接数、最大连接数使用率
- 复制状态:主从延迟、复制槽状态
- 性能与资源:QPS/TPS、慢查询、CPU/内存/IO负载
关键复制监控SQL:
SELECT pid, application_name, client_addr, state, sync_state,
pg_wal_lsn_diff(pg_current_wal_lsn(), replay_lsn) AS total_lagFROM pg_stat_replication;
当
total_lag超过阈值(如1GB)时,应立即触发告警并排查。
五、故障处理与应急响应
5.1 故障诊断四步法
- 观察现象,收集信息:检查应用层报错、数据库集群状态、系统资源、相关日志
- 分析原因,定位问题:综合判断是网络故障、硬件问题还是配置错误
- 制定方案,实施恢复:针对性处理,操作前务必做好数据备份
- 总结复盘,优化改进:分析根本原因,更新应急预案
5.2 常见故障(一):复制延迟过大
现象:备库LSN与主库差距持续增大,数据严重滞后
常见原因:
- 主库写入负载过高,产生WAL过快
- 备库CPU/内存/IO性能不足
- 主备间网络带宽瓶颈
- 备库存在长事务阻塞重放
解决方案:优化主库写入或升级备库硬件、扩容网络带宽、终止阻塞的长事务
5.3 常见故障(二):复制中断
现象:
pg_stat_replication中无备库连接信息,备库日志出现连接错误
常见原因:
- 网络中断或防火墙阻断
- 复制用户权限/密码错误
- WAL日志被清理(无复制槽保护)
- 备库磁盘空间不足
解决方案:修复网络/防火墙、修正权限配置、 配置复制槽是防止主库过早清理WAL的最有效手段
5.4 常见故障(三):自动切换失败
现象:主库宕机后备库未自动提升,集群服务中断
常见原因:
- Patroni/repmgrd进程异常
- DCS集群(etcd/Consul)不可用,无法选举
- 备库数据延迟超过故障转移阈值
- 配置文件错误或权限不足
解决方案:检查进程状态和日志、修复DCS集群、手动提升备库或重建
5.5 常见故障(四):脑裂
现象:网络分区导致多节点同时为主库,各自接受写入,数据严重不一致
预防措施:
- 部署至少3个节点或Witness,利用多数派原则
- 使用Patroni/Stolon等基于DCS的共识方案
- 共享存储场景下,使用STONITH强制隔离旧主节点
应急处理:
- 立即断开所有疑似主节点与应用连接
- 比对数据,确认拥有最新完整数据的节点
- 强制指定新主库,其他节点同步
- 恢复服务并复盘分析网络原因
六、总结与展望
6.1 核心要点总结
| 维度 | 要点 |
|---|---|
| 方案选型是基础 | 根据业务规模与一致性要求选择方案,物理复制是主流技术 |
| 架构设计是关键 | 兼顾一致性、故障检测与脑裂防护,引入负载均衡实现无感知切换 |
| 性能优化是保障 | 从内存、WAL、连接等维度调优 |
| 监控运维是核心 | 建立全链路监控告警体系,制定详细故障处理流程 |
| 持续演练是保障 | 定期进行故障切换与应急演练,提升团队实战能力 |
6.2 未来趋势
- AI运维集成:利用机器学习实现故障预测与性能瓶颈自动识别,从被动响应转向主动预防
- 云原生与Service Mesh深度整合:在K8s环境中与Istio等融合,提供细粒度流量控制与全链路可观测性
- 多主架构与分布式SQL演进:依托Citus等扩展向分布式发展,突破单主瓶颈
- 新硬件应用:利用NVMe SSD、RDMA提升性能
- Serverless化:按需创建、自动扩缩容,大幅降低运维成本
未来,PostgreSQL将更加智能、高效且云原生,通过技术整合与架构升级,持续重新定义数据库高可用标准。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70043484/viewspace-3183479/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 关系型数据库在 AI 战场:从语义搜索到 RAG 的实战指南
- PostgreSQL 日报|堆表选择性索引更新(10 月 13 日)
- IvorySQL 5.6 RISC-V 实测:零补丁编译,468 项回归测试全过
- PostgreSQL 日报|逻辑解码 DDL 子事务缺陷修复(10 月 12 日)
- PGConf.Asia 2026 议程公布!53 场技术分享,11 月相约香港
- PostgreSQL 日报| PostgreSQL JDBC 安全更新(10 月 10 日)
- 从轮询到等待——PostgreSQL WAIT FOR LSN 特性深度解析
- PostgreSQL 日报|修复截断 zstd 备份检测(10 月 9 日)
- VACUUM FULL 之后 ROWID 就废了? IvorySQL 兼容性实测
- PostgreSQL 日报|原生 BM25 全文搜索索引(10 月 8 日)
