Postgres 19 REPACK:更快、内置的表膨胀清理方案
REPACK 是我在 Postgres 19 中最喜欢的功能。它不是最炫酷的,但如果你在跑生产数据库,它是最重要的那个。Vacuum、autovacuum 和表膨胀一直是 Postgres 用户的痛点。一方面,Postgres 的 MVCC 设计并不新鲜。但在高更新系统中,死行不断产生、后续被释放,vacuum 需要调到合适的级别来维持低膨胀,这仍然是一门不太精确的科学。
一旦膨胀存在,它就摆在那里。你会看到那些未被回收的空间没有被使用。
在 Postgres 19 之前,回收这些空间的选择有:
- VACUUM FULL:内置,但在整个执行期间持有读写锁。在大表上,这意味着数分钟的停机。
- dump/restore:切换到一份干净快照的新数据库。
- pg_repack:第三方扩展,通过外部进程实现在线重建。通常是个好选择,但并非没有注意事项和风险。
- pg_squeeze:另一个第三方扩展,通过后台 worker 实现在线重建,在生产环境中也很可靠,但同样并非没有注意事项和风险。
Postgres 19 来了:
- REPACK CONCURRENTLY:在表保持完全可读可写的情况下回收膨胀的表空间,仅在最后短暂持锁,且无需任何扩展。
Postgres 表是如何膨胀的
让我们从头说起。作为资深 Postgres 用户,你可能对膨胀很熟悉,但为了确保大家理解一致……这是 Postgres 的现实之一,是 MVCC 的代价。表随时间累积死元组:当行被更新或删除时,旧版本会保留下来。常规 autovacuum 通常会将那部分空间标记为可复用。对大多数表来说,这就够了。但对于大型、更新密集的表,vacuum 可能跟不上。死行累积形成表膨胀。文件在增长,但由于 VACUUM 只能将空间标记为内部可复用,它不会收缩表或将空间返还给操作系统。要真正回收磁盘空间,你需要重建表。
如何判断是否有膨胀问题?你可以用 pg_stat_user_tables 做快速检查。元组计数是估算值,但这是一个很好的诊断信号。
SELECT
    schemaname,
    relname,
    pg_size_pretty(pg_relation_size(schemaname || '.' || relname)) AS size,
    n_live_tup,
    n_dead_tup,
    CASE WHEN n_live_tup > 0
         THEN round((n_dead_tup::float / n_live_tup::float)::numeric, 4)
    END AS dead_tup_ratio,
    last_autovacuum,
    last_autoanalyze
FROM pg_stat_user_tables
ORDER BY dead_tup_ratio DESC NULLS LAST;
一个粗略的经验法则:
膨胀率低于 50%:通常可以接受。监控它并检查 autovacuum 设置,但不需要紧急处理。
膨胀率高于 50%:你可能在浪费磁盘空间,并因额外的页面读取而付出性能代价。至少值得调查——如果看到慢查询或表大小增长,可能需要处理。
没有单一的膨胀百分比能决定一个表是否需要关注。要考虑浪费的字节数、工作负载、增长速度,以及回收空间是否值得重写。
pg_repack 的工作原理
pg_repack 扩展多年来一直是在线表重建的选择。它的工作方式如下:
- 外部工具:pg_repack 作为命令行工具运行(pg_repack --table my_table -d mydb),从外部服务器或管理主机执行。你需要在 Postgres 内安装扩展(CREATE EXTENSION pg_repack),并在运行它的机器上安装客户端二进制文件。
- 基于触发器的变更捕获:它创建一个日志表,并在目标表上安装触发器,以捕获重建期间的所有 INSERT/UPDATE/DELETE 操作。这在操作期间为每次写入增加了触发器开销。
- 影子表方案:它创建表的新副本,从原表填充数据,重放触发器日志,然后进行短暂的锁换,以及最终的表重命名。
这套方案效果很好,许多生产系统依赖它多年。但安装第三方扩展让一些团队感到不安,外部二进制文件也增加了运维开销。
pg_squeeze 的工作原理
pg_squeeze(来自 CYBERTEC,也是 Postgres 19 REPACK 大部分工作的幕后团队)采用了更现代的方法。它也在生产环境中得到了广泛使用。
- 逻辑解码:pg_squeeze 使用 Postgres 基于 WAL 的逻辑解码来捕获并发变更。这意味着不在表上安装触发器。这与 PG 19 内置 REPACK (CONCURRENTLY) 现在使用的方法相同。
- 后台 worker:它完全在数据库内作为后台 worker 进程运行,这意味着与 pg_repack 不同,你不需要外部 CLI 工具。你还可以配置它在膨胀超过阈值时自动运行。
- 仍然是扩展:很多人更喜欢内置选项,但这仍然需要 wal_level = logical、复制槽、编译和安装扩展,以及将其添加到 shared_preload_libraries。
pg_squeeze 在某种意义上就是 PG 19 REPACK (CONCURRENTLY) 的原型。内置版本继承了逻辑解码方法,但直接集成到服务器中,无需扩展、shared_preload_libraries 或单独的配置表。
REPACK 登场
Postgres 19 将 REPACK 添加为一等 SQL 命令,有三种模式:
-- 基本 repack,类似 VACUUM FULL —— 持有 ACCESS EXCLUSIVE 锁
REPACK my_table;
-- 在线 repack,使用 CONCURRENTLY,就像索引一样
REPACK (CONCURRENTLY) my_table;
-- 在线 repack + 按索引重排序
REPACK (CONCURRENTLY) my_table USING INDEX my_index;
REPACK (CONCURRENTLY)
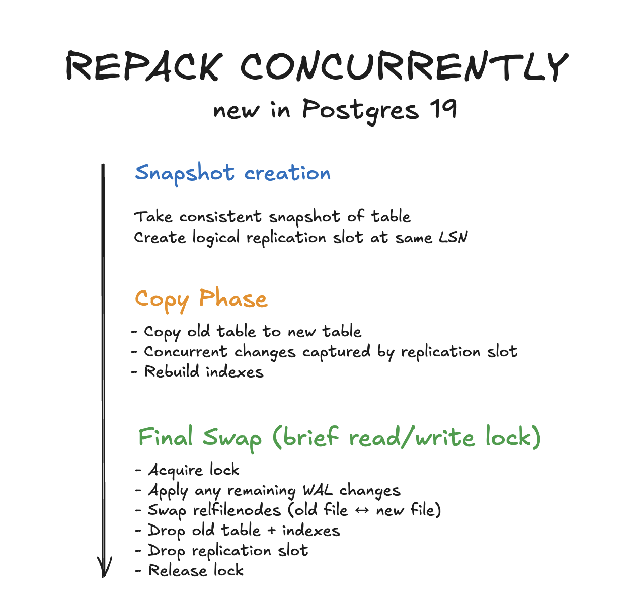
这是让该功能达到生产就绪的关键。使用 CONCURRENTLY 时,ACCESS EXCLUSIVE 锁仅在最后短暂持有。在操作的大部分时间里——对大表可能是数分钟——表保持完全可读可写。
内部发生的过程如下:
REPACK (CONCURRENTLY, VERBOSE, ANALYZE) repack_test;
INFO:  repacking "public.repack_test" in physical order
INFO:  "public.repack_test": found 0 removable, 1000000 nonremovable
       row versions in 38452 pages
Time: 9406.788 ms (00:09.407)
Before: 493 MB → After: 228 MB (54% reduction)
这里有三个选项:
- CONCURRENTLY:在线重建,仅在最后进行文件交换时短暂持有排他锁。
- VERBOSE:以 INFO 级别打印进度。
- ANALYZE:在 repack 完成后运行 ANALYZE 以更新规划器统计信息。
使用 USING INDEX 的 REPACK
REPACK 还可以物理重排表的行以匹配索引。如果你的工作负载频繁读取相关行的范围,使用 USING INDEX 进行聚簇可能改善局部性。在自己的查询上测量效果;后续更新不会自动聚簇。
这对 REPACK 功能来说意义重大,不仅仅是消除膨胀。它本身就是一个性能特性。例如,假设你有一个 orders 表,经常查询 WHERE created_at BETWEEN ‘2026-01-01’ AND ‘2026-01-31’。没有物理排序时,这些行可能分散在数百个页面中。使用 REPACK orders USING INDEX idx_orders_created_at 后,行按日期顺序在磁盘上连续存储,因此范围扫描按顺序读取页面,而不是在整个表上进行随机 I/O。
你可能从旧版 Postgres 知道 CLUSTER。它做同样的事情,但会持锁。
REPACK (VERBOSE, ANALYZE) product_inventory USING INDEX idx_product_category;
INFO:  repacking "public.product_inventory" using index scan
       on "idx_product_category"
Time: 15230.264 ms (00:15.230)
Before: 618 MB → After: 320 MB (48% reduction, rows now ordered by category)
REPACK vs. VACUUM FULL 性能对比
我做了一些测试来验证效果。对于 493 MB 的测试用例,原始 200 万行删除 100 万行后剩余 100 万活行,报告的时间为:
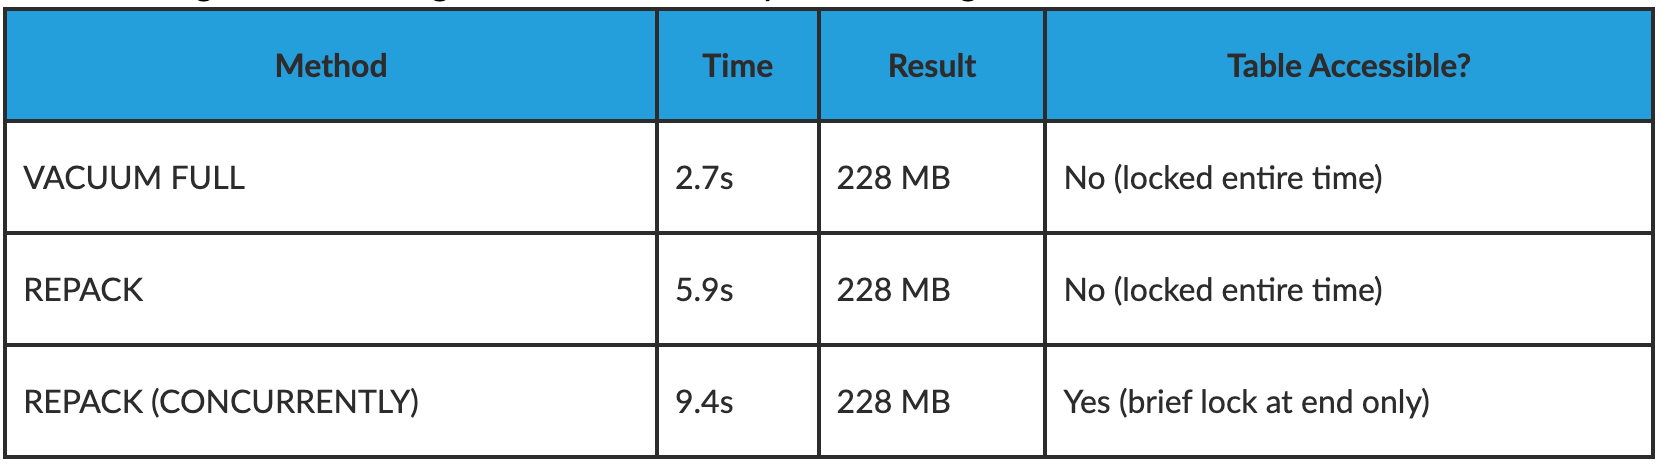
在受限系统上的一次测试中,REPACK (CONCURRENTLY) 在所述表和测试条件下耗时 9.4 秒。结果因表、索引、工作负载和硬件而异。
REPACK CONCURRENTLY 的墙钟时间更慢。它在做更多工作:在表重建之上还有逻辑解码和 WAL 重放。这里的权衡是用更多时间换取表保持在线。
REPACK CONCURRENTLY 的要求
- 需要被 repack 的表和索引 2 倍的空间,因为在一段时间内会有两份副本。
- 表必须记录 WAL,不能是 UNLOGGED。
- 表不能是分区表。
- 表必须有一个可索引的主键。
- 表不能是系统目录或 TOAST 表。
- 每个数据库同时只能运行一个并发 REPACK。
- 不支持使用非堆访问方法的表。
关于 MVCC 安全性的说明:REPACK CONCURRENTLY 并非完全 MVCC 安全。在最后的短暂交换期间,长时间运行的事务理论上可能错过并发变更。使用 repack 开始前所拍快照的并发事务可能看到表为空。这与 pg_repack 原有的限制相同,已记录在 Postgres 19 发布说明中。请根据工作负载的事务和一致性要求审查此行为。
何时使用 REPACK vs. VACUUM
常规 VACUUM 和 REPACK 解决不同的问题:
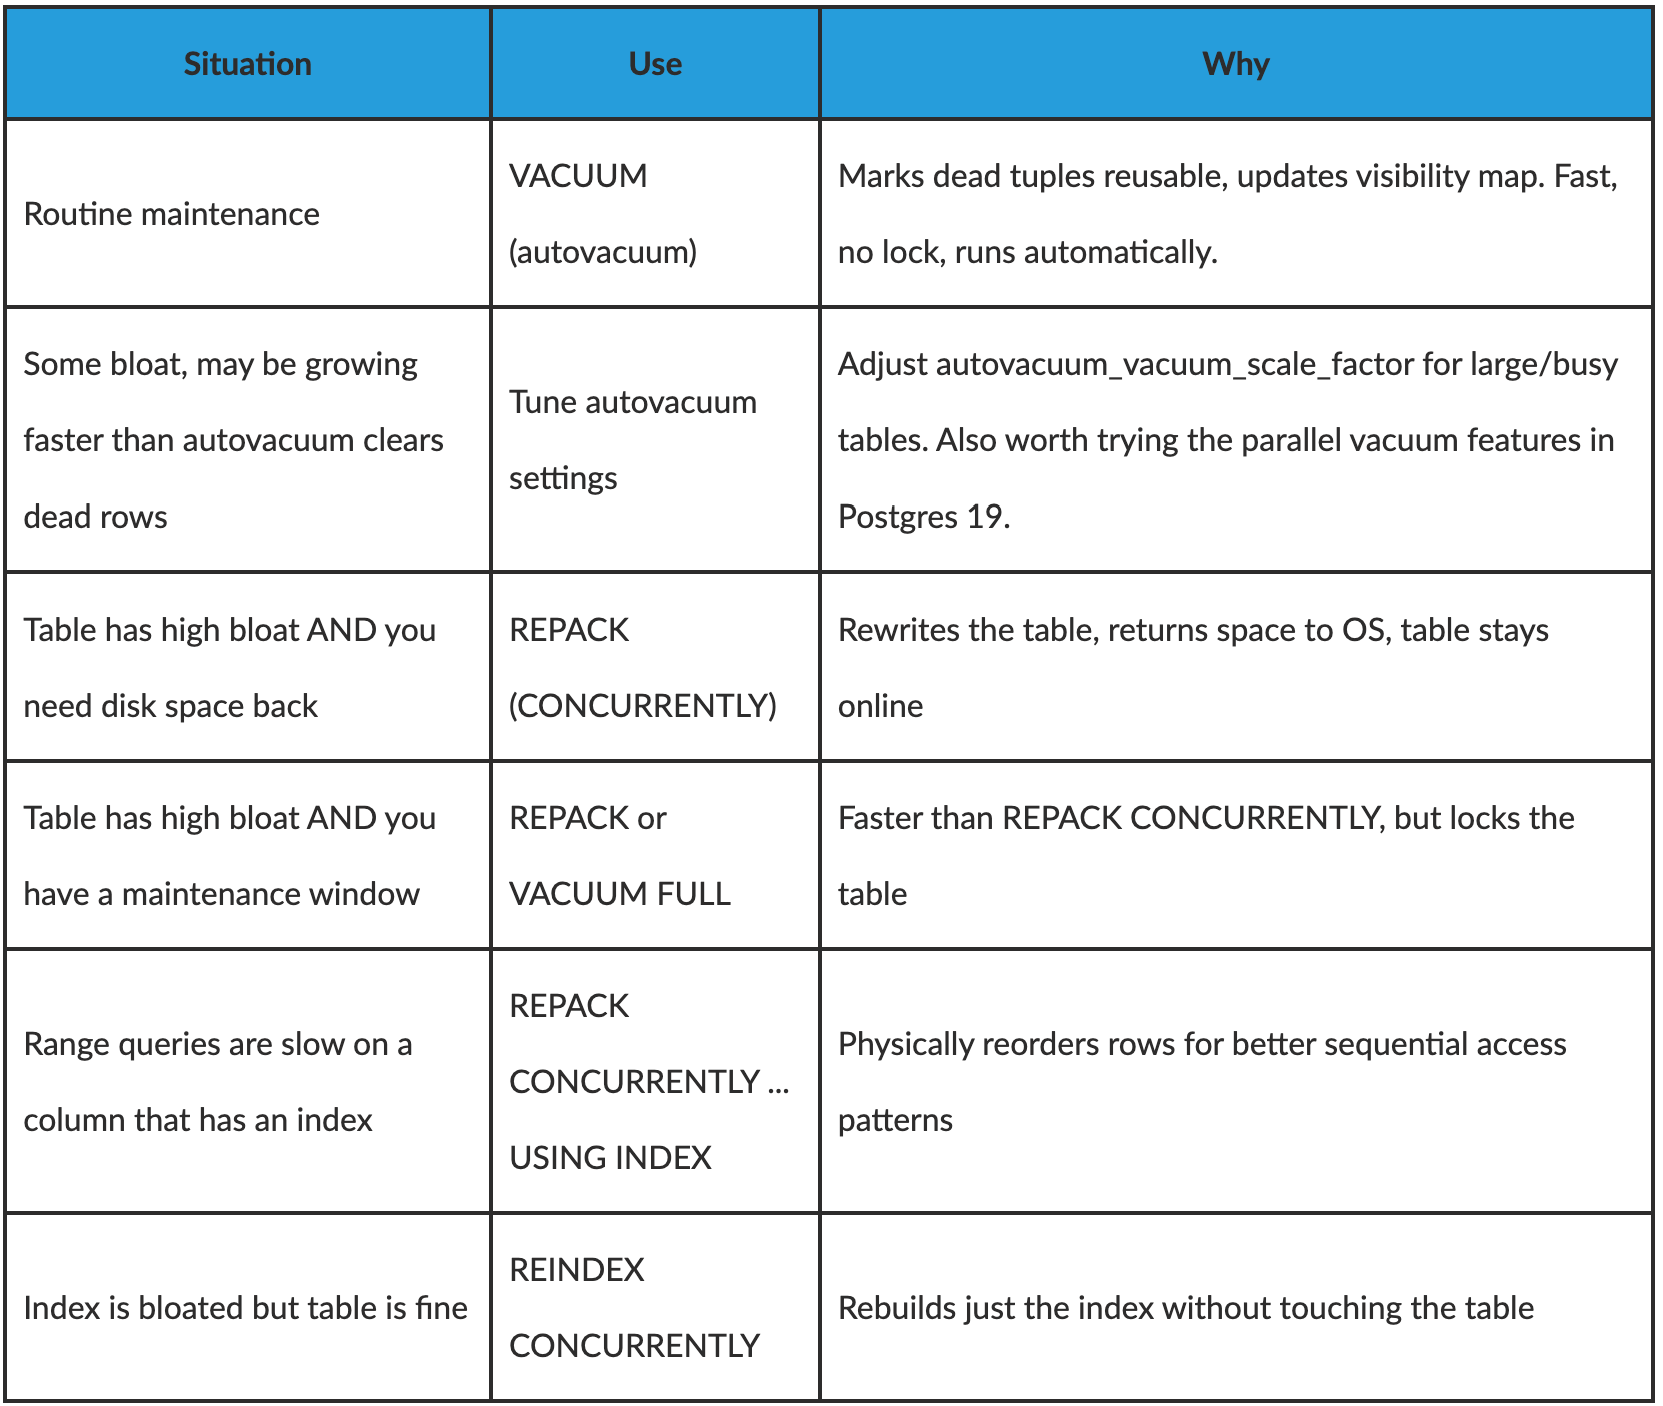
经验法则:autovacuum 处理日常维护。REPACK 用于需要将空间回收给操作系统或物理重排数据的时候——这些是常规 VACUUM 从根本上无法做到的。
估算 REPACK 需要多长时间
REPACK 时间随表大小、索引数量和可用 I/O 扩展。一个粗略模型:
REPACK time ≈ (time to read entire table) + (time to write new copy) + (time to rebuild all indexes)
你可以在运行 REPACK 之前估算:
-- 需要重写的表 + 索引有多大?
SELECT
    pg_size_pretty(pg_relation_size(relid)) AS table_data,
    pg_size_pretty(pg_indexes_size(relid)) AS all_indexes,
    pg_size_pretty(pg_total_relation_size(relid)) AS total,
    n_live_tup AS rows_to_copy
FROM pg_stat_user_tables
WHERE relname = 'my_table';
在受限系统(1 CPU、512 MB、4 MB maintenance_work_mem)上的测试:
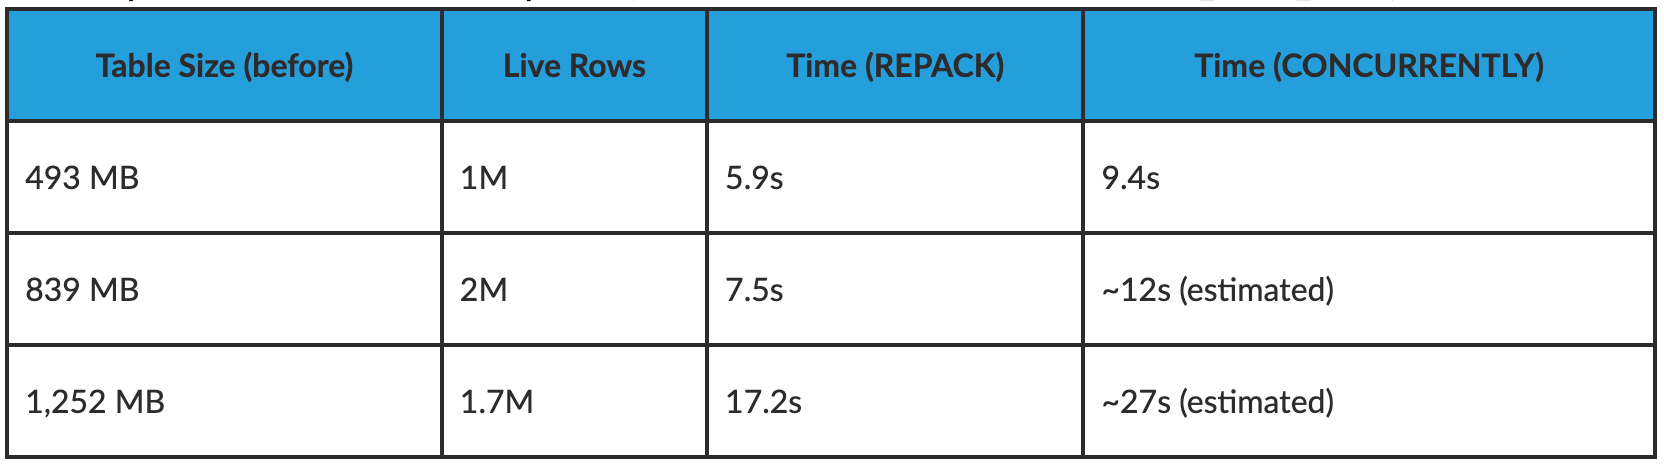
CONCURRENTLY 开销大约是基本 REPACK 时间的 1.5 到 2 倍,因为它需要设置逻辑解码并重放任何并发变更。在具有快速 NVMe 和更多 CPU 的真实生产服务器上,这些时间会显著降低,但比例保持不变。
对于非常大的表(100+ GB),预计 REPACK 需要数分钟到数十分钟。相应规划,并使用 pg_stat_progress_repack 监控。
监控 REPACK 进度
REPACK 运行时,从另一个会话查询 pg_stat_progress_repack:
SELECT
    pid,
    datname,
    relid::regclass AS table_name,
    command,
    phase,
    heap_tuples_scanned,
    heap_tuples_inserted,
    heap_blks_total,
    heap_blks_scanned,
    index_rebuild_count
FROM pg_stat_progress_repack;
你会看到的阶段进展:
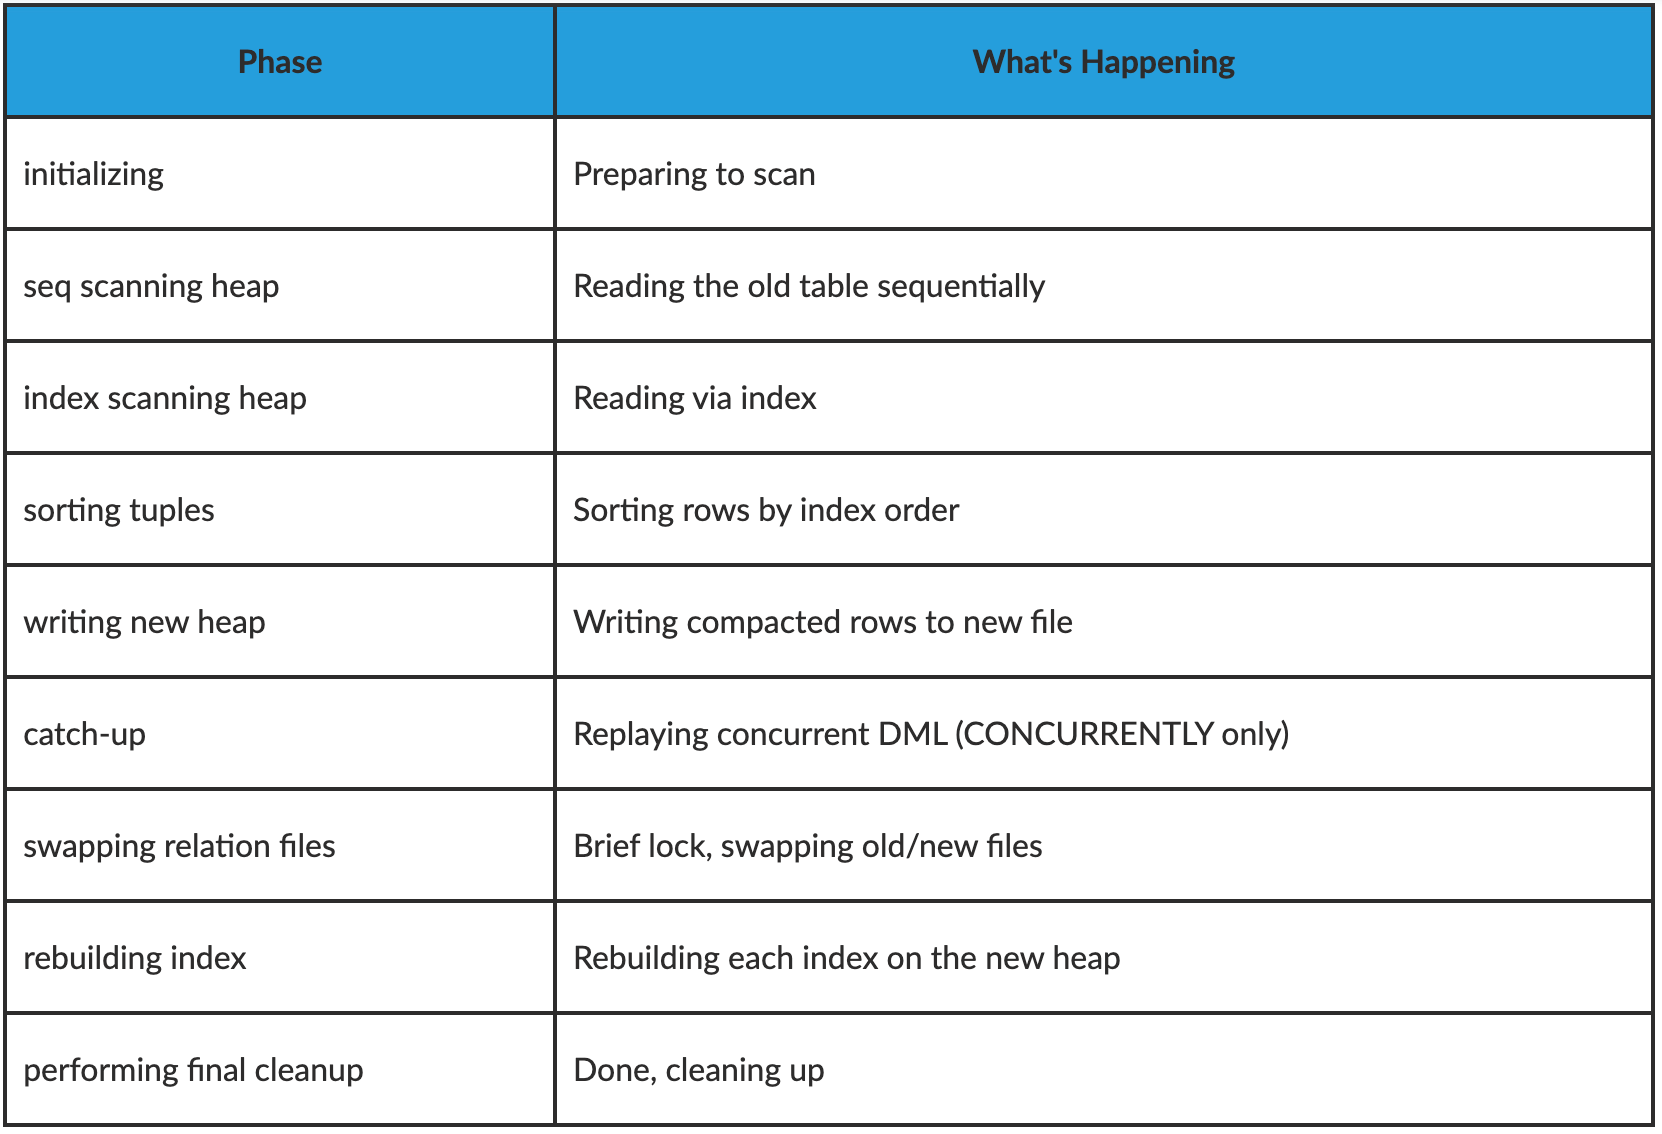
你可以在扫描阶段估算完成百分比:
SELECT
    phase,
    heap_blks_scanned,
    heap_blks_total,
    CASE WHEN heap_blks_total > 0
         THEN round(100.0 * heap_blks_scanned / heap_blks_total, 1)
    END AS pct_complete
FROM pg_stat_progress_repack;
REPACK CONCURRENTLY 是 Postgres 19 中最重要的面向 DBA 的功能。它将在线表重建带入核心,在大多数情况下消除了对 pg_repack 的需求,并提供了比长期以来存在的 VACUUM FULL / CLUSTER 二分法更清晰的接口。如果你在生产中管理有显著膨胀的表,这就是你升级的理由。
Postgres 19 目前有第一个候选版本(RC1),预计 RC2 于 11 月 12 日发布,GA 预计在 2026 年 11 月/12 月晚些时候。如果你想今天就试试 REPACK,启动一个 beta 实例,看看它在你最膨胀的表上表现如何。
本文作者:Craig Kerstiens
原文链接:https://www.snowflake.com/en/blog/engineering/postgres-19-repack-table-bloat/
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70043484/viewspace-3188618/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- PostgreSQL 19 将是一个质量优良的新版本
- PostgreSQL 日报|安全更新修复 52 个 CVE(11 月 13 日)
- 主库断电、断网、打补丁 —— 这些平时不敢试的,11 月 14 日 GOTC 现场一次跑完
- PostgreSQL 日报| glibc 升级可静默损坏索引(11 月 12 日)
- PostgreSQL 日报|CloudNativePG 晋级 CNCF 孵化(11 月 11 日)
- 从异构数据库到 PostgreSQL 的逻辑复制:开源扩展 SynchDB 的设计与实践
- PostgreSQL 日报|分区并发分离未完成引发崩溃(11 月 10 日)
- PG18 索引与查询特性在 IvorySQL5.6 上的实测
- PostgreSQL 日报| OAuth 校验库置空仍可登录(11 月 9 日)
- PostgreSQL 日报|PG 19 发布公告草稿(11 月 8 日)
