点关注,不迷路!
1.kafka简介

Kafka是最初由Linkedin公司开发,是一个分布式、支持分区的(partition)、多副本的(replica),基于zookeeper协调的分布式消息系统,它的最大的特性就是可以实时的处理大量数据以满足各种需求场景:比如基于hadoop的批处理系统、低延迟的实时系统、Storm/Spark流式处理引擎,web/nginx日志、访问日志,消息服务等等,用scala语言编写,Linkedin于2010年贡献给了Apache基金会并成为顶级开源 项目。
优势:
高吞吐量、低延迟:kafka每秒可以处理几十万条消息,它的延迟最低只有几毫秒;
可扩展性:kafka集群支持热扩展;
持久性、可靠性:消息被持久化到本地磁盘,并且支持数据备份防止数据丢失;
容错性:允许集群中节点故障(若副本数量为n,则允许n-1个节点故障);
高并发:支持数千个客户端同时读写。
版本演进
Kafka 0.8 之后引入了副本机制, Kafka 成为了一个分布式高可靠消息队列解决方案。
0.8.2.0 版本社区引入了新版本 Producer API , 需要指定 Broker 地址,但是bug比较多
0.9.0.0 版本增加了基础的安全认证 / 权限功能,同时使用 Java 重写了新版本 Consumer API ,还引入了 Kafka Connect 组件用于实现高性能的数据抽取,同样也是bug多
0.10.0.0 是里程碑式的大版本,因为该版本引入了 Kafka Streams。从这个版本起,Kafka 正式升级成分布式流处理平台
0.11.0.0 版本,引入了两个重量级的功能变更:一个是提供幂等性 Producer API 以及事务(Transaction) API ;另一个是对 Kafka 消息格式做了重构。
1.0和2.0 主要是对Kafka Streams 的各种改进,在消息引擎方面并未引入太多的重大功能特性
1.0中文文档:http://kafka.apachecn.org/documentation.html#introduction
1.1文档:http://kafka.apache.org/11/documentation.html
术语
Record(消息):Kafka 处理的主要对象。
Topic(主题):主题是承载消息的逻辑容器,在实际使用中多用来区分具体的业务。Kafka中的Topics总是多订阅者模式,一个topic可以拥有一个或者多个消费者来订阅它的数据。
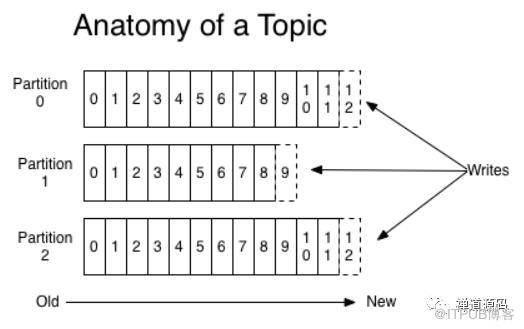
Partition(分区):一个有序不变的消息序列。每个Topic下可以有多个分区。
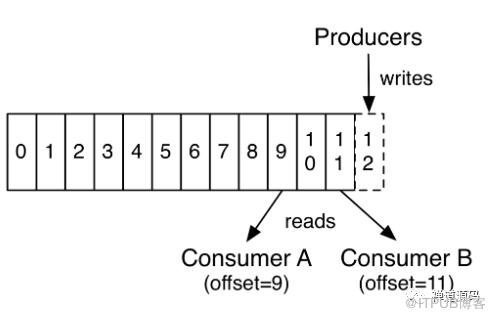
Offset(消息位移):表示分区中每条消息的位置信息,是一个单调递增且不变的值。
Replica(副本):Kafka 中同一条消息能够被拷贝到多个地方以提供数据冗余,这些地方就是所谓的副本。副本还分为领导者(leader)副本和追随者(follower)副本,各自有不同的角色划分。副本是在分区层级下的,即每个分区可配置多个副本实现高可用。
Broker(代理):Kafka以集群的方式运行,集群中的每一台服务器称之为一个代理(broker)
Producer(生产者):消息生产者,向Broker发送消息的客户端。
Consumer(消费者):消息消费者,从Broker读取消息的客户端。
Consumer Offset(消费者位移):表征消费者消费进度,每个消费者都有自己的消费者位移。
Consumer Group(消费者组):每个Consumer属于一个特定的Consumer Group,一条消息可以被多个不同的 Consumer Group消费,但是一个 Consumer Group中只能有一个Consumer 能够消费该消息。
每一个Topic,下面可以有多个分区(Partition)日志文件 。Partition是一个有序的message序列,这些message按顺序添加到一个叫做commit log的文件中。每个partition中的消息都有一个唯一的编号,称之为offset,用来唯一标示某个分区中的message。每个consumer是基于自己在commit log中的消费进度(offset)来进行工作的。在kafka中,消费offset由consumer自己来维护;一般情况下我们按照顺序逐条消费commit log中的消息,当然我可以通过指定offset来重复消费某些消息,或者跳过某些消息。
传统的消息传递模式有2种:队列( queue) 和(publish-subscribe)
queue模式:多个consumer从服务器中读取数据,消息只会到达一个consumer。
publish-subscribe模式:消息会被广播给所有的consumer。
Kafka基于这2种模式提供了一种consumer的抽象概念:consumer group。
queue模式:所有的consumer都位于同一个consumer group 下。
publish-subscribe模式:所有的consumer都有着自己唯一的consumer group。
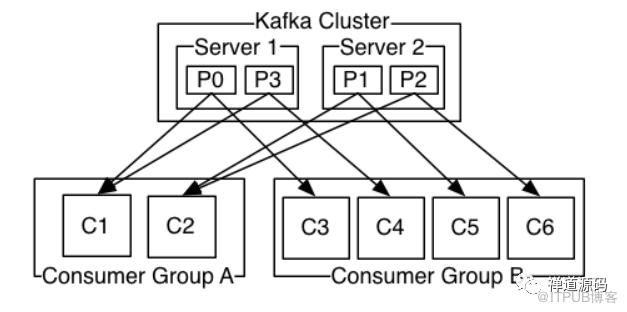
架构图


应用场景
它可以用于两大类别的应用:
构造实时流数据管道,它可以在系统或应用之间可靠地获取数据。(相当于message queue)
构建实时流式应用程序,对这些流数据进行转换或者影响。(就是流处理,通过kafka stream topic和topic之间内部进行变化)
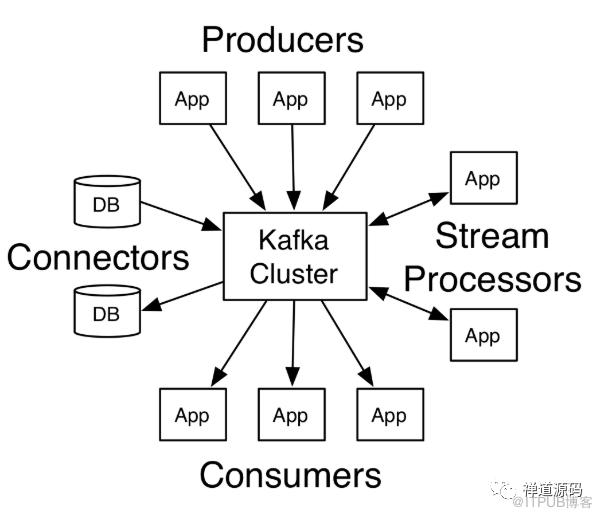
日志收集:用Kafka可以收集各种服务的log,通过kafka以统一接口服务的方式开放给各种consumer;
消息系统:解耦生产者和消费者、缓存消息等;
用户活动跟踪:kafka经常被用来记录web用户或者app用户的各种活动,如浏览网页、搜索、点击等活动,这些活动信息被各个服务器发布到kafka的topic中,然后消费者通过订阅这些topic来做实时的监控分析,亦可保存到数据库;
运营指标:kafka也经常用来记录运营监控数据。包括收集各种分布式应用的数据,生产各种操作的集中反馈,比如报警和报告;
流式处理:比如spark streaming和storm。
2.kafka使用与集群搭建
环境准备
Kafka是用Scala语言开发的,运行在JVM上,在安装Kafka之前需要先安装JDK
kafka依赖zookeeper,需要先安装zookeeper,下载地址
wget http://archive.apache.org/dist/zookeeper/zookeeper-3.4.9/zookeeper-3.4.9.tar.gztar ‐zxvf zookeeper‐3.4.9.tar.gzcd zookeeper‐3.4.9cp conf/zoo_sample.cfg conf/zoo.cfg#启动zookeeper服务start#启动客户端bin/zkCli.sh
下载kafka安装包
参考 http://kafka.apache.org/11/documentation.html#quickstart
wget https://archive.apache.org/dist/kafka/1.1.1/kafka_2.11-1.1.1.tgztar ‐zxvf kafka_2.11-1.1.1.tgzcd kafka_2.11-1.1.1.tgz
启动kafka服务
bin/kafka-server-start.sh config/server.propertiesserver.properties是kafka核心配置文件
http://kafka.apache.org/11/documentation.html#brokerconfigs
Property |
Default |
Description |
broker.id |
0 |
每个broker都可以用一个唯一的非负整数id进行标识;这个id可以作为broker的“名字”,你可以选择任意你喜欢的数字作为id,只要id是唯一的即可。 |
log.dirs |
/tmp/kafka-logs |
kafka存放数据的路径。这个路径并不是唯一的,可以是多个,路径之间只需要使用逗号分隔即可; 每当创建新partition时,都会选择在包含最少partitions的路径下进行。 |
listeners |
9092 |
server接受客户端连接的端口 |
zookeeper.connect |
localhost:2181 |
zooKeeper连接字符串的格式为:hostname:port,此处hostname和port分别是ZooKeeper集群中某个节点的host和port;zookeeper如果是集群,连接方式为 hostname1:port1, hostname2:port2, hostname3:port3 |
log.retention.hours |
168 |
每个日志文件删除之前保存的时间。默认数据保存时间对所有topic都一样。 |
min.insync.replicas |
1 |
当producer设置acks为-1时,min.insync.replicas指定replicas的最小数目(必须确认每一个repica的写数据都是成功的),如果这个数目没有达到,producer发送消息会产生异常 |
delete.topic.enable |
false |
是否允许删除主题 |
创建主题
# 创建分区数是1,副本数是1的主题为test的topicbin/kafka-topics.sh --create --zookeeper localhost:2181 --replication-factor 1 --partitions 1 --topic test# 查看topic列表bin/kafka-topics.sh --list --zookeeper localhost:2181# 查看命令帮助bin/kafka-topics.sh
启动Producer发送消息
bin/kafka-console-producer.sh --broker-list localhost:9092 --topic test启动Consumer消费消息
# --group 指定消费组 --from-beginning 从头开始消费bin/kafka-console-consumer.sh --bootstrap-server localhost:9092 --topic test --group consumer1 --from-beginning# 查看消费组bin/kafka‐consumer‐groups.sh ‐‐bootstrap‐server localhost:9092 ‐‐list
单播消息:kafka中,在同一个消费组里 ,一条消息只能被某一个消费者消费
多播消息:针对Kafka同一条消息只能被同一个消费组下的某一个消费者消费的特性,要实现多播只要保证这些消费者属于不同的消费组
集群配置
配置3个broker
cp config/server.properties config/server-1.propertiescp config/server.properties config/server-2.propertiesconfig/server-1.properties:broker.id=1listeners=PLAINTEXT://:9093log.dir=/tmp/kafka-logs-1config/server-2.properties:broker.id=2listeners=PLAINTEXT://:9094log.dir=/tmp/kafka-logs-2#启动brokerbin/kafka‐server‐start.sh ‐daemon config/server‐1.propertiesbin/kafka‐server‐start.sh ‐daemon config/server‐2.properties#创建一个 副本为3,分区为3的topicbin/kafka-topics.sh --create --zookeeper localhost:2181 --replication-factor 3 --partitions 3 --topic my-replicated-topic查看topic的情况bin/kafka-topics.sh --describe --zookeeper localhost:2181 --topic my-replicated-topic
leader节点负责给定partition的所有读写请求。
replicas 表示某个partition在哪几个broker上存在备份。不管这个几点是不是”leader“,甚至这个节点挂了,也会列出。
isr 是replicas的一个子集,它只列出当前还存活着的,并且已同步备份了该partition的节点。
3.Java中kafka‐clients 应用
Java中使用kafka,引入maven依赖
<dependency><groupId>org.apache.kafka</groupId><artifactId>kafka-clients</artifactId><version>1.1.1</version></dependency>
Producer Configs
kafka不同版本的配置可能存在一些差异,以官方文档参考为准
参考:http://kafka.apachecn.org/documentation.html#producerapi
Consumer Configs
Producer代码
public class Producer {public static void main(String[] args) {Properties properties = new Properties();// 配置 broker 地址properties.put(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG,"192.168.3.14:9092");/**发出消息持久化机制参数(1)acks=0:表示producer不需要等待任何broker确认收到消息的回复,就可以继续发送下一条消息。性能最高,但是最容易丢消息。(2)acks=1:至少要等待leader已经成功将数据写入本地log,但是不需要等待所有follower是否成功写入。就可以继续发送下一条消息。这种情况下,如果follower没有成功备份数据,而此时leader又挂掉,则消息会丢失。(3)acks=-1或all:这意味着leader需要等待所有备份(min.insync.replicas配置的备份个数)都成功写入日志,这种策略会保证只要有一个备份存活就不会丢失数据。这是最强的数据保证。一般除非是金融级别,或跟钱打交道的场景才会使用这种配置。*/properties.put(ProducerConfig.ACKS_CONFIG,"1");//发送失败会重试,默认重试间隔100ms,重试能保证消息发送的可靠性,但是也可能造成消息// 重复发送,比如网络抖动,所以需要在接收者那边做好消息接收的幂等性处理properties.put(ProducerConfig.RETRIES_CONFIG, 3);//重试间隔设置properties.put(ProducerConfig.RETRY_BACKOFF_MS_CONFIG, 300);//设置发送消息的本地缓冲区,如果设置了该缓冲区,消息会先发送到本地缓冲区,可以提高消息发送性能,// 默认值是33554432,即32MBproperties.put(ProducerConfig.BUFFER_MEMORY_CONFIG, 33554432);//kafka本地线程会从缓冲区取数据,批量发送到broker,//设置批量发送消息的大小,默认值是16384,即16kb,就是说一个batch满了16kb就发送出去properties.put(ProducerConfig.BATCH_SIZE_CONFIG, 16384);//默认值是0,意思就是消息必须立即被发送,但这样会影响性能//一般设置100毫秒左右,就是说这个消息发送完后会进入本地的一个batch,如果100毫秒内,// 这个batch满了16kb就会随batch一起被发送出去//如果100毫秒内,batch没满,那么也必须把消息发送出去,不能让消息的发送延迟时间太长properties.put(ProducerConfig.LINGER_MS_CONFIG, 100);//把发送的key从字符串序列化为字节数组properties.put(ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG, StringSerializer.class.getName());//把发送消息value从字符串序列化为字节数组properties.put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG, StringSerializer.class.getName());//获取到producerKafkaProducer<String, String> producer = new KafkaProducer<>(properties);int messageNo = 1;boolean isAsync = false;while (true){String messageStr = "Message_" + messageNo;long startTime = System.currentTimeMillis();//指定发送分区ProducerRecord record = new ProducerRecord<>("topicTest1",0,messageNo+"",messageStr);if (isAsync) { // Send asynchronouslyproducer.send(record, new DemoCallBack(startTime, messageNo, messageStr));} else { // Send synchronouslytry {producer.send(record).get();System.out.println("Sent message: (" + messageNo + ", " + messageStr + ")");} catch (InterruptedException | ExecutionException e) {e.printStackTrace();}}if (messageNo==10){break;}++messageNo;}}}class DemoCallBack implements Callback {private final long startTime;private final int key;private final String message;public DemoCallBack(long startTime, int key, String message) {this.startTime = startTime;this.key = key;this.message = message;}/*** A callback method the user can implement to provide asynchronous handling of request completion. This method will* be called when the record sent to the server has been acknowledged. Exactly one of the arguments will be* non-null.** @param metadata The metadata for the record that was sent (i.e. the partition and offset). Null if an error* occurred.* @param exception The exception thrown during processing of this record. Null if no error occurred.*/@Overridepublic void onCompletion(RecordMetadata metadata, Exception exception) {long elapsedTime = System.currentTimeMillis() - startTime;if (metadata != null) {System.out.println("message(" + key + ", " + message + ") sent to partition(" + metadata.partition() +"), " +"offset(" + metadata.offset() + ") in " + elapsedTime + " ms");} else {exception.printStackTrace();}}}
Consumer代码
public class Consumer {public static void main(String[] args) {Properties props = new Properties();// 配置broker地址props.put(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG, "192.168.3.14:9092");// 消费组props.put(ConsumerConfig.GROUP_ID_CONFIG, "DemoConsumer");// 是否自动提交offsetprops.put(ConsumerConfig.ENABLE_AUTO_COMMIT_CONFIG, "true");// 自动提交offset的间隔时间props.put(ConsumerConfig.AUTO_COMMIT_INTERVAL_MS_CONFIG, "1000");/*心跳时间,服务端broker通过心跳确认consumer是否故障,如果发现故障,就会通过心跳下发rebalance的指令给其他的consumer通知他们进行rebalance操作,这个时间可以稍微短一点*/props.put(ConsumerConfig.HEARTBEAT_INTERVAL_MS_CONFIG, "1000");//服务端broker多久感知不到一个consumer心跳就认为他故障了,默认是10秒props.put(ConsumerConfig.SESSION_TIMEOUT_MS_CONFIG, "30000");props.put(ConsumerConfig.KEY_DESERIALIZER_CLASS_CONFIG, StringDeserializer.class.getName());props.put(ConsumerConfig.VALUE_DESERIALIZER_CLASS_CONFIG, StringDeserializer.class.getName());// 获取consumerKafkaConsumer<Integer, String> consumer = new KafkaConsumer<>(props);String topicName = "topicTest1";// 指定分区consumer.assign(Arrays.asList(new TopicPartition(topicName, 0)));//消息回溯消费// consumer.seekToBeginning(Arrays.asList(new TopicPartition(topicName, 0)));//指定offset消费// consumer.seek(new TopicPartition(topicName, 0), 10);while(true){/** poll() API 是拉取消息的长轮询,主要是判断consumer是否还活着,只要我们持续调用poll(),* 消费者就会存活在自己所在的group中,并且持续的消费指定partition的消息。* 底层是这么做的:消费者向server持续发送心跳,如果一个时间段(session.* timeout.ms)consumer挂掉或是不能发送心跳,这个消费者会被认为是挂掉了,* 这个Partition也会被重新分配给其他consumer*/ConsumerRecords<Integer, String> records = consumer.poll(1000);for (ConsumerRecord<Integer, String> record : records) {System.out.println("Received message: (" + record.key() + ", " + record.value() + ") at offset " + record.offset());}if (records.count() > 0) {// 提交offsetconsumer.commitSync();}}}}
原文作者:Fox爱分享;如有侵权,请联系管理员删除。

