前几天,公司有新项目需要上线,需要一个高可用的Hadoop集群,用以支撑Hbase数据的存储以及承载整个后期的数据计算,想到之后应该还会有不同功能性的集群需求,特意将编排过程抽象成ansible playbooks形式进行,可实现一键部署高可用的Hadoop集群。
Playbooks内容拆解
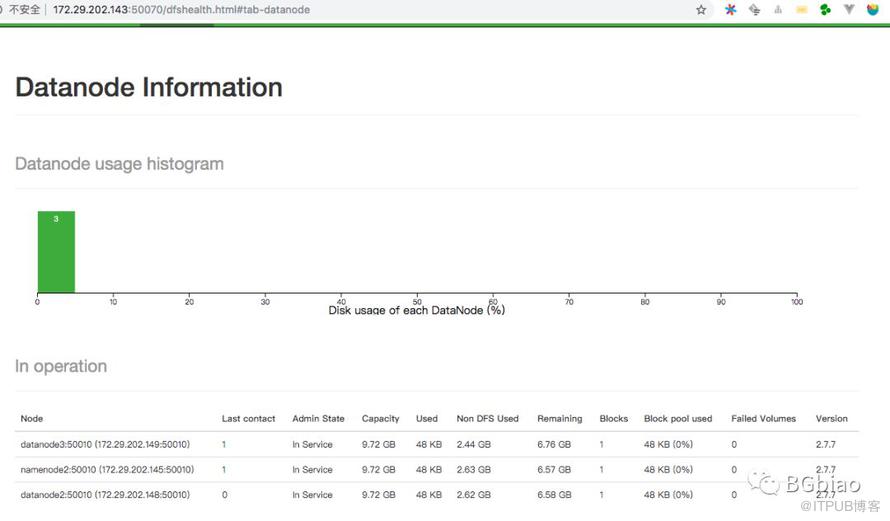
Playbooks项目结构$ tree -L 2 ..├── hadoop # inventory文件├── hadoop-install.yml # ansible playbooks脚本├── readme.md # 详细部署文档├── templates # 抽象化的配置模板(环境变量和hadoop配置)│ ├── bash_profile.j2│ ├── core-site.xml.j2│ ├── hadoop-env.sh.j2│ ├── hdfs-site.xml.j2│ ├── hosts.j2│ ├── mapred-site.xml│ ├── slaves│ └── yarn-site.xml└── vars # 抽离出来的可配置变量└── varsfile.yml核心可配置文件$ cat vars/varsfile.yml---# 内网公共的制品库(用于存放公共制品)download_url: http://172.29.202.140/dav/hadoop/# hadoop集群的标准化目录packagedir: /tmp/appdir: /opt/app/datadir: /opt/data/pkgdir: /opt/packages/serverdir: /opt/servers/datanodedir: /data/tmpdir: hatmpjournalnodedir: journalhdfsdir: hdfs# hadoop基本依赖包jdk: jdk1.8.0_191app: hadoopapp_pkg: hadoop-2.7.7hadoop_pkg: hadoop-2.7.7# 集群配置信息cluster_name: bgbiaoreplication: 3blocksize: 16mzk_cluster: "172.29.202.143:2181,172.29.202.145:2181,172.29.202.148:2181"hadoop_user: hadoopssh_key: "/home/{{ hadoop_user }}/.ssh/id_rsa"namenode1: 172.29.202.143namenode2: 172.29.202.145datanode1: 172.29.202.145datanode2: 172.29.202.148datanode3: 172.29.202.149核心的配置文件基本如上,如果需要快速搭建一个Hadoop集群,基本需要修改的是:cluster_name: hadoop集群名称(nameservice)zk_cluster: hadoop高可用集群的仲裁依赖(zkfc)hadoop_user: 启动hadoop集群的用户namenodeN: 用于指定namenode节点datanodeN: 用于指定datanode节点
Ansible-playbook快速部署
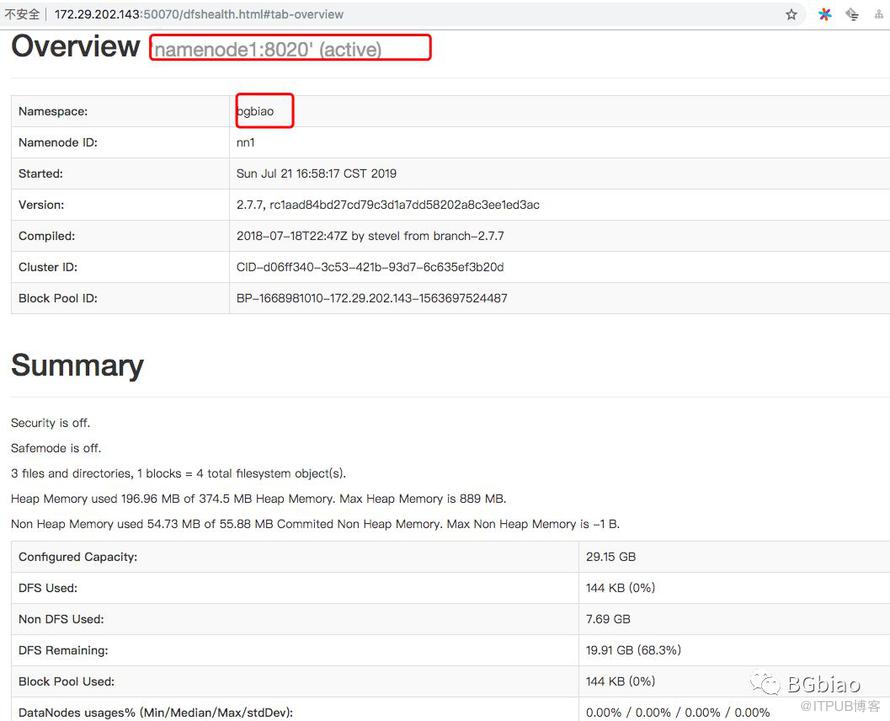
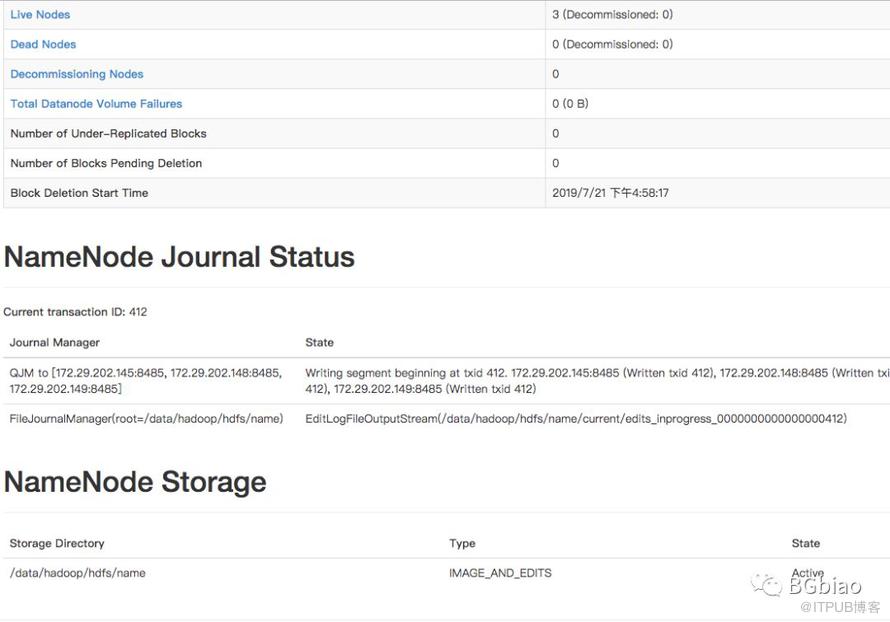
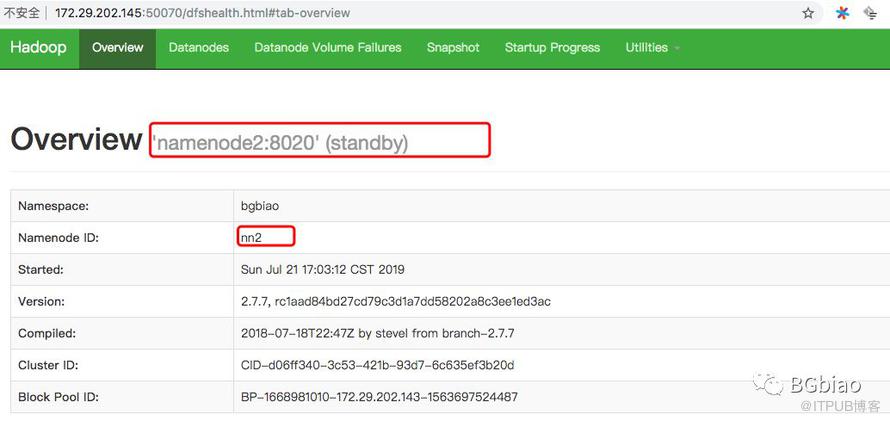
# 使用ansible-playbooks进行统一管理和下发集群配置$ ansible-playbook -i hadoop -e host=all hadoop-install.ymlPLAY [all] *******************************************************************************************TASK [Gathering Facts] *******************************************************************************ok: [172.29.202.149]ok: [172.29.202.148]ok: [172.29.202.145]ok: [172.29.202.143]。。。。。。。PLAY RECAP *******************************************************************************************172.29.202.143 : ok=9 changed=4 unreachable=0 failed=0 skipped=0 rescued=0 ignored=0172.29.202.145 : ok=9 changed=4 unreachable=0 failed=0 skipped=0 rescued=0 ignored=0172.29.202.148 : ok=9 changed=4 unreachable=0 failed=0 skipped=0 rescued=0 ignored=0172.29.202.149 : ok=9 changed=4 unreachable=0 failed=0 skipped=0 rescued=0 ignored=0# 以上操作如果正常退出,即会在规划好的各个角色节点上进行个性化配置生成# 接下来进行一些集群的初始化启动操作1. 格式化zk节点# 在namenode1节点上的hadoop用户下执行$ hdfs zkfc -formatZK19/07/21 16:10:27 INFO tools.DFSZKFailoverController: Failover controller configured for NameNode NameNode at namenode1/172.29.202.143:802019/07/21 16:10:27 INFO zookeeper.ZooKeeper: Client environment:zookeeper.version=3.4.6-1569965, built on 02/20/2014 09:09 GMT19/07/21 16:10:27 INFO zookeeper.ZooKeeper: Client environment:host.name=namenode119/07/21 16:10:27 INFO zookeeper.ZooKeeper: Client environment:java.version=1.8.0_19119/07/21 16:10:27 INFO zookeeper.ZooKeeper: Client environment:java.vendor=Oracle Corporation............19/07/21 16:10:27 INFO zookeeper.ClientCnxn: Session establishment complete on server 172.29.202.143/172.29.202.143:2181, sessionid = 0x1004d210ce00001, negotiated timeout = 1500019/07/21 16:10:27 INFO ha.ActiveStandbyElector: Successfully created /hadoop-ha/bgbiao in ZK....# 看到在zk中成功创建了/hadoop-ha/bgbiao 即成功2. 启动journalnode# 我们配置的是datanode1,datanode2,datanode3为journalnode节点,分别登录节点使用Hadoop用户进行启动# 检查journalnode启动状态$ ansible -i hadoop datanode -m shell -a " su - hadoop -c 'sh /opt/app/hadoop/sbin/hadoop-daemon.sh start journalnode' && su - hadoop -c 'jps'"172.29.202.149 | CHANGED | rc=0 >>25300 Jps24445 JournalNode172.29.202.145 | CHANGED | rc=0 >>3030 Jps2199 JournalNode172.29.202.148 | CHANGED | rc=0 >>2203 JournalNode3019 Jps3. 格式化namenode# 在namenode1节点上以hadoop用户格式化hdfs[hadoop@namenode1 ]$ hdfs namenode -format19/07/21 16:25:23 INFO namenode.NameNode: STARTUP_MSG:/************************************************************STARTUP_MSG: Starting NameNodeSTARTUP_MSG: host = namenode1/172.29.202.143STARTUP_MSG: args = [-format]STARTUP_MSG: version = 2.7.7..............19/07/21 16:25:24 INFO util.ExitUtil: Exiting with status 019/07/21 16:25:24 INFO namenode.NameNode: SHUTDOWN_MSG:/************************************************************SHUTDOWN_MSG: Shutting down NameNode at namenode1/172.29.202.143************************************************************/4. 启动hadoop集群# 直接使用ansible批量启动ansible -i hadoop datanode -m shell -a "su - hadoop -c 'sh /opt/app/hadoop/sbin/hadoop-daemon.sh start datanode'"[WARNING]: Consider using 'become', 'become_method', and 'become_user' rather than running su172.29.202.148 | CHANGED | rc=0 >>starting datanode, logging to /opt/app/hadoop/logs/hadoop-hadoop-datanode-datanode2.out172.29.202.145 | CHANGED | rc=0 >>starting datanode, logging to /opt/app/hadoop/logs/hadoop-hadoop-datanode-datanode3.out172.29.202.149 | CHANGED | rc=0 >>starting datanode, logging to /opt/app/hadoop/logs/hadoop-hadoop-datanode-datanode1.out# 检查datanode进程$ ansible -i hadoop datanode -m shell -a "su - hadoop -c 'jps'"172.29.202.145 | CHANGED | rc=0 >>2199 JournalNode3162 DataNode3294 Jps172.29.202.149 | CHANGED | rc=0 >>25432 DataNode25564 Jps24445 JournalNode172.29.202.148 | CHANGED | rc=0 >>3283 Jps2203 JournalNode3151 DataNode# 启动namenode1ansible -i hadoop namenode[0] -m shell -a "su - hadoop -c 'sh /opt/app/hadoop/sbin/hadoop-daemon.sh start namenode'"172.29.202.143 | CHANGED | rc=0 >>starting namenode, logging to /opt/app/hadoop/logs/hadoop-hadoop-namenode-dev-k8s-4.out# 启动namenode2$ ansible -i hadoop namenode[1] -m shell -a "su - hadoop -c 'hdfs namenode -bootstrapStandby'"172.29.202.145 | CHANGED | rc=0 >>=====================================================About to bootstrap Standby ID nn2 from:Nameservice ID: bgbiaoOther Namenode ID: nn1Other NN's HTTP address: http://namenode1:50070Other NN's IPC address: namenode1/172.29.202.143:8020Namespace ID: 328470975Block pool ID: BP-1668981010-172.29.202.143-1563697524487Cluster ID: CID-d06ff340-3c53-421b-93d7-6c635ef3b20dLayout version: -63isUpgradeFinalized: true=====================================================19/07/21 16:32:55 INFO namenode.NameNode: STARTUP_MSG:/************************************************************STARTUP_MSG: Starting NameNodeSTARTUP_MSG: host = namenode2/172.29.202.145STARTUP_MSG: args = [-bootstrapStandby]STARTUP_MSG: version = 2.7.7............************************************************************/19/07/21 16:32:55 INFO namenode.NameNode: registered UNIX signal handlers for [TERM, HUP, INT]19/07/21 16:32:55 INFO namenode.NameNode: createNameNode [-bootstrapStandby]19/07/21 16:32:56 INFO common.Storage: Storage directory /data/hadoop/hdfs/name has been successfully formatted.19/07/21 16:32:56 INFO namenode.TransferFsImage: Opening connection to http://namenode1:50070/imagetransfer?getimage=1&txid=0&storageInfo=-63:328470975:0:CID-d06ff340-3c53-421b-93d7-6c635ef3b20d19/07/21 16:32:56 INFO namenode.TransferFsImage: Image Transfer timeout configured to 60000 milliseconds19/07/21 16:32:56 INFO namenode.TransferFsImage: Transfer took 0.00s at 0.00 KB/s19/07/21 16:32:56 INFO namenode.TransferFsImage: Downloaded file fsimage.ckpt_0000000000000000000 size 323 bytes.19/07/21 16:32:56 INFO util.ExitUtil: Exiting with status 019/07/21 16:32:56 INFO namenode.NameNode: SHUTDOWN_MSG:/************************************************************SHUTDOWN_MSG: Shutting down NameNode at namenode2/172.29.202.145************************************************************/# 可以看到此时namenode2已经设置了bootstrapStandby# 此时启动namenode2$ ansible -i hadoop namenode[1] -m shell -a "su - hadoop -c 'sh /opt/app/hadoop/sbin/hadoop-daemon.sh start namenode'"## 注意:此时namenode1和namenode2均已启动,如果此时访问namenode1:50070和namenode2:50070会发现两个namenode均为standby角色,因为我们是HA模式,namenode初始状态为standby,需要启动zkfc来进行选举# 在两个namenode节点启动zkfc进程$ ansible -i hadoop namenode -m shell -a "su - hadoop -c 'sh /opt/app/hadoop/sbin/hadoop-daemon.sh start zkfc'"# 此时zkfc就会自动将两个standby的namenode选举出来一个为master
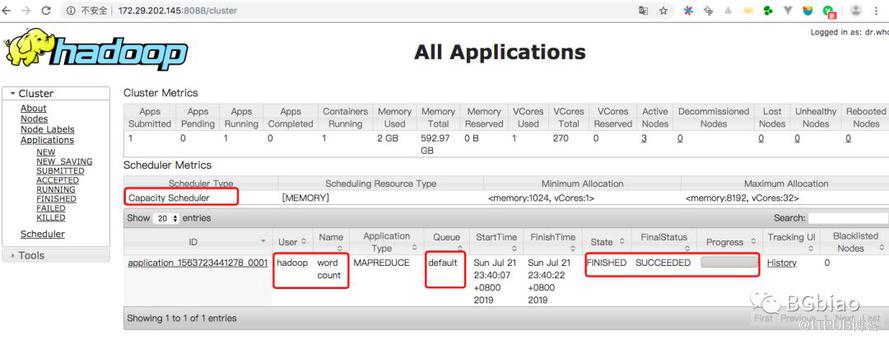
查看集群信息

华丽的分割线
点击原文链接可直接下载ansible-playbook脚本.
原文作者:云原生运维技术;如有侵权,请联系管理员删除。
上一篇:
使用Spinnaker管理k8s上的部署
下一篇:
每个人都应该有一套"事后总结系统"

请登录后发表评论
登录
全部评论
