k8s中部署prometheus监控告警系统-prometheus系列文章第一篇
前言
本篇文章主要介绍k8s集群中部署prometheus,并且配置prometheus的动态、静态服务发现,实现监控容器、物理节点、service、pod等资源指标,配置prometheus的web ui界面,下篇将接着这篇内容介绍Grafana和Alertmanager,并在Grafana的web界面展示prometheus的监控指标,然后通过alertmanager实现监控报警。
prometheus简介
Prometheus是一个开源的系统监控和报警系统,现在已经加入到CNCF基金会,成为继k8s之后第二个在CNCF托管的项目,在kubernetes容器管理系统中,通常会搭配prometheus进行监控,同时也支持多种exporter采集数据,还支持pushgateway进行数据上报,Prometheus性能足够支撑上万台规模的集群。
prometheus特点
1.多维度数据模型
时间序列数据由metrics名称和键值对来组成可以对数据进行聚合,切割等操作所有的metrics都可以设置任意的多维标签。
2.灵活的查询语言(PromQL)
可以对采集的metrics指标进行加法,乘法,连接等操作;3.可以直接在本地部署,不依赖其他分布式存储;
4.通过基于HTTP的pull方式采集时序数据;
5.可以通过中间网关pushgateway的方式把时间序列数据推送到prometheus server端;
6.可通过服务发现或者静态配置来发现目标服务对象(targets)。
7.有多种可视化图像界面,如Grafana等。
8.高效的存储,每个采样数据占3.5 bytes左右,300万的时间序列,30s间隔,保留60天,消耗磁盘大概200G。
prometheus组件介绍
1.Prometheus Server: 用于收集和存储时间序列数据。
2.Client Library: 客户端库,检测应用程序代码,当Prometheus抓取实例的HTTP端点时,客户端库会将所有跟踪的metrics指标的当前状态发送到prometheus server端。
3.Exporters: prometheus支持多种exporter,通过exporter可以采集metrics数据,然后发送到prometheus server端
4.Alertmanager: 从 Prometheus server 端接收到 alerts 后,会进行去重,分组,并路由到相应的接收方,发出报警,常见的接收方式有:电子邮件,微信,钉钉, slack等。
5.Grafana:监控仪表盘
6.pushgateway: 各个目标主机可上报数据到pushgatewy,然后prometheus server统一从pushgateway拉取数据。
prometheus架构图
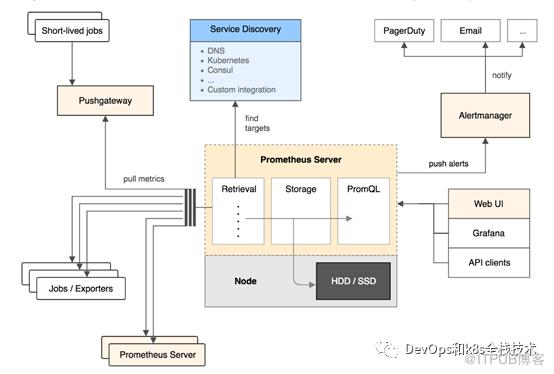
从上图可发现,Prometheus整个生态圈组成主要包括prometheus server,Exporter,pushgateway,alertmanager,grafana,Web ui界面,Prometheus server由三个部分组成,Retrieval,Storage,PromQL
Retrieval负责在活跃的target主机上抓取监控指标数据Storage存储主要是把采集到的数据存储到磁盘中PromQL是Prometheus提供的查询语言模块。prometheus工作流程:
1. Prometheus server可定期从活跃的(up)目标主机上(target)拉取监控指标数据,目标主机的监控数据可通过配置静态job或者服务发现的方式被prometheus server采集到,这种方式默认的pull方式拉取指标;也可通过pushgateway把采集的数据上报到prometheus server中;还可通过一些组件自带的exporter采集相应组件的数据;
2.Prometheus server把采集到的监控指标数据保存到本地磁盘或者数据库;
3.Prometheus采集的监控指标数据按时间序列存储,通过配置报警规则,把触发的报警发送到alertmanager
4.Alertmanager通过配置报警接收方,发送报警到邮件,微信或者钉钉等
5.Prometheus 自带的web ui界面提供PromQL查询语言,可查询监控数据
6.Grafana可接入prometheus数据源,把监控数据以图形化形式展示出
安装node-exporter组件
机器规划:
我的实验环境使用的k8s集群是一个master节点和一个node节点
master节点的机器ip是192.168.0.6,主机名是master1
node节点的机器ip是192.168.0.56,主机名是node1
master高可用集群安装可参考如下文章:
k8s1.18多master节点高可用集群安装-超详细中文官方文档
node-exporter是什么?
采集机器(物理机、虚拟机、云主机等)的监控指标数据,能够采集到的指标包括CPU, 内存,磁盘,网络,文件数等信息。
安装node-exporter组件,在k8s集群的master1节点操作
cat >node-export.yaml <<EOFapiVersion: apps/v1kind: DaemonSetmetadata:name: node-exporternamespace: monitor-salabels:name: node-exporterspec:selector:matchLabels:name: node-exportertemplate:metadata:labels:name: node-exporterspec:hostPID: truehostIPC: truehostNetwork: truecontainers:- name: node-exporterimage: prom/node-exporter:v0.16.0ports:- containerPort: 9100resources:requests:cpu: 0.15securityContext:privileged: trueargs:- --path.procfs- /host/proc- --path.sysfs- /host/sys- --collector.filesystem.ignored-mount-points- '"^/(sys|proc|dev|host|etc)($|/)"'volumeMounts:- name: devmountPath: /host/dev- name: procmountPath: /host/proc- name: sysmountPath: /host/sys- name: rootfsmountPath: /rootfstolerations:- key: "node-role.kubernetes.io/master"operator: "Exists"effect: "NoSchedule"volumes:- name: prochostPath:path: /proc- name: devhostPath:path: /dev- name: syshostPath:path: /sys- name: rootfshostPath:path: /EOF
#通过kubectl apply更新node-exporter
kubectl apply -f node-export.yaml
#查看node-exporter是否部署成功
kubectl get pods -n monitor-sa
显示如下,看到pod的状态都是running,说明部署成功
NAME READY STATUS RESTARTS AGEnode-exporter-9qpkd 1/1 Running 0 89snode-exporter-zqmnk 1/1 Running 0 89s
通过node-exporter采集数据
curl http://主机ip:9100/metrics
#node-export默认的监听端口是9100,可以看到当前主机获取到的所有监控数据,截取一部分,如下
# HELP node_cpu_seconds_total Seconds the cpus spent in each mode.# TYPE node_cpu_seconds_total counternode_cpu_seconds_total{cpu="0",mode="idle"} 56136.98# HELP node_load1 1m load average.# TYPE node_load1 gaugenode_load1 0.58#HELP:解释当前指标的含义,上面表示在每种模式下node节点的cpu花费的时间,以s为单位#TYPE:说明当前指标的数据类型,上面是counter类型node_load1该指标反映了当前主机在最近一分钟以内的负载情况,系统的负载情况会随系统资源的使用而变化,因此node_load1反映的是当前状态,数据可能增加也可能减少,从注释中可以看出当前指标类型为gauge(标准尺寸)node_cpu_seconds_total{cpu="0",mode="idle"} :cpu0上idle进程占用CPU的总时间,CPU占用时间是一个只增不减的度量指标,从类型中也可以看出node_cpu的数据类型是counter(计数器)counter计数器:只是采集递增的指标gauge标准尺寸:统计的指标可增加可减少
k8s集群中部署prometheus
1.创建namespace、sa账号,在k8s集群的master节点操作
#创建一个monitor-sa的名称空间
kubectl create ns monitor-sa
#创建一个sa账号
kubectl create serviceaccount monitor -n monitor-sa
#把sa账号monitor通过clusterrolebing绑定到clusterrole上
kubectl create clusterrolebinding monitor-clusterrolebinding -n monitor-sa --clusterrole=cluster-admin --serviceaccount=monitor-sa:monitor
2.创建数据目录
#在k8s集群的任何一个node节点操作,因为我的k8s集群只有一个node节点node1,所以我在node1上操作如下命令:
mkdir /data
chmod 777 /data/
3.安装prometheus,以下步骤均在在k8s集群的master1节点操作
1)创建一个configmap存储卷,用来存放prometheus配置信息
cat >prometheus-cfg.yaml <<EOF---kind: ConfigMapapiVersion: v1metadata:labels:app: prometheusname: prometheus-confignamespace: monitor-sadata:prometheus.yml: |global:scrape_interval: 15sscrape_timeout: 10sevaluation_interval: 1mscrape_configs:- job_name: 'kubernetes-node'kubernetes_sd_configs:- role: noderelabel_configs:- source_labels: [__address__]regex: '(.*):10250'replacement: '${1}:9100'target_label: __address__action: replace- action: labelmapregex: __meta_kubernetes_node_label_(.+)- job_name: 'kubernetes-node-cadvisor'kubernetes_sd_configs:- role: nodescheme: httpstls_config:ca_file: /var/run/secrets/kubernetes.io/serviceaccount/ca.crtbearer_token_file: /var/run/secrets/kubernetes.io/serviceaccount/tokenrelabel_configs:- action: labelmapregex: __meta_kubernetes_node_label_(.+)- target_label: __address__replacement: kubernetes.default.svc:443- source_labels: [__meta_kubernetes_node_name]regex: (.+)target_label: __metrics_path__replacement: /api/v1/nodes/${1}/proxy/metrics/cadvisor- job_name: 'kubernetes-apiserver'kubernetes_sd_configs:- role: endpointsscheme: httpstls_config:ca_file: /var/run/secrets/kubernetes.io/serviceaccount/ca.crtbearer_token_file: /var/run/secrets/kubernetes.io/serviceaccount/tokenrelabel_configs:- source_labels: [__meta_kubernetes_namespace, __meta_kubernetes_service_name, __meta_kubernetes_endpoint_port_name]action: keepregex: default;kubernetes;https- job_name: 'kubernetes-service-endpoints'kubernetes_sd_configs:- role: endpointsrelabel_configs:- source_labels: [__meta_kubernetes_service_annotation_prometheus_io_scrape]action: keepregex: true- source_labels: [__meta_kubernetes_service_annotation_prometheus_io_scheme]action: replacetarget_label: __scheme__regex: (https?)- source_labels: [__meta_kubernetes_service_annotation_prometheus_io_path]action: replacetarget_label: __metrics_path__regex: (.+)- source_labels: [__address__, __meta_kubernetes_service_annotation_prometheus_io_port]action: replacetarget_label: __address__regex: ([^:]+)(?::\d+)?;(\d+)replacement: $1:$2- action: labelmapregex: __meta_kubernetes_service_label_(.+)- source_labels: [__meta_kubernetes_namespace]action: replacetarget_label: kubernetes_namespace- source_labels: [__meta_kubernetes_service_name]action: replacetarget_label: kubernetes_nameEOF
注意:通过上面命令生成的promtheus-cfg.yaml文件会有一些问题,$1和$2这种变量在文件里没有,需要在k8s的master1节点打开promtheus-cfg.yaml文件,手动把$1和$2这种变量写进文件里,promtheus-cfg.yaml文件需要手动修改部分如下:
22行的replacement: ':9100'变成replacement: '${1}:9100'42行的replacement: /api/v1/nodes//proxy/metrics/cadvisor变成replacement: /api/v1/nodes/${1}/proxy/metrics/cadvisor73行的replacement: 变成replacement: $1:$2
#通过kubectl apply更新configmap
kubectl apply -f prometheus-cfg.yaml
2)通过deployment部署prometheus
cat >prometheus-deploy.yaml <<EOF---apiVersion: apps/v1kind: Deploymentmetadata:name: prometheus-servernamespace: monitor-salabels:app: prometheusspec:replicas: 1selector:matchLabels:app: prometheuscomponent: server#matchExpressions:#- {key: app, operator: In, values: [prometheus]}#- {key: component, operator: In, values: [server]}template:metadata:labels:app: prometheuscomponent: serverannotations:prometheus.io/scrape: 'false'spec:nodeName: node1serviceAccountName: monitorcontainers:- name: prometheusimage: prom/prometheus:v2.2.1imagePullPolicy: IfNotPresentcommand:- prometheus- --config.file=/etc/prometheus/prometheus.yml- --storage.tsdb.path=/prometheus- --storage.tsdb.retention=720hports:- containerPort: 9090protocol: TCPvolumeMounts:- mountPath: /etc/prometheus/prometheus.ymlname: prometheus-configsubPath: prometheus.yml- mountPath: /prometheus/name: prometheus-storage-volumevolumes:- name: prometheus-configconfigMap:name: prometheus-configitems:- key: prometheus.ymlpath: prometheus.ymlmode: 0644- name: prometheus-storage-volumehostPath:path: /datatype: DirectoryEOF
注意:在上面的prometheus-deploy.yaml文件有个nodeName字段,这个就是用来指定创建的这个prometheus的pod调度到哪个节点上,我们这里让nodeName=node1,也即是让pod调度到node1节点上,因为node1节点我们创建了数据目录/data,所以大家记住:你在k8s集群的哪个节点创建/data,就让pod调度到哪个节点。
#通过kubectl apply更新prometheus
kubectl apply -f prometheus-deploy.yaml
#查看prometheus是否部署成功
kubectl get pods -n monitor-sa
显示如下,可看到pod状态是running,说明prometheus部署成功
NAME READY STATUS RESTARTS AGEnode-exporter-9qpkd 1/1 Running 0 76mnode-exporter-zqmnk 1/1 Running 0 76mprometheus-server-85dbc6c7f7-nsg94 1/1 Running 0 6m7
3)给prometheus pod创建一个service
cat > prometheus-svc.yaml << EOF---apiVersion: v1kind: Servicemetadata:name: prometheusnamespace: monitor-salabels:app: prometheusspec:type: NodePortports:- port: 9090targetPort: 9090protocol: TCPselector:app: prometheuscomponent: serverEOF
#通过kubectl apply 更新service
kubectl apply -f prometheus-svc.yaml
#查看service在物理机映射的端口
kubectl get svc -n monitor-sa
显示如下:
NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGEprometheus NodePort 10.96.45.93 <none> 9090:31043/TCP 50s
通过上面可以看到service在宿主机上映射的端口是31043,这样我们访问k8s集群的master1节点的ip:31043,就可以访问到prometheus的web ui界面了
#访问prometheus web ui界面
火狐浏览器输入如下地址:
http://192.168.0.6:31043/graph
可看到如下页面:
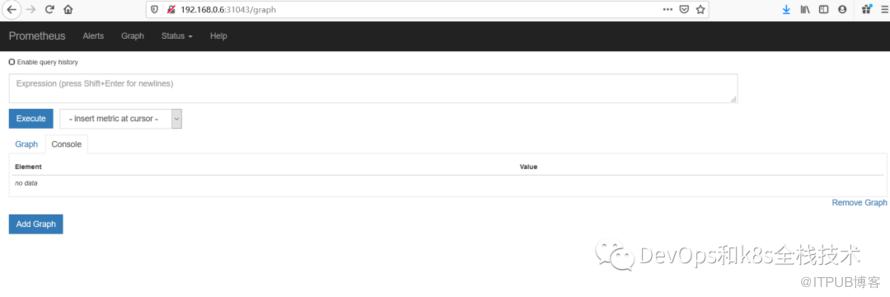
#点击页面的Status->Targets,可看到如下,说明我们配置的服务发现可以正常采集数据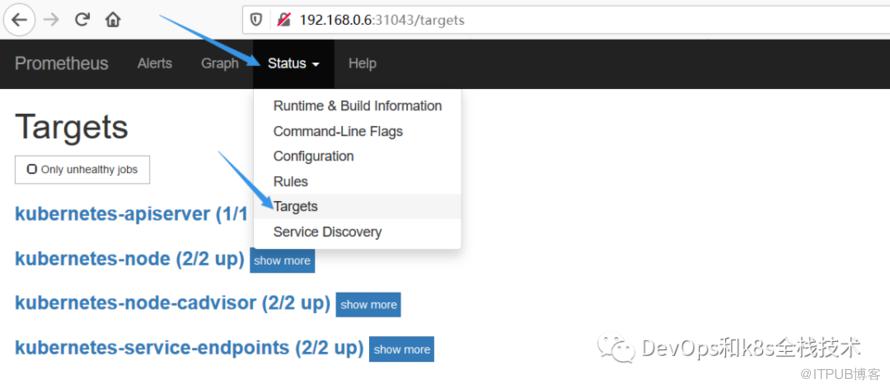
prometheus热更新
#为了每次修改配置文件可以热加载prometheus,也就是不停止prometheus,就可以使配置生效,如修改prometheus-cfg.yaml,想要使配置生效可用如下热加载命令:
curl -X POST http://10.244.1.66:9090/-/reload
#10.244.1.66是prometheus的pod的ip地址,如何查看prometheus的pod ip,可用如下命令:
kubectl get pods -n monitor-sa -o wide | grep prometheus
显示如下, 10.244.1.7就是prometheus的ip
prometheus-server-85dbc6c7f7-nsg94 1/1 Running 0 29m 10.244.1.7 node1 <none> <none>#热加载速度比较慢,可以暴力重启prometheus,如修改上面的prometheus-cfg.yaml文件之后,可执行如下强制删除:
kubectl delete -f prometheus-cfg.yaml
kubectl delete -f prometheus-deploy.yaml
然后再通过apply更新:
kubectl apply -f prometheus-cfg.yaml
kubectl apply -f prometheus-deploy.yaml
注意:
线上最好热加载,暴力删除可能造成监控数据的丢失
看到这我们就已经把prometheus部署和配置成功了,但不要着急,这是连载文章,下篇将接着这篇内容介绍Grafana和Alertmanager,并在Grafana的web界面展示prometheus的监控指标,并且通过alertmanager实现报警,请继续关注我的公众号,我会把最新知识持续不间断的分享给大家。
技术交流群
为了大家更快速的学习知识,掌握技术,随时沟通问题,特组建了技术交流群,大家在群里可以分享自己的技术栈,抛出日常问题,群里会有很多大佬及时解答,这样我们就会结识很多志同道合的人,群里还有很多关于kubernetes/docker/devops/openstack/openshift/linux/IaaS/PaaS的免费文章和视频,长按下图可加我微信,备注运维或者k8s或者devops即可进群,让我们共同努力,向着美好的未来出发吧~~~
微信:luckylucky421302
微信公众号
长按如下指纹可关注公众号·
原文作者:DevOps和k8s全栈技术;如有侵权,请联系管理员删除。

最新文章
- 韩先超对兴业数金进行云原生k8s培训总结|干货分享|前沿技术必看
- Java 应用上 Kubernetes 的 20 条生产级必备条件
- Kubernetes 存活探测(Liveness Probe)详解:原理、配置与最佳实践
- 深耕为舟,远志为帆->韩先超2025年终总结
- 生产故障排查记录:Redis 中间件疑难错误排查与修复
- docker镜像加速器又又被封了:新整理一批可以用的|无需代理,国内可访问
- 运维秘籍:20个常识,关键时刻能救命!
- 提升运维效率:Linux和Kubernetes常见故障的20种解决方案
- K8s Scheduler Pod 启动失败:Error: failed to reserve container name
- K8S集群证书过期,一键修复指南 | 干货分享
