K8s Scheduler Pod 启动失败:Error: failed to reserve container name
欢迎关注我的公众号「DevOps和k8s全栈技术」,进公众号【服务】栏,可以看到技术群,点击即可加入学习交流群。↓↓↓
在 Kubernetes 集群中,kube-scheduler Pod 作为集群控制平面组件的核心之一,其启动失败可能会导致调度功能不可用。本文将以一次真实的排查过程为例,分享如何解决 kube-scheduler Pod 启动失败的问题。
问题描述:
通过查看 kube-scheduler Pod 的详细信息,发现 Pod 的状态异常,日志如下:
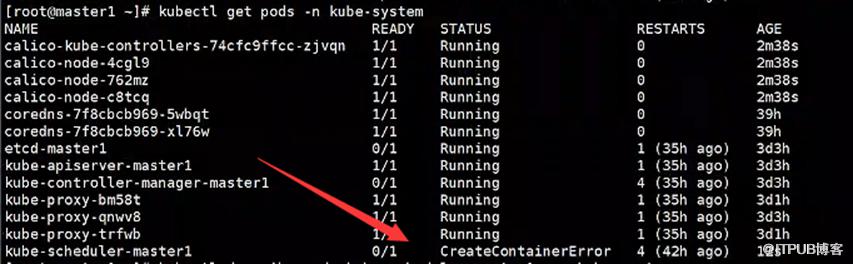
Normal Pulled 6m35s (x335 over 40h) kubelet Container image "registry.cn-hangzhou.aliyuncs.com/google_containers/kube-scheduler:v1.25.0" already present on machineWarning Failed 3m14s (x12 over 4m53s) kubelet Error: failed to reserve container name "kube-scheduler_kube-scheduler-master1_kube-system_e62a843911b3baeecef776971ec1cc66_5": name "kube-scheduler_kube-scheduler-master1_kube-system_e62a843911b3baeecef776971ec1cc66_5" is reserved for "830ab0f0a4e17a39e2b1d254038f05bf84aa586e39da300a2a4cd97c77bab4f0"
解决方案
1. 确认异常容器
使用 ctr 工具查看当前占用的容器。由于 Kubernetes 使用容器运行时 containerd,我们需要通过 ctr 命令检查占用资源的容器。
# 查看占用容器的详细信息ctr -n=k8s.io containers list --quiet | grep <CONTAINER_ID>
替换 <CONTAINER_ID> 为日志中报错的容器 ID,例如:830ab0f0a4e17a39e2b1d254038f05bf84aa586e39da300a2a4cd97c77bab4f0。
2. 清理异常容器
2.1 停止任务
先停止相关的运行任务。
# 停止任务ctr -n=k8s.io tasks kill 830ab0f0a4e17a39e2b1d254038f05bf84aa586e39da300a2a4cd97c77bab4f0
2.2 删除容器
停止任务后,删除异常容器。
# 删除容器ctr -n=k8s.io containers delete 830ab0f0a4e17a39e2b1d254038f05bf84aa586e39da300a2a4cd97c77bab4f0
3. 重启 Kubelet 服务
在清理容器后,重新启动 Kubelet 服务以刷新节点状态。
# 重启 Kubelet 服务systemctl restart kubelet
4. 检查 Pod 状态
重启 Kubelet 服务后,检查 kube-scheduler Pod 是否恢复正常。
# 查看 Pod 状态kubectl get pod -n kube-system# 查看 Pod 详细信息kubectl describe pod kube-scheduler -n kube-system
如果 Pod 已恢复到 Running 状态,说明问题已解决。
近期热文:
云计算架构师韩先超亲身经历 | 记录从大学到现在工作经历 云计算架构师韩先超对咪咕进行【K8S超大规模集群与AI赋能算力网络调度】培训 对合肥电信进行线下Kubernetes技术培训 推荐书籍:《Kubernetes从入门到DevOps企业应用实战》——韩老师以企业实战为背景出版的一本高质量书籍 招聘:运维、运维开发、DevOps、python、k8s方向 Linux常用命令大全 深度探索:Linux内核优化高级指南 全面掌握:Linux运维面试必备题库(服务器、网络、Docker、K8s、DevOps等) 很多docker镜像站被封了?哪些能用,抓紧收藏 国产操作系统崛起!揭开未来科技的神秘面纱 Centos停更了,基于业务场景选择合适的操作系统替代Centos。 探索Kubernetes/K8S的奇妙世界:十大必知创新技术 大规模场景下K8S集群设计|大企业5000个节点k8s架构设计|第1集 大规模K8S集群的网络与存储优化:5000+节点规模| 第2集 高效运用 GPU:在 Kubernetes 集群中动态管理 GPU 资源 从这几个方面做,可以确保你的Linux 系统更加安全,免受攻击 应对Nginx流量洪峰:优化配置与内核调整,保障服务稳定,应对高并发 超全工具宝藏大揭秘:从IT到AI全覆盖|真的很有用,建议收藏 K8S集群证书过期,一键修复指南 | 干货分享 -
打造高效 Kubernetes 集群:深入解析 K3s 的嵌入式容器镜像共享机制
欢迎关注我的公众号「DevOps和k8s全栈技术」,进公众号【服务】栏,可以啃到技术群,点击即可加入学习交流群。↓↓↓
创作不易,关注,赞,在看,三连支持一波,感谢。↓↓↓
原文作者:DevOps和k8s全栈技术;如有侵权,请联系管理员删除。

最新文章
- 韩先超对兴业数金进行云原生k8s培训总结|干货分享|前沿技术必看
- Java 应用上 Kubernetes 的 20 条生产级必备条件
- Kubernetes 存活探测(Liveness Probe)详解:原理、配置与最佳实践
- 深耕为舟,远志为帆->韩先超2025年终总结
- 生产故障排查记录:Redis 中间件疑难错误排查与修复
- docker镜像加速器又又被封了:新整理一批可以用的|无需代理,国内可访问
- 运维秘籍:20个常识,关键时刻能救命!
- 提升运维效率:Linux和Kubernetes常见故障的20种解决方案
- K8S集群证书过期,一键修复指南 | 干货分享
- 推荐书籍:《Kubernetes从入门到DevOps企业应用实战》——限时优惠倒计时 !
