Cluster Key 专题介绍
Cluster Key 决定了大表中的数据如何在物理层面聚集,也直接影响查询需要扫描多少数据。但从“知道语法”到“真正用对”,中间至少隔着三个问题:它为什么有效、应该怎么选,以及 Databend 的实现有什么特点。本系列共 2 篇:
- 1. 原理篇(本文):从传统 Partition、Micro-partition 和 Block 出发,解释 Min/Max Pruning、数据重叠与 Cluster Key 的工作原理。
- 2. 最佳实践篇:回答列怎么选、复合列顺序怎么排,以及时间字段使用原始值还是 Day、Week、Month 等粒度。进一步解读 Databend Cluster Key 的数据组织、自动聚类、Recluster、观测指标与适用边界。
这个系列的目的是帮助数据工程师建立一套判断方法:什么时候需要 Cluster Key、它为什么能减少扫描、维护成本是否值得,以及如何用指标验证设计是否有效。
导读: Cluster Key 不是 B-tree 索引,也不是给每个字段各建一套独立的访问路径。它通过改善数据的物理局部性,让相近的 Key Values 尽量落入相同或相邻的 Micro-partitions / Blocks,从而缩小每个物理单元的 Min/Max 范围,减少范围重叠,让查询在读取数据前跳过更多不可能命中的物理单元。
为什么理解 Cluster Key,要先理解“数据放在哪里”
很多用户第一次接触 Snowflake 或 Databend 的 Cluster Key,会把它理解成数据库索引,或者简单类比为
ORDER BY。这种解释抓住了“数据会变得更有序”的表面现象,却没有回答最重要的问题:
数据更有序以后,查询为什么会扫描得更少?
答案不在 Cluster Key 本身,而在它背后的完整链路:
数据写入物理单元

  → 引擎记录每个物理单元的列统计信息

  → 查询谓词与统计信息比较

  → 排除不可能命中的物理单元

  → 只读取剩余数据
Cluster Key 的作用,是改善这条链路中的第一步:让相关数据在物理上更集中,使后续的 Data Pruning 更有效。
从这个角度看,可以把 Cluster Key 暂时理解为一种由引擎维护、作用在 Micro-partition / Block 层面的自动、动态 Range Partition。这个类比有助于建立直觉,但它并不意味着 Cluster Key 等同于传统硬分区,后文会专门说明两者的边界。
Snowflake 与 Databend 在 Micro-partition / Block、列统计信息、Pruning 和 Clustering 上可以建立相似的心智模型。但两者的存储格式、后台维护机制和操作接口并不完全相同。
传统 Partition:用户先定义边界,引擎再放置数据
假设有一张持续增长的 LLM Eval 结果表:
CREATE TABLE llm_eval_results (

    created_at
  TIMESTAMP,

    project_id
  VARCHAR,

    eval_run_id
 VARCHAR,

    trace_id
    VARCHAR,

    score
       DOUBLE,

    passed
      BOOLEAN

);
随着评测任务不断运行,这张表可能积累数亿甚至数十亿行数据。传统数仓常按月建立 Range Partition:
2026-07 partition

2026-08 partition

2026-09 partition
在对象存储中,也可能表现为目录边界:
/year=2026/month=07/

/year=2026/month=08/

/year=2026/month=09/
这种分区方式有四个典型特征:
- 1. 分区字段由用户选择;
- 2. 分区边界通常由用户预先定义;
- 3. 每个分区都有明确的逻辑范围;
- 4. 一个分区内部仍然可能包含大量文件、Row Groups 或 Blocks。
查询某一天的数据时:
WHERE created_at
 >=
 '2026-08-01'


  AND created_at
 <
  '2026-08-02'
引擎可以先排除 7 月和 9 月,只访问 8 月分区。这就是传统的 Partition Pruning。
问题在于,Partition Pruning 通常只能把范围缩小到一个较粗的边界。进入 8 月分区后,如果缺少更细粒度的统计信息,引擎仍然可能读取大量数据。因此,粗粒度 Partition 不能替代文件、Row Group 或 Block 级别的 Pruning。
传统分区还需要在粒度之间做取舍:
- • 分区太粗,分区内部扫描量仍然很大;
- • 分区太细,容易产生大量小文件和元数据;
- • 新范围到来时,可能需要继续维护分区边界;
- • 查询模式变化后,原有分区设计未必仍然合适。
Snowflake 和 Databend 采用了另一种思路:用户不必逐个声明大量细粒度分区,引擎会根据数据量、写入批次和存储策略自动形成更小的物理数据单元。
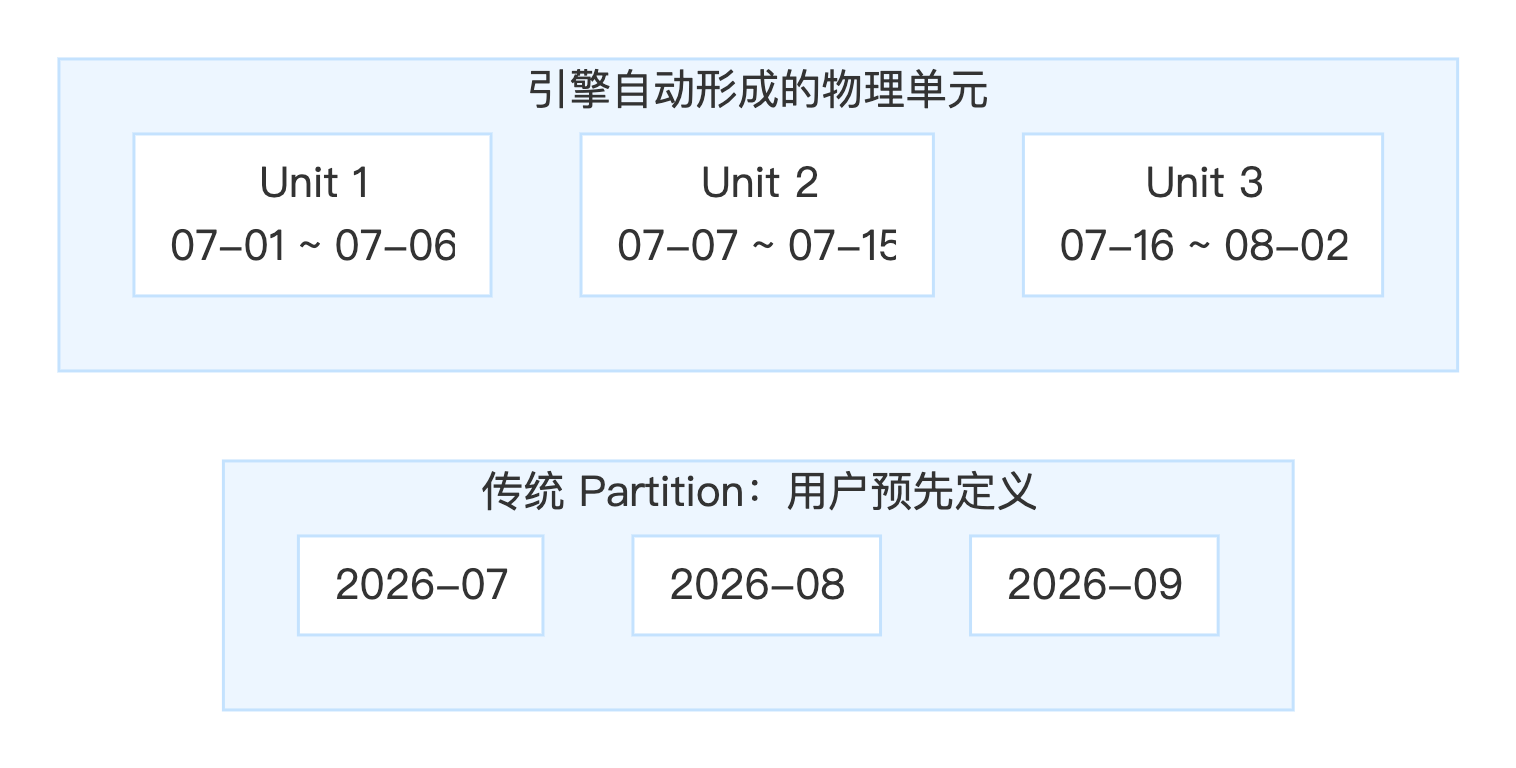
图 1:传统 Partition 使用用户定义的粗粒度边界;Micro-partition / Block 由引擎自动形成,边界可以更细,也不必与自然月严格对齐。
Micro-partition 与 Block:引擎自动形成的物理数据单元
Snowflake 会自动把表数据组织成 Micro-partitions。Databend 的 Fuse Engine 会把数据写入 Blocks,并使用更高一层的 Segments 组织多个 Blocks。
两者内部实现并不相同,但在理解 Cluster Key 时,可以先使用下面这个共同模型:
Table

├── Physical Unit 1

├── Physical Unit 2

├── Physical Unit 3

└── Physical Unit 4
其中:
- • 在 Snowflake 中,Physical Unit 可以理解为 Micro-partition;
- • 在 Databend 中,Physical Unit 可以理解为 Block。
与传统 Partition 相比,关键差异不是名称,而是边界由谁管理:
用户通常不需要逐个定义 Micro-partition 或 Block 的范围。引擎会自动形成这些物理单元,并为它们维护可用于查询裁剪的元数据。
最容易理解的一类元数据,是每一列在物理单元中的最小值和最大值,也就是 Min/Max。
例如,某列的物理分布为:
Block A

created_at: [2026-07-01, 2026-07-07]


Block B

created_at: [2026-07-08, 2026-07-14]


Block C

created_at: [2026-08-01, 2026-08-07]
此时查询:
WHERE created_at
 >=
 '2026-07-10'


  AND created_at
 <
  '2026-07-12'
引擎可以在读取实际列数据之前比较查询范围与 Min/Max:
- • Block A 的最大值早于 7 月 10 日,可以跳过;
- • Block C 的最小值晚于查询范围,可以跳过;
- • Block B 与查询范围相交,可能包含结果,需要读取。
这就是 Min/Max Pruning,也常被称为 Data Skipping。
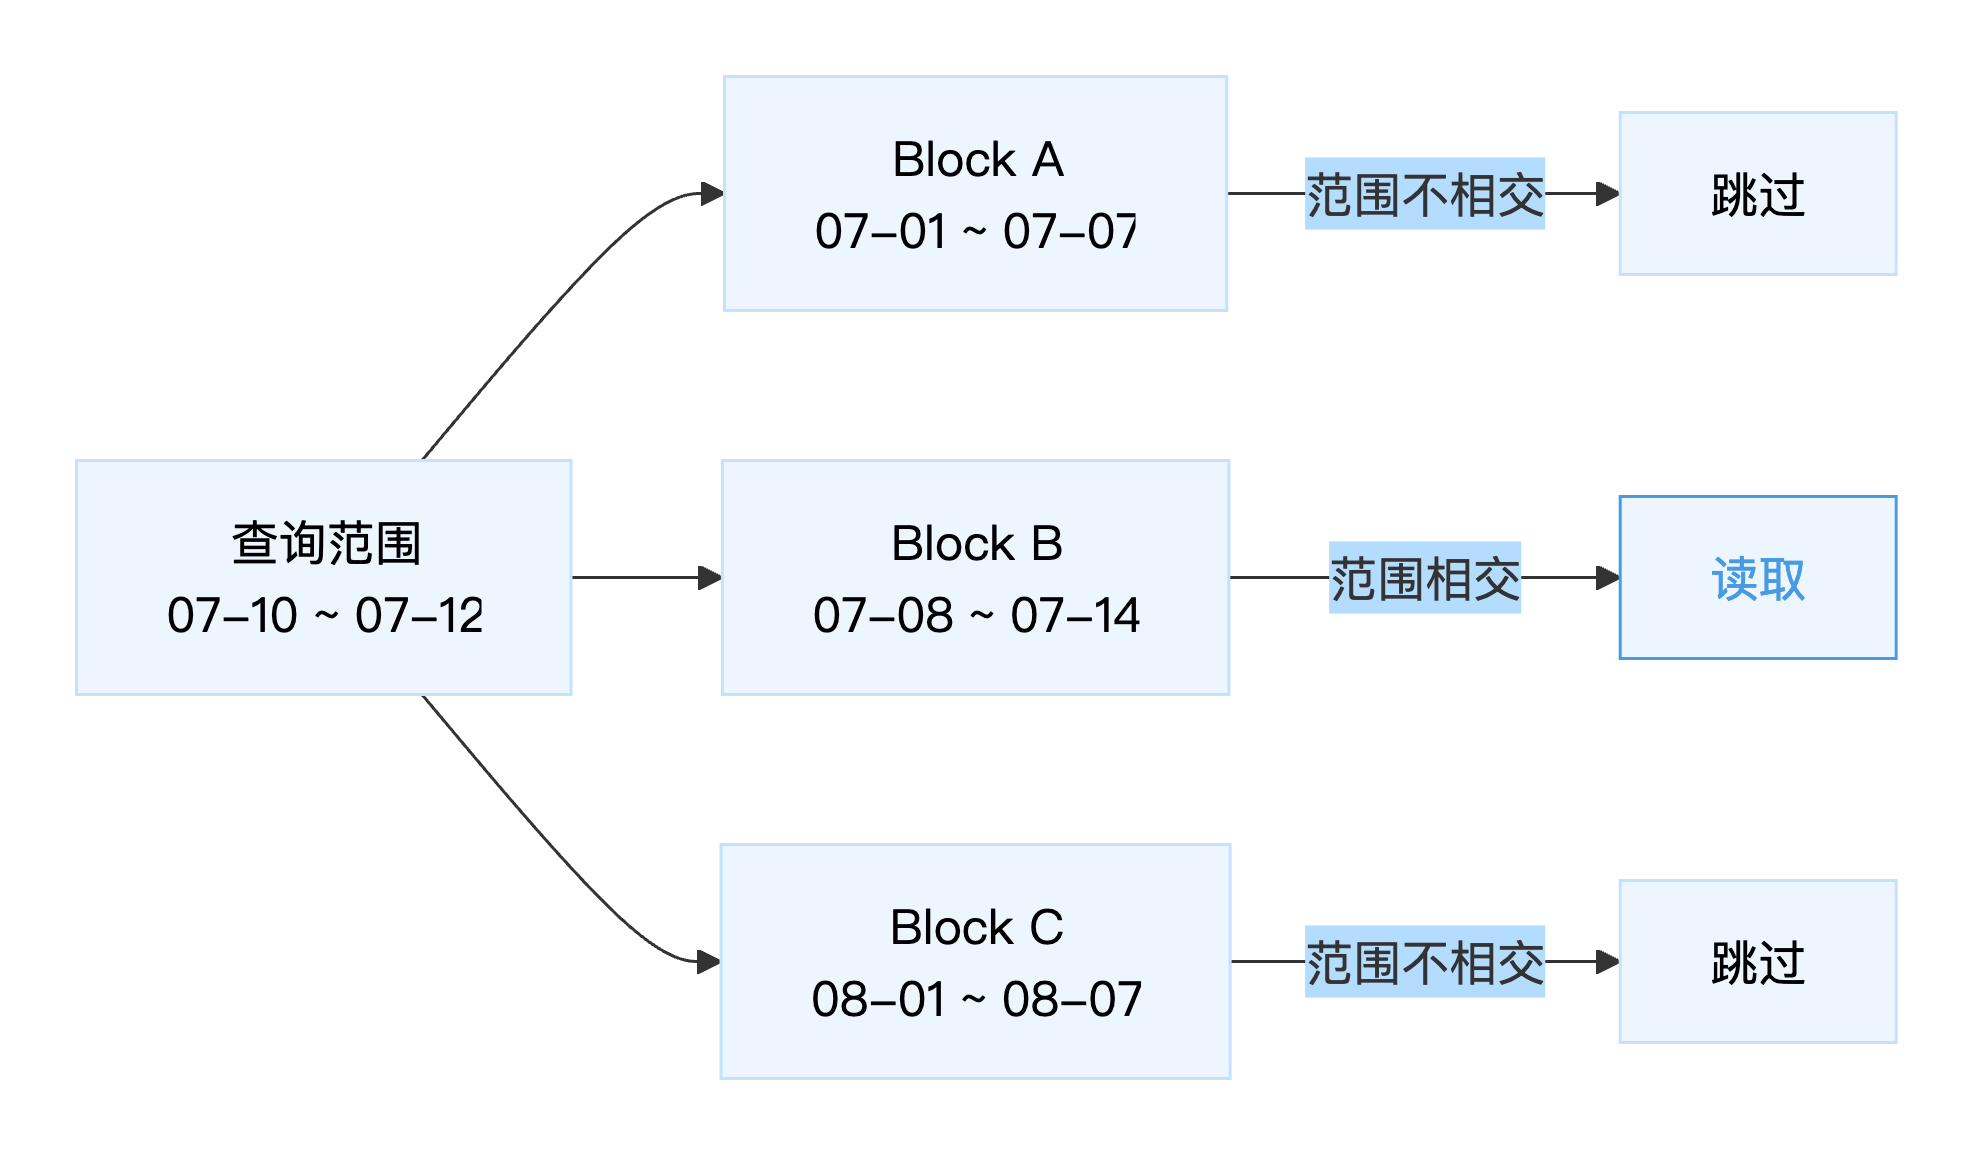
图 2:谓词与物理单元的 Min/Max 不相交时,引擎可以直接跳过;范围相交只表示“可能命中”。
这里有一个非常重要的边界:
Min/Max 只能判断目标值是否一定不在这个物理单元中,不能证明范围内的某个值一定存在。
例如:
Block A trace_id: [trace_0001, trace_9999]
查询:
WHERE trace_id = 'trace_5000'
即使
trace_5000 实际不存在,只要它落在 Min/Max 范围内,引擎就不能仅凭 Min/Max 排除该 Block。Databend 还可以结合 Block-level Bloom Filter 等机制进一步过滤部分等值查询候选,但 Bloom Filter 与 Cluster Key 解决的不是同一个问题:前者判断成员是否可能存在,后者改善数据的整体物理布局。
Pruning 为什么会失效:问题往往出在范围重叠
Min/Max Pruning 的效果,很大程度上取决于同一个物理单元中的数据是否接近,以及不同物理单元的范围是否大量重叠。
数据接近有序时
假设数据按时间接近有序地写入:
Block A: [07-01, 07-07]

Block B: [07-08, 07-14]

Block C: [07-15, 07-21]
查询 7 月 10 日时,只需要读取 Block B。
数据高度乱序时
如果多个任务并发写入,同时不断回灌历史数据,物理布局可能变成:
Block A: [07-01, 07-21]

Block B: [07-02, 07-20]

Block C: [07-03, 07-19]
查询同样的 7 月 10 日,三个 Blocks 都可能包含结果,因此一个也不能排除。
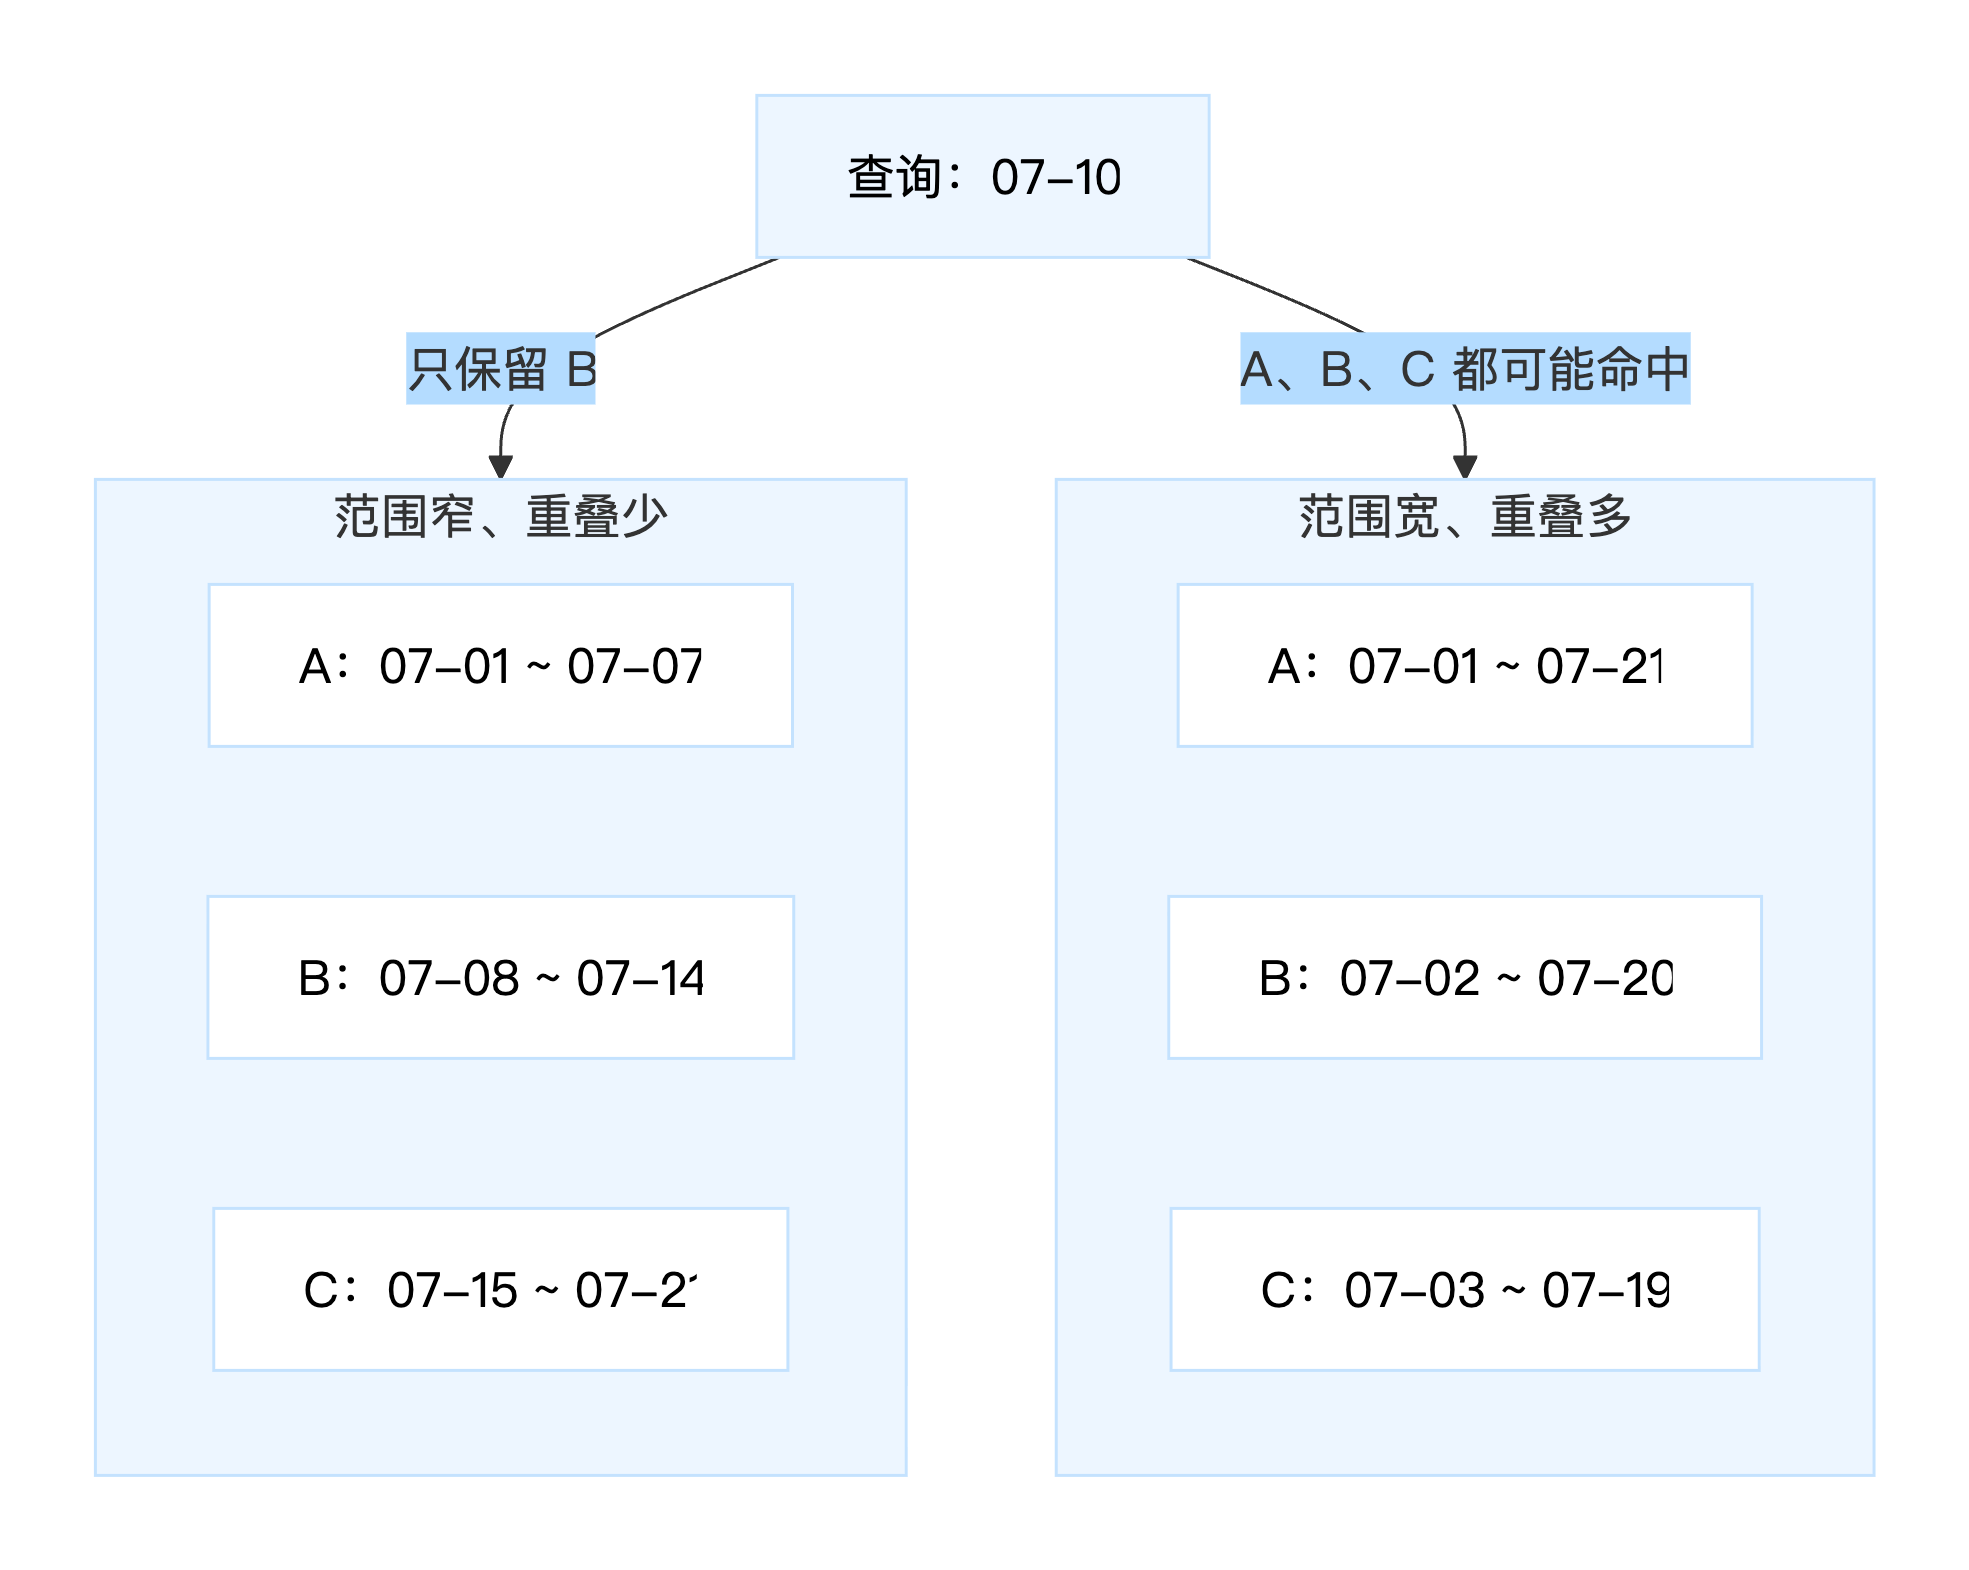
图 3:同一个查询面对不同数据布局时,候选 Blocks 数量可能完全不同。
这说明,Pruning 变差不一定是因为引擎没有 Min/Max,而可能是因为:
- • 单个物理单元的范围太宽;
- • 多个物理单元的范围高度重叠;
- • 同一个 Key Value 同时落入过多候选范围。
Overlap 和 Clustering Depth 正是用于描述这种状态的指标。直观地说,同一个值覆盖的物理范围越多,查询需要保留的候选单元通常越多。Snowflake 可以通过
SYSTEM$CLUSTERING_INFORMATION 观察 Micro-partition 的 Overlap 与 Depth;Databend 的
clustering_information 也会返回 Block 数、Average Overlaps、Average Depth 和深度分布。
Cluster Key 要解决的核心问题,就是降低这种无效重叠。
Cluster Key 到底改变了什么
假设设置:
CLUSTER BY (created_at)
它表达的不是“为
created_at 建立一个传统索引”,而是告诉引擎:希望数据沿
created_at 这个维度改善物理组织,让时间接近的记录尽量进入相同或相邻的物理单元。
理想情况下,布局从:
Block A: [07-01, 07-21]

Block B: [07-02, 07-20]

Block C: [07-03, 07-19]
逐步改善为:
Block A: [07-01, 07-07]

Block B: [07-08, 07-14]

Block C: [07-15, 07-21]
它产生效果的因果链是:
定义 Cluster Key

  → 相近的 Key Values 更集中

  → 每个物理单元的值域更窄

  → 不同物理单元的范围重叠减少

  → Min/Max Pruning 排除更多候选单元

  → 实际扫描的数据量下降
因此,Cluster Key 不是查询结果的直接入口,也不会像 B-tree 一样把查询定位到某个 Row ID。它通过改善数据布局,间接增强已有元数据的裁剪能力。
Reclustering 是维护过程,不是免费收益
持续写入、更新和历史数据回灌会再次打乱物理布局。Reclustering 会选择部分数据重新组织,使其更接近 Cluster Key 所描述的顺序。
这个过程需要排序、读取、重写和存储资源,因此存在明确成本:
- • Snowflake 主要通过 Automatic Clustering 在后台维护聚类,Manual Reclustering 已被标记为 Deprecated。后台维护使用服务端计算资源,并产生相应 Credits 与存储影响。
- • Databend 当前也提供后台自动聚类能力,同时保留显式的
ALTER TABLE ... RECLUSTER,并支持FINAL、WHERE和LIMIT等控制方式。显式 Recluster 同样会消耗时间和计算资源,在 Databend Cloud 中也会产生 Credits。
Reclustering 的目标是改善最混乱的数据范围,而不是保证所有 Micro-partitions / Blocks 最终完全不重叠。是否值得维护,取决于减少的查询扫描成本能否覆盖聚类成本。
为什么可以把 Cluster Key 理解为“动态 Range Partition”
传统 Range Partition 的工作方式是:
用户预先定义范围

  → 2026-07 放入 7 月分区

  → 2026-08 放入 8 月分区

  → 2026-09 放入 9 月分区
Cluster Key 驱动的物理组织更接近:
用户指定聚集维度

  → 引擎按数据量自动形成物理单元

  → 每个物理单元根据实际数据得到 Min/Max 范围

  → 后台维护根据数据变化动态调整布局
例如,按时间聚类后形成的边界可能是:
Block 1: [07-01 00:00, 07-03 15:20]

Block 2: [07-03 15:21, 07-08 09:10]

Block 3: [07-08 09:11, 07-19 18:40]

Block 4: [07-19 18:41, 08-02 11:30]
这些边界不是用户提前写在 DDL 中的,而是由真实数据分布与物理单元大小共同决定。
| 对比项 | 传统 Range Partition | Cluster Key 驱动的物理组织 |
|---|---|---|
| 边界由谁定义 | 用户预先定义 | 引擎根据数据自动形成 |
| 常见粒度 | 较粗的业务范围 | Micro-partition / Block 级别 |
| 边界是否固定 | 相对固定 | 随写入和聚类维护变化 |
| 用户声明什么 | 具体 Partition Range | 聚集列或表达式 |
| 主要价值 | 数据管理、生命周期和粗粒度裁剪 | 改善物理局部性和细粒度裁剪 |
这个类比最有价值的地方,是帮助读者理解“按范围组织数据”。它的边界也必须说清楚:
Cluster Key 可以看作 Micro-partition / Block 层面的自动、动态 Range Partition,但它不是传统硬分区,也不保证每个物理单元严格落在某个业务边界内。
一个必要的复合 Key 示例:month, trace_id 代表什么
本文不展开 Cluster Key 的选列方法,但要正确理解其物理语义,必须先澄清复合 Key 的顺序。
如果查询通常先限定月份,再回查
trace_id,可以考虑:
CLUSTER
 BY (

    DATE_TRUNC(
'month', created_at),

    trace_id

)
可以把这个 Tuple 按字典序理解:
先按 month 组织

  → month 相同或接近时,再按 trace_id 组织
可能形成类似布局:
Block 1: 2026-07 / trace_0001 ... trace_1000

Block 2: 2026-07 / trace_1001 ... trace_2000

Block 3: 2026-07 / trace_2001 ... 2026-08 / trace_0050

Block 4: 2026-08 / trace_0051 ... trace_1100

Block 5: 2026-08 / trace_1101 ... trace_2200
注意 Block 3 仍可能跨月。这再次说明,
month 是主要组织维度,不是“每月一个硬分区”的边界声明。
这种布局适合同时包含月份和
trace_id 的查询:
WHERE created_at
 >=
 '2026-08-01'


  AND created_at
 <
  '2026-09-01'


  AND trace_id
 =
 'trace_1024'
引擎可以先利用月份范围排除大量物理单元,再使用
trace_id 的统计信息继续缩小候选范围。
但如果查询只有:
WHERE trace_id = 'trace_1024'
同一个
trace_id 可能出现在不同月份,引擎仍可能检查多个时间范围。
因此:
CLUSTER BY (month, trace_id)不等于同时拥有一套独立的 Month 索引和一套独立的trace_id索引。前导表达式决定主要物理顺序,后续表达式主要在前导值相同或接近的范围内发挥作用。
至于哪些列应该放在前面、时间应该保留原始 Timestamp 还是降低到 Day / Week / Month,以及高基数
trace_id 是否值得加入,将在本系列第二篇集中讨论。
Snowflake 与 Databend:相似的思想,不同的产品边界
Snowflake 和 Databend 都通过自动形成的细粒度物理单元、列统计信息和聚类布局减少扫描。对用户来说,两者可以共享“改善物理局部性以增强 Pruning”这一核心心智模型。
但在产品能力与使用方式上,仍有几处值得区分。
| 维度 | Snowflake | Databend |
|---|---|---|
| 基础物理单元 | Micro-partition | Fuse Block,多个 Blocks 由 Segment 组织 |
| Cluster Key 的核心作用 | 将相关记录共同组织到更合适的 Micro-partitions | 按列或表达式改善 Blocks 的物理组织 |
| 默认维护方式 | Automatic Clustering 后台评估并维护;Manual Reclustering 已 Deprecated | 提供后台自动聚类,同时保留显式
RECLUSTER 控制 |
| 显式维护能力 | 可暂停或恢复 Automatic Clustering,主要由服务管理资源 |
RECLUSTER 支持
FINAL、
WHERE、
LIMIT,可控制维护范围与深度 |
| 聚类观测 |
SYSTEM$CLUSTERING_INFORMATION 等系统函数 |
clustering_information 返回 Block Count、Overlap、Depth 等指标 |
| 主要用户心智 | 声明聚集维度,由托管服务维护,并关注 Credits 与存储影响 | 声明聚集维度,可依赖自动维护,也可查看 Block 级指标并显式调优 |
Snowflake:强调托管式的自动维护
Snowflake 默认自动创建 Micro-partitions,并维护其列级元数据。对于非常大的表,如果自然写入顺序无法满足主要查询路径,用户可以定义 Clustering Key,之后主要由 Automatic Clustering 评估并执行维护。
这种产品体验的重点是“声明目标,平台维护”。用户不需要指定执行 Reclustering 的 Warehouse,但仍然需要评估 Automatic Clustering 带来的 Credits 和存储成本。Snowflake 官方也明确指出,Clustering Key 并不适合所有表,通常更适用于具有大量 Micro-partitions、查询足够有选择性且访问模式较稳定的大表。
Databend:自动维护之外,保留更直接的物理调优入口
Databend 使用 Fuse Blocks 和 Segments 组织对象存储上的数据。定义 Cluster Key 后,系统可以在后台持续维护数据布局;与此同时,Databend 仍向用户开放
RECLUSTER 命令和
clustering_information 指标。
这使 Databend 的用户心智同时包含两层:
- 1. 声明式使用:定义 Cluster Key,让系统持续改善物理布局;
- 2. 可观察、可干预:通过 Block Count、Overlap 和 Depth 判断聚类质量,并在需要时显式控制 Recluster 范围。
这不是“自动”与“手动”的简单二选一,而是产品边界不同:Snowflake 更强调由托管服务接管维护;Databend 在提供自动聚类的同时,保留了更直接的 SQL 控制面。对数据工程团队而言,后者便于把聚类维护纳入批处理窗口或特定数据范围,但也要求团队理解显式操作的资源与写入影响。
不要把 Cluster Key 当作通用加速开关
无论使用 Snowflake 还是 Databend,Cluster Key 都不应该默认加到每一张表上。它更适合满足以下条件的场景:
- • 表已经足够大,查询确实扫描了大量物理单元;
- • 主要查询包含稳定且有选择性的过滤条件;
- • 多数高价值查询可以从同一组聚集维度获益;
- • 查询节省能够覆盖持续写入和 Reclustering 的维护成本。
对于小表、查询模式高度随机的表,或者自然写入顺序已经与主要过滤维度一致的表,增加 Cluster Key 可能收益有限,甚至只增加维护成本。
建立正确心智:Cluster Key 优化的是扫描路径,不是 SQL 语法
现在可以把 Partition、Micro-partition、Block、Pruning 和 Cluster Key 串成一条完整链路:
传统 Partition

  → 用户定义粗粒度硬边界


Snowflake Micro-partition / Databend Block

  → 引擎自动形成细粒度物理单元


Min/Max Metadata

  → 描述每个物理单元可能覆盖的值域


Pruning

  → 排除不可能命中谓词的物理单元


Cluster Key

  → 改善数据的物理局部性

  → 缩小单元值域并减少范围重叠

  → 让 Pruning 跳过更多数据


Reclustering

  → 在持续写入后维护这种布局

  → 以额外计算和存储成本换取扫描收益
对新用户来说,最重要的认识不是记住某个 DDL,而是把 Cluster Key 看成一项物理布局选择。任何布局都会偏向一类查询,也必然对其他查询做出取舍。
下一步才是实践问题:
- • 哪些列最常出现在有选择性的过滤条件中?
- • 复合 Cluster Key 的列顺序应该怎么排?
- • 时间字段应该保留原始 Timestamp,还是按 Day、Week、Month 降低粒度?
- •
trace_id、eval_run_id这类高基数字段是否适合作为 Cluster Key? - • Boolean、Status 等低基数字段为什么可能没有效果?
- • 自然写入顺序已经接近有序时,还有没有必要聚类?
- • 如何通过扫描比例、Overlap 和 Depth 验证 Cluster Key 是否真正有效?
这些问题将在本系列第二篇《Cluster Key 最佳实践:列怎么选、顺序怎么排,粒度多大才合适?》中展开。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70042558/viewspace-3180345/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 同样 PASS,路径为何不同|用 Jev 逐 Span 评估 Agent Trace
- Jev 爆火之后,我们把它集成进了数据湖仓
- Databend 原生数据血缘:追溯指标来源,检查变更影响
- 只看 PASS 会骗你,6 条 Agent Trace 里的 Coding Agent 评测真相
- AI 时代的数据工程挑战:从复杂链路走向统一数据底座
- Databend 增量物化视图:基于 Change Tracking 的增量刷新与一致性读取
- Cluster Key 最佳实践:列怎么选、顺序怎么排与粒度设计
- 从 Kafka 到 Databend Cloud:万亿级 Agent Trace 接入链路的工程实践
- Databend Cloud 助力头部 AI 企业构建全链路 Trace 管道
- Databend 产品更新:从 Spatial Index Join 到 Eval 数据管道
