摘要:我让
gpt-6-astra和claude-fable-5.1分别在 Evot、Pi、DeepSeek Harness 上修复 serde_json 的同一个 JSON 解析 Bug。六次运行都通过了完整测试,核心补丁逐字节相同。只看 PASS 率,六次没有区别。Trace 记录了另一组数据。GPT-6-Astra 平均请求模型 9 次,耗时 52.0 秒。Claude-Fable-5.1 平均请求 13 次,耗时 118.6 秒,输出 token 是前者的 9.6 倍。六次运行还撞上了同一个环境问题。Claude 在 Pi 上为此多花 3 个回合,在 DSH 上触发上下文压缩,最终答复也被完整生成了两遍。这些情况都不会出现在最终 diff 里。
本文只讨论这六条真实 Session 里的工程行为,不给两个模型做通用排名。就这次实验而言,最终 diff 提供的信息最少。
GPT-6-Astra 发布那阵子,Benchmark 和代码能力数据刷得很凶。我真正想看的却很具体。把它放进一条真实的 Coding Agent 工作流,和我平时用得最多的 Claude-Fable-5.1 跑同一个任务,谁更稳,谁花的钱少,用起来又有什么差别。
排行榜回答不了这个问题,我就自己跑了一轮。
这次选了三个设计思路不同的 Coding Agent,分别是 Evot、Pi 和 DeepSeek Harness。两个模型各跑三个框架,任务统一为修复 serde-rs/json issue #979。六次 Session 结束后,我把里面的模型请求、工具调用和验证过程逐条对了一遍。
先交代三个 Agent 的基本情况。
- •
Evot 是开源终端 Coding Agent。它尽量少在模型外面增加干预,系统上下文约 1K token,默认提供
read、bash、edit、write四个核心工具。长任务里的上下文消耗和工具调用次数,都是它重点控制的对象。 - • Pi Coding Agent 也是轻量终端 Harness,默认工具集与 Evot 接近。开发者可以通过 TypeScript 扩展、skills、prompt 模板和 packages 自己拼工作流。Pi 没有预设一套最佳流程。
- • DeepSeek Harness 简称 DSH,采用 “Everything is a plugin” 的设计。模型适配器和工具可以替换,会话、沙箱、存储以及 Agent 循环也都能换。它让我们看到插件化、事件驱动的 Harness 会怎样影响模型的上下文管理。
三个 Harness,两个模型,同一个 Bug。补丁虽然相同,过程差得很明显。
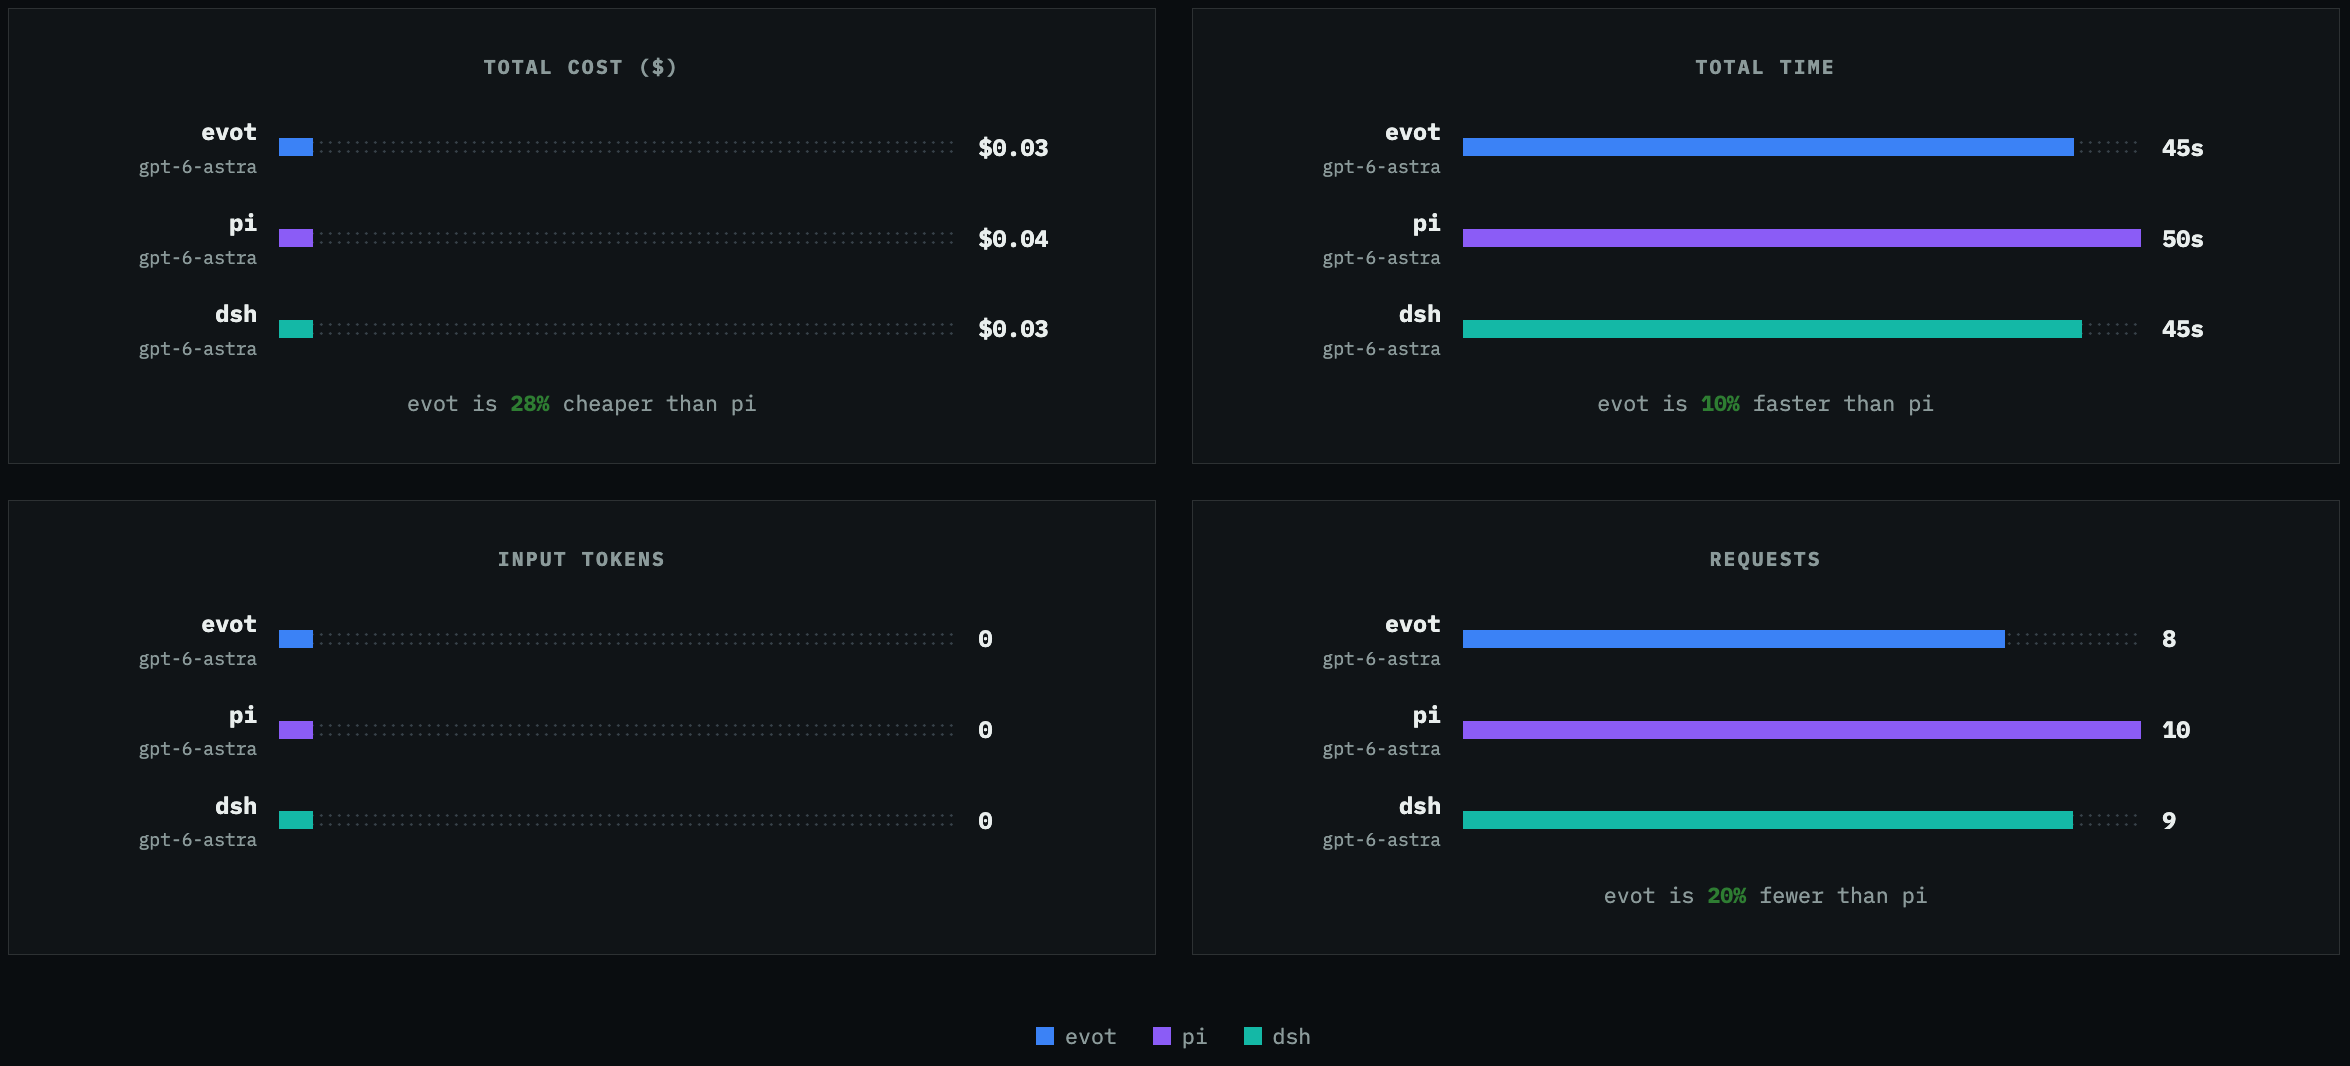
图 1
gpt-6-astra在三个 Agent 上的指标概览
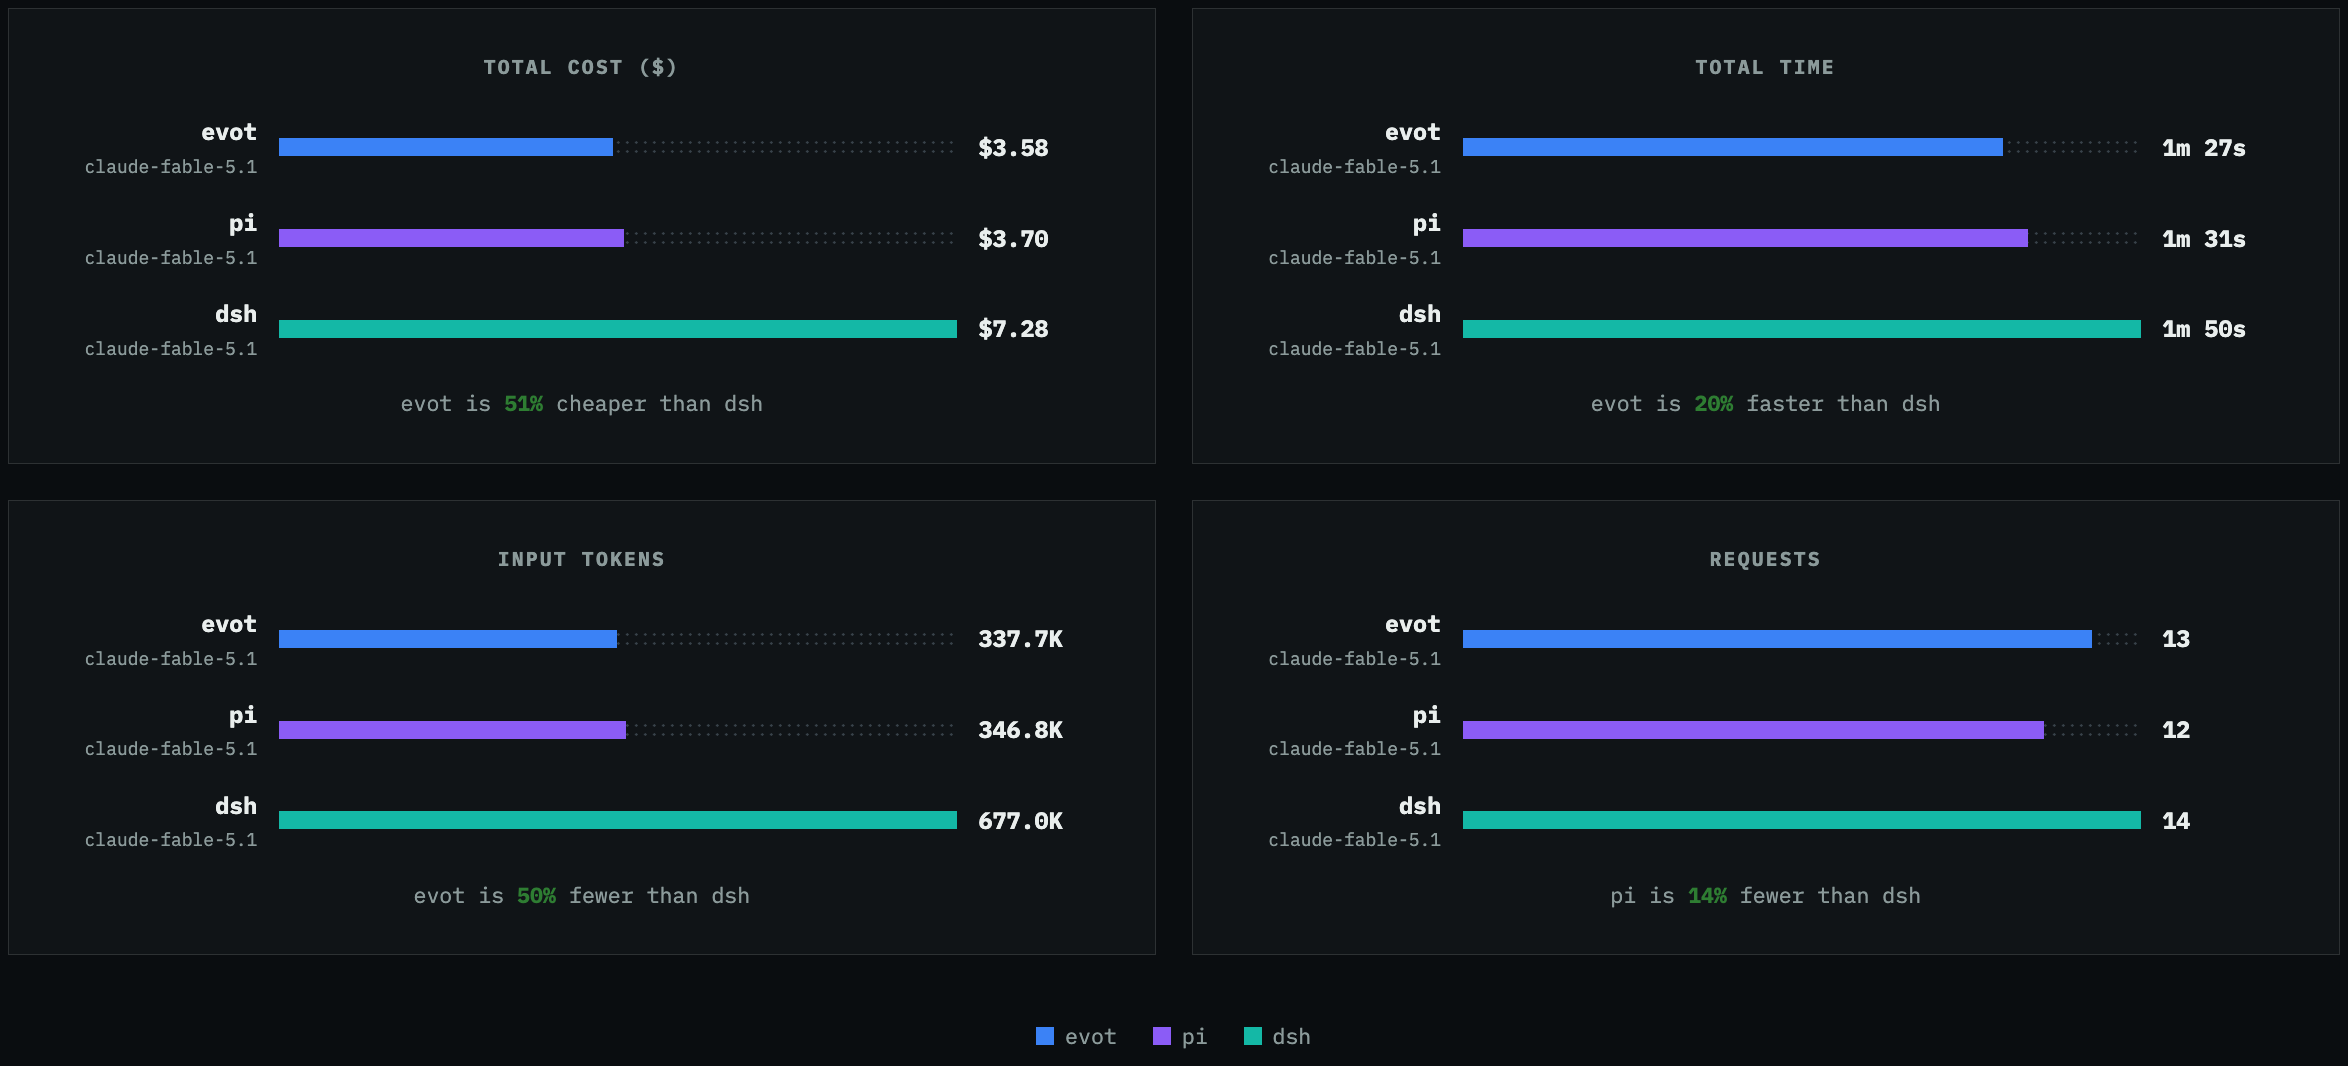
图 2
claude-fable-5.1在三个 Agent 上的指标概览
六次运行拿到了相同补丁,成本差得很远
六次运行全部通过完整测试,核心补丁逐字节相同。
| 指标(三个 Harness 均值) | GPT-6-Astra | Claude-Fable-5.1 | 倍数 |
|---|---|---|---|
| 模型请求数 | 9 | 13 | 1.44× |
| 输出 token | 653 | 6,286 | 9.62× |
| 完成时间 | 52.0 s | 118.6 s | 2.28× |
修的是同一个 Bug,最后也都修对了。Claude 多用了 44% 的模型回合,输出 token 多出 9.6 倍,耗时多出 2.3 倍。
这组数字有一个前提。任务提示已经指出根因位置和修复方向,还明确写了“先 peek 下一个非空白字节再分支”。六个 Agent 最终写出相同补丁很正常。提示已经把修复方案说得很近时,PASS 率和补丁一致性很难再区分模型,Session 里的执行过程更有参考价值。
评测全程离线,也裁掉了仓库里的现成答案
模型得到修复方案有几条路。它可以读代码和失败测试,也可能去外网查资料,或者从 Git 历史里找到官方补丁。后两条路在这次评测里被封住了。
Agent 执行阶段没有外网。容器启动时会写入出站网络规则,只放行 loopback、已经建立的连接以及容器里的 LLM 代理进程。其他出站连接一律拒绝。规则生效后,进程的
NET_ADMIN 和
NET_RAW 能力会被移除。Agent 即使以 root 身份运行,也改不了网络规则。
Git 历史也做过裁剪。
serde-rs/json issue #979 的官方修复位于本次锁定的 commit 之后。完整历史里,一条
git log --all 就可能把补丁翻出来。准备阶段会删掉全部 tag、remote 和分支,清空 reflog,执行 gc,最后检查基准 commit 之后还有没有可达提交。检查失败,整次运行不会开始。
验证阶段也保持离线。只有拉取依赖的准备阶段允许联网,依赖会在 Agent 启动前准备好。
这些约束把信息来源收得很窄。模型只能读当前代码和那条失败的回归测试,再完成修复。
正确性打平以后,成本数据开始有用
| 模型 | Harness | 请求数 | 输出 token | 完成时间 | 模型延迟 | 工具时间 |
|---|---|---|---|---|---|---|
| GPT-6-Astra | Evot | 8 | 532 | 50.5 s | 45.4 s | 5.1 s |
| GPT-6-Astra | Pi | 10 | 737 | 55.4 s | 50.3 s | 5.0 s |
| GPT-6-Astra | DSH | 9 | 691 | 50.2 s | 46.0 s | 4.2 s |
| Claude-Fable-5.1 | Evot | 13 | 4,086 | 94.0 s | 87.7 s | 6.3 s |
| Claude-Fable-5.1 | Pi | 12 | 4,652 | 135.4 s | 91.8 s | 43.6 s |
| Claude-Fable-5.1 | DSH | 14 | 10,120 | 126.5 s | 110.1 s | 16.4 s |
三个 Harness 给出的方向一致。Claude 在每组配对里都请求了更多次模型。
先看稳定性。GPT 的三条 Session 落在 50.2 到 55.4 秒之间,只差 5.2 秒。Claude 的范围是 94.0 到 135.4 秒,首尾差了 41.4 秒。如果这类任务要进生产环境,Claude 的排期和超时配置得给波动留出更多空间。
再看最慢的那条。Claude 在 Pi 上总耗时 135.4 秒,模型延迟为 91.8 秒,反倒低于它在 DSH 上的 110.1 秒。剩下 43.6 秒花在工具执行上,占总时长 32%,基本可以判断是在等编译。只看完成时间,很容易把锅扣给模型。拆成模型延迟和工具时间后,问题落到了工具链。
DSH 里的差距最大,其中有一部分也来自框架。后面看 Trace 会更清楚。
汇总表漏掉的三处差异
六次运行都先撞了一次
rg
GPT-6-Astra 在 Evot 上执行的第一条命令是用
rg 搜索源码。终端返回
command not found。它在下一个回合换成
grep,工作才继续。
六条 Session 都出现了这次失败,GPT 三次,Claude 三次。
Evot 和 Pi 的系统提示会建议模型用 bash 操作文件,并把
ls、
rg、
find 当作例子。评测镜像没有安装 ripgrep。Harness 告诉模型工具可用,运行环境却给不出来,于是每条 Session 都白花一个回合。
这件事和离线模式无关。基础镜像的安装清单本来就没有 ripgrep。离线只限制网络,管不到本地有没有命令。
最终 diff 看不见这次失败,PASS 率也不会受影响。批量跑任务时,每条任务固定多一次无效调用,账单里却会一直累加。
Claude 在 Pi 上有三个回合没推进任务
Claude 在 Pi 上的前四个回合很有代表性。
第一步,它调用
Read 读取测试文件。第二步,它调用
Bash 搜索源码。两次都失败了,因为 Pi 不接受首字母大写的工具名,也就是
Read、
Bash 和
Edit 这套写法。第三步改用小写,文件读到了。第四步使用
rg,又撞上 ripgrep 缺失。直到第五步换成
grep,它才继续定位代码。
前四步有三步没有推进任务。整条 Session 一共 12 个回合,工具摩擦用掉 3 个,占 25%。
Evot 接受大写工具名。Claude 在 Evot 上第一次调用
Read 就成功了。同一个模型带着同样的调用习惯,换个 Harness 就会多花两个回合。框架的兼容性会直接改变执行成本。
Claude 在 Evot 上也有一点额外开销。13 个回合里,它两次连续读取同一个文件,工具两次都返回“文件未变化”。问题不算大,汇总数据仍然不会告诉你这件事。
Claude 在 DSH 上有 60% 的输出没有推进任务
Claude 在 DSH 上共运行 14 个回合。其中一次由 Harness 用来生成会话标题,10 次用于修复任务。剩下三次发生在任务尾部,最终答复因此生成了两遍。
- • 第 11 步生成最终答复,输出 4,070 个 token。
- • 第 12 步触发上下文压缩,输出 1,980 个 token,耗时 25.7 秒。这是六条 Session 中最慢的一次模型调用。
- • 第 13 步重新生成同一份最终答复,再次输出 4,070 个 token。
整条 Session 输出 10,120 个 token。重复答复用了 4,070 个,压缩又用了 1,980 个,合计 6,050 个,占 60%。这些 token 没有给任务增加任何结果。
如果只拿汇总数据做判断,很容易得出 Claude 输出太长的结论。Trace 把来源拆开了。6,050 个 token 来自 Harness 的上下文管理,不该全部算成模型能力或工程习惯的结果。模型成本和框架附加成本要分开统计。
GPT 在 DSH 上也请求过一次会话标题,没有触发压缩。相同 Harness 只压缩了 Claude 的 Session。上下文长度可能刚好越过阈值,Claude 的输出习惯也可能让上下文增长得更快。现有数据无法确定原因,但可以确认压缩成本会随模型行为变化。
我读 Agent Trace 时会固定看五个位置
前面几处差异来自同一份观察清单。我们检查六条 Trace 时逐项对过,换成其他 Agent 评测也可以继续用。
| # | 观察点 | 要回答的问题 |
|---|---|---|
| 1 | 定位路径 | 从问题到根因走了几步?是直接命中还是逐层缩小? |
| 2 | 上下文读取量 | 修改前读了多少代码?有没有重复读同一个文件? |
| 3 | 验证范围 | 只跑新增回归测试,还是跑完整测试套件? |
| 4 | 工具错误与重试 | 有没有工具失败、工具名不匹配、重复调用? |
| 5 | 报告与实测是否一致 | 最终报告写的,和 Trace 里实际发生的,对得上吗? |
第 4 项很容易漏。六条 Trace 都遇到过工具失败,最后却全部 PASS。它和代码里的 warning 有点像,不会阻止编译通过,留着不管迟早会付出成本。
第 5 项决定最终答复能不能充当审查记录。我们把六条 Session 的验证命令重新核了一遍,六次都确实运行了完整测试,报告也和实测一致。两个模型在这里都没有含糊。
GPT-6-Astra 沿着根因很快收敛
GPT-6-Astra 在三个 Harness 上的路径几乎一样。它先找到目标函数,读取两个文件,接着修改代码,运行完整测试,最后检查 diff。没有重复读取,也没有额外构造测试矩阵。
它的最终报告只有 77 到 101 个 token,写了修改位置、四类输入的行为和测试结果。报告内容和 Trace 对得上。
放回那五个观察点里看,GPT 直接命中根因,读取的上下文较少,验证范围覆盖完整的
cargo test。工具错误只有一次
rg 失败,三个 Harness 上的工具调用数分别是 7、9、7 次。
这份 Trace 能支持的判断很有限。GPT 在这次任务里用了较少的模型回合,把定位、修改和验证做完了。它没有绕路,确认动作也很少。
我第一次看到这条执行路径时,多少有点担心它太莽。补丁质量和测试覆盖又确实没出问题。这次任务里,它很快找到修复点,跑完测试,检查完 diff 就停了。
Claude-Fable-5.1 更接近一次保守的代码审查
Claude-Fable-5.1 写出的实现和 GPT 相同。三条 Trace 里,它在动代码之前都花了更多精力检查兼容性。
在 Evot 上,Claude 额外搜索了已有的错误测试。最终说明还专门解释了
MapKey 为什么不能直接复用。
MapKey 会处理从带引号字符串中解析数字等额外行为,直接换过去可能改变 enum variant 的现有语义。它对 API 兼容性的顾虑写得很清楚。
Pi 上的验证范围最完整。Claude 跑完完整测试,又临时创建一个测试文件,用它检查非法数组 key 和非法数字 key。空对象、截断输入也跑了,随后又检查正常字符串和带空白输入。验证结束后,它删掉了临时文件。
DSH 上的上下文压缩和重复答复已经在前面拆过。这部分主要来自框架行为,和 Claude 的工程风格关系不大。
解析器、安全边界或兼容性敏感的代码,往往值得这样多查几遍。如果同样的改动落在金融系统的序列化逻辑里,我会倾向于让 Claude 做这类检查。
成本也很直接。它读了更多源码,解释更长,请求模型的回合更多。Pi 上还有 3 个回合花在工具摩擦上。修掉 Harness 的兼容性问题,Claude 的耗时应该还会下降。
Harness 会放大模型原有的行为
工具兼容性先带来了可见的摩擦。大写工具名在 Evot 上能用,在 Pi 和 DSH 上不能用。同一个模型来到 Pi 后,需要用两个回合试出正确写法,Evot 没有这笔成本。这属于框架实现差异。
上下文管理影响任务尾部。DSH 在 Claude 的 Session 上触发压缩,又生成了一次答复,额外增加 6,050 个 token。模型并没有靠这些 token 做更多工程工作。
工具能力还会限制验证范围能走多远。Pi 没有阻止 Claude 扩大测试范围。不过这里只有一条 Session,暂时无法把这件事归因给 Pi 的设计。
实验边界也得写清楚。两批运行不在同一天,期间三个 Harness 的版本各有变化。每个“模型 × Harness”组合只跑了一次,样本量无法描述方差。本文不会做严格的模型归因。DSH 上的差距最大,Evot 上最接近,这些现象适合留给后续实验继续验证。
同一平台已经积累了 50 条这个任务的 Session,涉及 14 个模型和 4 种 Harness,共有 17 次 run。横向对比后,没有哪个 Harness 能在所有模型上稳定省钱。单条对比远远不够,评测得按多个维度一起看。
自己做 Agent 评测时,我会守住这几条
跑完六条 Session 后,我改了自己的评测习惯。
- 1. 同任务、同版本、同一天运行。 模型版本会变,Harness 和依赖也会变。时间一旦错开,可比性很快就没了。
- 2. 把“不能抄”写进环境约束。 我会断掉出站网络,裁掉含有答案的仓库历史,再检查裁剪结果。缺少这些限制,实验可能测到搜索能力。Benchmark 里的高分也可能来自训练数据中见过相似题目。
- 3. 每个组合至少跑 3 次,并报告分布。 一次运行无法说明稳定性。这次每个组合只跑了一次,我只讨论六条 Session 发生过什么,不拿它们证明模型 A 普遍强于模型 B。
- 4. 先查 token 上报口径,再算成本。 这次有一个模型把输入全部报成 0,另一个模型把中间请求的输出全部报成 0。口径没核对,成本计算一定会错。
- 5. 完成时间要拆成模型延迟和工具时间。 编译等待很容易被算到模型头上。两个指标拆开,定位才准。
- 6. 完整 Trace 要留下。 最终 diff 里没有上下文压缩,也看不到重复答复和工具名不匹配。diff 能说明改了什么,Trace 能还原它怎么改。工程决策经常更关心后一个问题。
- 7. 不同任务类型分开统计。 小补丁和跨模块重构会让模型表现出不同习惯。这次实验只覆盖一个小修复,换成大型重构,结论可能会变。
Agent Trace 也会变成数据工程问题
前面的结论都需要从日志里算出来。
我们先把 6 条 Session 按模型、Harness 和版本分组。为了弄清 1,980 个 token 花在哪里,还得从会话汇总下钻到第 12 个 span。两个 span 的输出数完全相同,最终答复的重复生成才被确认。最后再匹配 50 条 Session 里的全部工具调用,
rg 缺失六次全中的情况才露出来。
眼下的数据集很小。50 条 Session,14 个模型,4 种 Harness,全部加起来不到 1 GB。几份 JSON 文件和一段脚本已经够用。 Trace.evot.ai 在这里主要提供一个方便对照的界面。
真实 Agent 产品每天产生的 Trace 会多很多。评测仓库里,一条 Coding Session 的中位存储量为 5.7 MB,最大 32 MB。里面保存每次模型请求的完整输入输出、工具调用和返回值,也保留原始流式响应。一条 Session 通常有几十次请求,最长的一条达到 86 次。
这些样本来自补丁型任务,一次运行十几个到几十个 span 就结束。重构和跨模块调试会跑得更久,多轮需求澄清也一样。span 数量可能来到几百甚至上千,上下文持续累积,单条 Session 会占更多空间。下面的估算只能当下限看。
每天 1,000 条 Session 大约产生 8 GB,每天 10,000 条接近 80 GB,一年约 30 TB。数据存下来以后,还得支持几类查询。
- • 按模型、Agent 版本和任务类型聚合成功率与成本。
- • 从会话汇总定位到某一次工具调用。
- • 跨 Session 搜索“工具名不匹配”和“重复调用”等模式。
- • 保留完整原始上下文,方便回放和复核。
这类工作会落到大表扫描和半结构化 JSON 分析上。数据维度的基数高,表也很宽,点查和扫描会混在一起。50 条记录用脚本就能处理,每天上万条时,存储费用和查询延迟都会上来,维护也会变麻烦。此时需要能直接处理半结构化数据、支持多维聚合和层级下钻的存储与计算系统。
Databend Cloud 处理的正是这类场景。原始事件放在对象存储里,可以用 SQL 直接查询 JSON。聚合和下钻无需额外搭建预处理链路。数据量只有几百 MB 时,现成脚本和文件更合适。这次评测就属于后者。
Coding Agent 的差异留在了执行轨迹里
FixJsonParsingBug 任务的正确性结果打平了。两个模型找到同一个根因,提交相同补丁,也都通过完整测试。
执行过程仍然不同。GPT-6-Astra 请求模型的次数更少,输出更短,完成得也更快。Claude-Fable-5.1 多读了一些源码,补了边界测试,还解释了兼容性风险,整个过程更像一次谨慎的代码审查。Harness 的工具兼容性与上下文管理会继续改变这些成本。
这次评测之后,我再看到一个漂亮的 Benchmark 分数,会先去找对应的 Trace。没有 Trace,很多工程问题根本不会出现在结果表里。
只看 PASS,六次运行没有区别。把完整轨迹展开,六种工程过程才看得见,模型和 Harness 怎样互相影响也会变得具体。
原始 Trace 与复现信息
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70042558/viewspace-3182128/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 同样 PASS,路径为何不同|用 Jev 逐 Span 评估 Agent Trace
- Jev 爆火之后,我们把它集成进了数据湖仓
- Databend 原生数据血缘:追溯指标来源,检查变更影响
- AI 时代的数据工程挑战:从复杂链路走向统一数据底座
- Databend 增量物化视图:基于 Change Tracking 的增量刷新与一致性读取
- Cluster Key 最佳实践:列怎么选、顺序怎么排与粒度设计
- 从传统分区到微分区,Snowflake 与 Databend 如何减少数据扫描
- 从 Kafka 到 Databend Cloud:万亿级 Agent Trace 接入链路的工程实践
- Databend Cloud 助力头部 AI 企业构建全链路 Trace 管道
- Databend 产品更新:从 Spatial Index Join 到 Eval 数据管道
